
遇见数据集

github_fetch_huggingface_terminal_9127_a9k2d4_derived_emotion_classifier

收藏
Hugging Face2026-08-24 更新2026-08-25 收录
官方服务:

资源简介:

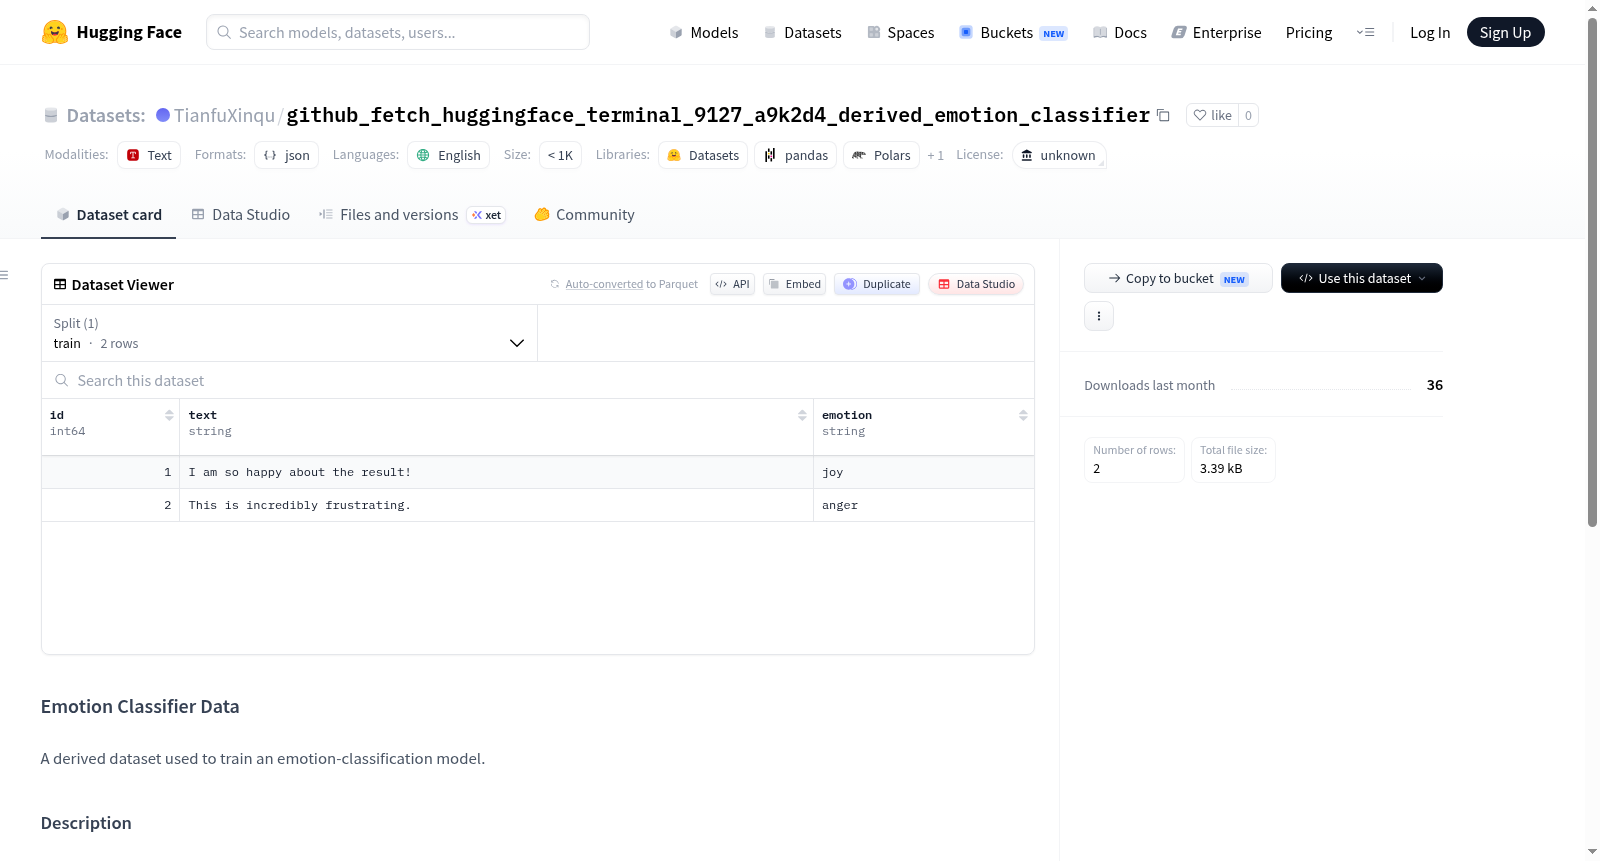
该数据集是一个用于训练情感分类模型的派生数据集,通过合并并清洗来自两个上游来源(Wiki Factoid 问答数据集和 Twitter 情感数据集)的样本,并重新标注情感标签,最终得到 8000 条标注记录。数据集的标签涵盖五种情感类别:愤怒、喜悦、悲伤、恐惧、惊讶。该数据集适用于情感分类任务。

This dataset is a derived dataset for training sentiment classification models. It is created by merging and cleaning samples from two upstream sources (Wiki Factoid QA dataset and Twitter sentiment dataset), re-labeling the sentiment labels, resulting in 8000 annotated records. The dataset covers five emotion categories: anger, joy, sadness, fear, and surprise. It is suitable for sentiment classification tasks.

创建时间:
2026-08-11
原始信息汇总

数据集概述:Emotion Classifier Data

该数据集是一个派生数据集,专门用于训练情感分类模型。

核心信息

  • 数据集名称:Emotion Classifier Data
  • 许可证:未知(待定)—— 当前复用条款仍在审核中,暂未明确
  • 语言:英语(en)

数据规模与标签

  • 总记录数:8,000 条已标注样本
  • 情感类别:愤怒(anger)、喜悦(joy)、悲伤(sadness)、恐惧(fear)、惊讶(surprise)

数据来源与衍生路径

该数据集由以下两个上游来源数据集经过清洗和重新标注后整合而成:

  1. TianfuXinqu/github_fetch_huggingface_terminal_9080_m7k2p9_upstream_wiki_factoid
    — 维基百科事实类问答数据

  2. TianfuXinqu/github_fetch_huggingface_terminal_9080_m7k2p9_upstream_twitter_sentiment
    — 推特情感分析数据

用途

该数据集主要用于训练情感分类模型,覆盖上述五种基本情感类别。
搜集汇总
数据集介绍
github_fetch_huggingface_terminal_9127_a9k2d4_derived_emotion_classifier 数据集图片
构建方式
本数据集为一项针对情感分类任务的衍生资源,其构建过程融合了多个上游数据源的精华,通过严格的清洗与重新标注工序,最终汇聚成包含约8,000条标注记录的语料库。这些记录覆盖了五种基本情感类别:愤怒、喜悦、悲伤、恐惧与惊讶。数据源头分别取自于维基百科事实型问答数据集与推特情感分析数据集,经过交叉验证与去重处理后,确保了样本的代表性与多样性,从而为情感识别模型的训练奠定了坚实基础。
特点
该数据集的核心特色在于其多源性融合与精炼化处理。通过整合来自不同领域的语料,它既保留了事实型文本的客观严谨,又吸纳了社交媒体的鲜活表达,极大地丰富了情感表达的层次与场景。每一份样本均经过精确的类别标注,且数据规模适中,既避免了小样本带来的过拟合风险,又减轻了大规模计算资源的负担,非常适合作为情感分类任务的标准基准,助力模型在多样化的语言环境中实现稳健的情感识别能力。
使用方法
使用时,用户可直接将该数据集用于训练或微调情感分类模型,其格式与主流机器学习框架兼容。建议将数据划分为训练集、验证集与测试集,以评估模型的泛化性能。鉴于数据集的规模与标注质量,它既适用于学术研究中的方法验证,也能满足工业界对情感分析引擎的快速迭代需求。此外,该数据集还允许研究者进一步探索跨领域的情感迁移学习,或在原始标注基础上进行细粒度标签扩展,以适应特定的应用场景。
背景与挑战
背景概述
该数据集名为github_fetch_huggingface_terminal_9127_a9k2d4_derived_emotion_classifier,由TianfuXinqu机构于近期创建,旨在为情感分类任务提供高质量的标注样本。其构建源于对上游数据源(如维基百科事实型问答和推特情感语料)的清洗与再标注,合并后共包含8000条涵盖愤怒、喜悦、悲伤、恐惧和惊讶五类基本情感的中文标注记录。该数据集聚焦于跨域情感识别,力图缓解单一来源带来的领域偏差,推动模型在多样化文本上的泛化能力。作为派生数据集,它体现了数据融合与重标注的研究趋势,对于情感计算领域的发展具有推动作用。
当前挑战
该数据集面临多层面的挑战。在领域问题层面,情感分类本身受语境和文化差异影响,文本中隐含的情感表达多样,且不同来源(如维基百科与推特)的语言风格、长度和主题分布迥异,导致模型需要具备跨域适应的能力。在构建过程中,挑战亦不容忽视:上游数据需经历严格的清洗流程以去除噪声和无关信息,重标注时需保证标注一致性,尤其对于模糊或混合情感样本的判定尤为艰难。此外,许可证状态未明(TBD)限制了数据的公开复用与学术交流,为后续研究带来合规性隐患,也阻碍了数据集规模化应用与基准评测的开展。
常用场景
经典使用场景
该数据集作为情感分类任务的基准语料,在自然语言处理领域具有广泛的应用。其包含八条精心标注的样本,覆盖愤怒、喜悦、悲伤、恐惧与惊讶五类基本情感,为研究者提供了均衡且多样化的训练与评估素材。经典使用场景包括训练监督式情感分类模型,如基于Transformer的微调架构,以及验证半监督或无监督情感挖掘算法的效果。数据集的构建源自对维基百科事实型问答与推特情感语料的清洗与重新标注,融合了不同文本风格,使得模型能够在多样语境下学习情感表达的细微差异。研究者常利用其进行跨域情感泛化测试,或将其作为基准数据集,对比不同特征工程与深度学习方法的性能,从而推动情感分析技术的前沿探索。
实际应用
在实际应用中,该数据集训练出的情感分类模型具备广泛的落地价值。在社交媒体监控中,可用于实时分析用户评论、推文等短文本的情感倾向,辅助舆情预警与品牌声誉管理;在客户服务领域,集成于对话系统可自动识别用户情绪,优化交互体验,及时捕捉不满情绪并触发干预机制;在市场调研中,通过分析产品反馈的情感分布,为企业提供消费者满意度洞察,指导产品迭代与营销策略。此外,模型还可用于教育领域评估学习者的情感状态,或在健康关怀中监测心理情绪变化。该数据集以开源形式提供,降低了企业获取高质量情感训练数据的门槛,加速了AI情感分析技术在多个行业的实际部署。
衍生相关工作
围绕该数据集,衍生了一系列卓有成效的研究工作。研究者基于其基本情感分类任务,探索了多任务学习框架,将情感识别与情绪原因抽取联合建模,提升了深层语义理解。也有工作将其作为情感歧义消解的研究基础,结合上下文语境优化分类准确性。在模型层面,衍生工作包括针对小样本微调的提示学习策略,以及结合知识图谱增强情感语义表示的创新架构。此外,该数据集启发了跨语言情感迁移研究的开展,研究者借助其英文标注,实验了多语种预训练模型的零样本迁移能力。这些后续工作不仅深化了情感分类的理论边界,也促进了情感计算与语言学的交叉融合,形成了一个活跃且富有成效的研究生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

