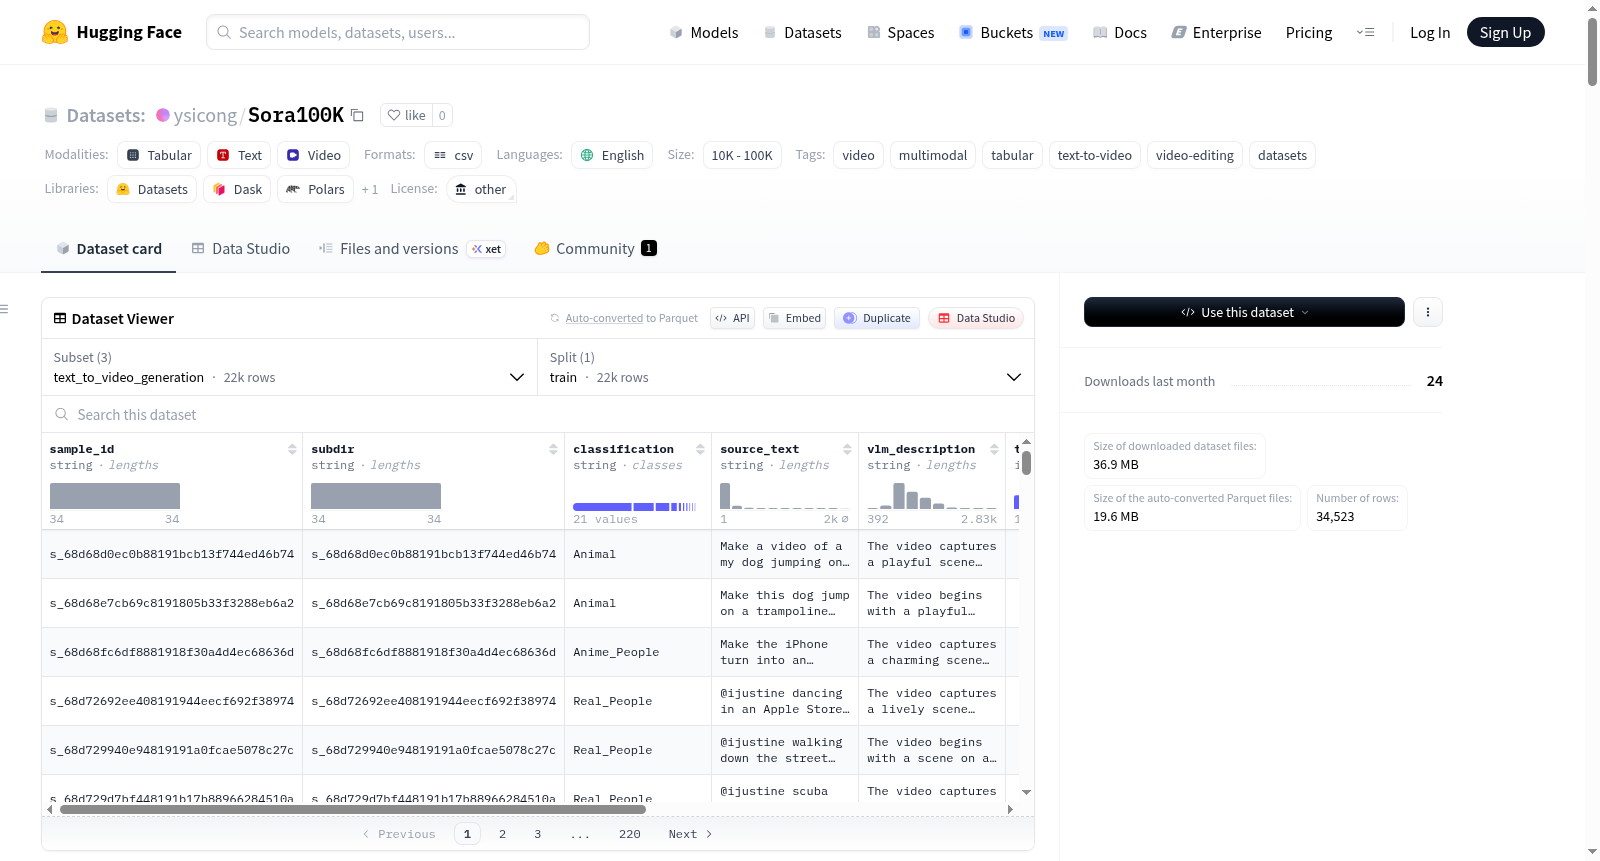
Sora100K
收藏资源简介:
Sora100K是一个大规模多模态视频数据集资源,旨在支持文本到视频生成、单轮视频编辑和多轮视频编辑的研究。该数据集在一个统一的元数据和分析框架下,为现代视频创作和编辑研究提供支持。Sora100K包含103,439个视频,分为18,451个生成样本、76,964个单轮编辑样本和8,024个多轮编辑样本或链。当前发布的Hugging Face仓库仅包含元数据层,而非原始视频文件。数据集结构分为三个子集文件夹,分别对应不同的任务设置,每个子集都有详细的README文件描述任务设置、发布状态、元数据文件和特定字段说明。Sora100K适用于多镜头组合、场景转换、编辑轨迹等视频创作工作流的结构属性研究。用户需注意,不同子集的发布完整度可能不同,且原始视频文件的获取需遵循原始平台的访问权限和条款。
Sora100K is a large-scale multimodal video dataset resource designed to support research on text-to-video generation, single-round video editing, and multi-round video editing. Built upon a unified metadata and analysis framework, this dataset supports modern video creation and editing research. Sora100K comprises 103,439 videos, categorized into three groups: 18,451 generation samples, 76,964 single-round editing samples, and 8,024 multi-round editing samples or chains. The currently released Hugging Face repository only contains the metadata layer rather than the raw video files. The dataset is structured into three subset folders corresponding to distinct task settings, each accompanied by a detailed README file that describes the task setup, release status, metadata files and specific field descriptions. Sora100K is applicable to research on the structural attributes of video creation workflows such as multi-shot composition, scene transition and editing trajectories. Users should note that the release completeness of different subsets may vary, and access to raw video files must comply with the access permissions and terms of the original platforms.
Sora100K 数据集概述
数据集基本信息
- 数据集名称:Sora100K
- 许可证:other
- 语言:英语
- 标签:video, multimodal, tabular, text-to-video, video-editing, datasets
数据集配置
数据集包含三个配置,均仅提供训练集分割:
- text_to_video_generation (默认配置)
- 数据文件路径:
Text-to-Video Generation/*.csv
- 数据文件路径:
- single_turn_video_editing
- 数据文件路径:
Single-Turn Videos Editing/*.csv
- 数据文件路径:
- multi_turn_video_editing
- 数据文件路径:
Multi-Turn Videos Editing/*.csv
- 数据文件路径:
核心描述
Sora100K 是一个用于研究文本到视频生成、单轮视频编辑和多轮视频编辑的大规模多模态视频数据集资源,其构建在统一的元数据和分析框架之下。该资源旨在支持跨多种任务设置的现代视频创作和编辑研究。当前发布的版本主要包含数据集的元数据层、文档和补充材料,不直接重新分发底层的原始视频文件。
关键统计信息
完整的 Sora100K 资源包含:
- 视频总数:103,439 个
- 文本到视频生成样本:18,451 个
- 单轮视频编辑样本:76,964 个
- 多轮视频编辑样本(链):8,024 个
数据集结构
仓库按任务设置组织为三个子集文件夹,每个文件夹包含其自身的 README.md 文件,用于描述任务设置、当前发布状态、发布的元数据文件、代表性字段以及子集特定的说明和限制。
Text-to-Video Generation/Single-Turn Videos Editing/Multi-Turn Videos Editing/
当前发布状态
三个子集的发布完整度目前不完全一致:
- Single-Turn Videos Editing 文件夹反映了当前最成熟的元数据发布部分,是当前实验中使用的主要子集。
- Text-to-Video Generation 文件夹对应于 Sora100K 的生成子集,其元数据组织可能会随着更多生成特定文件的准备而继续扩展。
- Multi-Turn Videos Editing 文件夹对应于组织为编辑链的多轮编辑子集,提供了子集特定的元数据和文档。
数据来源与访问
- 来源:数据集构建自与多种视频创作设置(包括文本到视频生成、单轮视频编辑和多轮视频编辑)相关的视频和结构化记录。在构建和预处理过程中,每个样本的结构化记录(如
meta.json、result.json、scenedetect.json)被处理并转换为表格元数据文件。 - 视频获取:用户可以通过以下步骤获取底层视频:
- 使用发布的元数据文件识别目标样本。
- 遵循仓库中提供的检索工作流程或脚本。
- 根据来源可用性和访问权限,从原始或其他授权来源访问相应的视频。
- 在原始平台要求时,重新生成有效的源级访问链接。
- 重要标识符:对于长期参考和恢复,推荐的标识符是
sample_id、source_post_id、edited_post_id。元数据中的某些链接可能是临时的,不应被视为稳定或永久的标识符。
许可与使用条款
- 此仓库标记为
license: other,因为发布的资源包含元数据、文档和相关工具,而底层原始媒体可能涉及混合所有权或平台特定的权利条件。 - 除非另有说明,此仓库不声明对元数据引用的任何原始媒体的重新许可或重新分发权利。
- 用户在检索或使用底层视频时,有责任遵守原始平台条款、创作者权利以及任何适用的法律或法规。
预期用途与限制
- 预期用途:支持多模态视频生成和编辑的研究,特别是用于数据集分析和基准测试、元数据驱动的检索与过滤、源-编辑关系与编辑轨迹研究、场景级和结构分析(包括时间组织和多镜头构图)以及可重现的数据整理、预处理和子集级评估工作流程。
- 限制:
- 当前发布版本不直接重新分发原始视频文件。
- 元数据中引用的一些源级链接或签名 URL 可能是临时的,或会随时间过期。
- 不同的子集目前可能以不同的完整度发布。
- 数据集可能继承原始生成或编辑平台的偏见、伪影或覆盖不平衡。
- 对底层视频的访问可能取决于来源可用性、平台政策或授权条件。
加载数据集示例
python from datasets import load_dataset
gen_ds = load_dataset("YOUR_USERNAME/YOUR_REPO_NAME", "text_to_video_generation") single_edit_ds = load_dataset("YOUR_USERNAME/YOUR_REPO_NAME", "single_turn_video_editing") multi_edit_ds = load_dataset("YOUR_USERNAME/YOUR_REPO_NAME", "multi_turn_video_editing")
引用
如果使用此资源,请引用相应的论文和数据集页面。