
遇见数据集

HebArabNlpProject/shoshan-data

收藏
Hugging Face2026-06-18 更新2026-07-22 收录
官方服务:

资源简介:

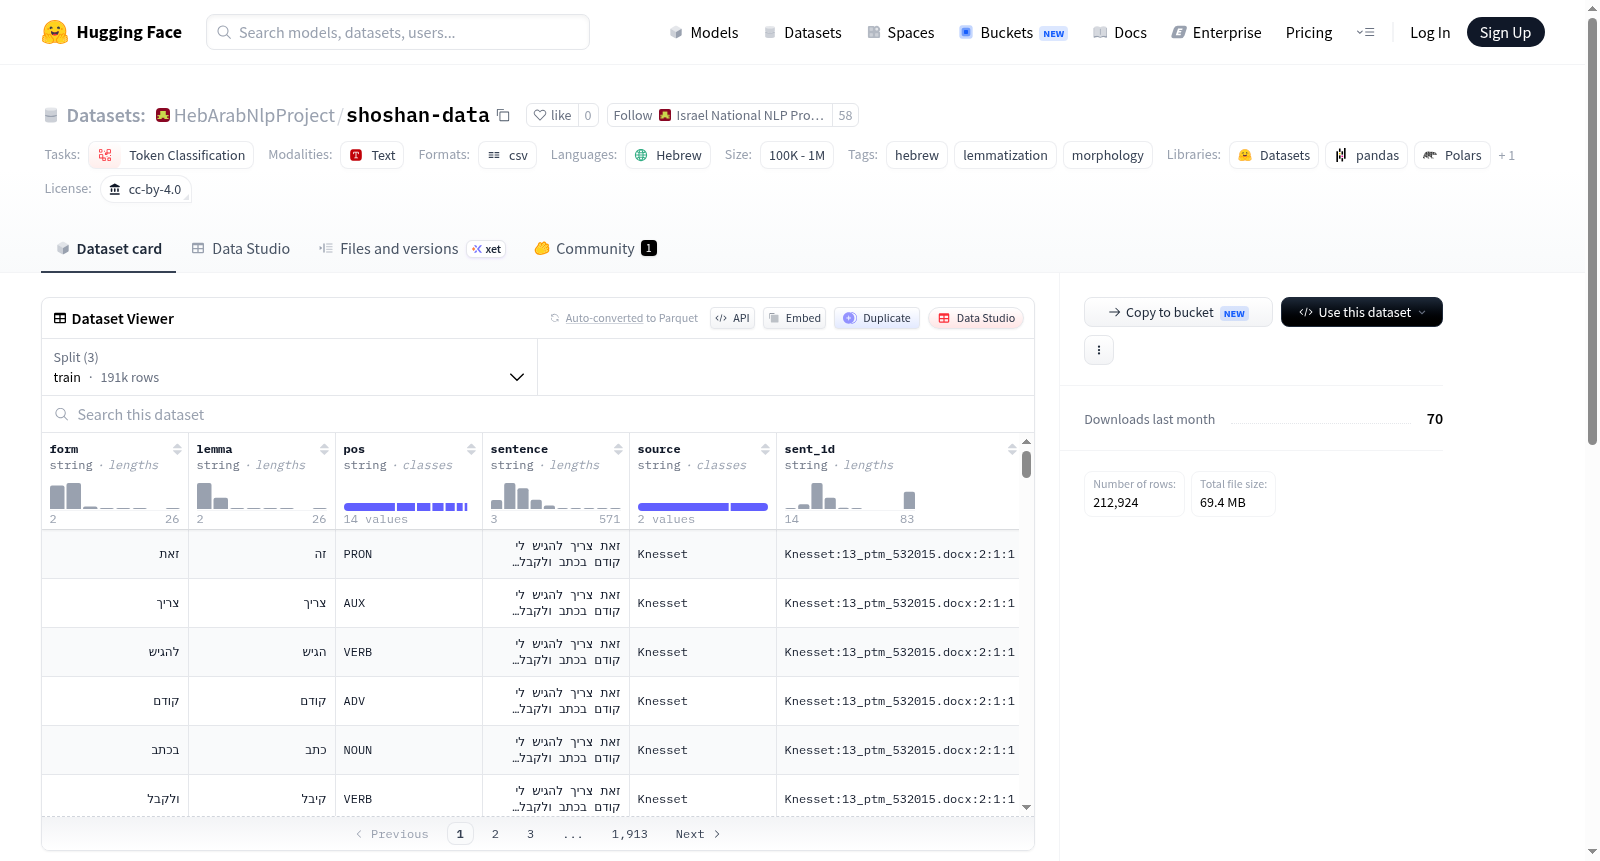
Shoshan希伯来语词形还原数据集是一个用于自然语言处理任务的数据集,专门针对希伯来语的词形还原(lemmatization)和形态学分析。它为每个表面标记(token)在上下文中提供了一个内容词元(lemma),用于训练和评估Shoshan词形还原器。数据集包含多个文件:train.csv、dev.csv和test.csv用于域内数据(来自Knesset和Wikipedia,基于IAHLT UD树库),共约191k、11k和11k行;ood.csv等文件用于域外基准测试,约5k行;oov.csv用于处理未见词元,共100行。数据列包括form(形式)、lemma(词元)、pos(词性)、sentence(句子)、source(来源)和sent_id(句子ID)。数据集基于CC BY 4.0许可证,来源于IAHLT希伯来语UD树库和公共希伯来语词典。

The Shoshan Hebrew Lemmatization Dataset is a dedicated natural language processing dataset focused on Hebrew lemmatization and morphological analysis. It provides a corresponding content lemma for each surface Token in contextual scenarios, which is designed for training and evaluating the Shoshan lemmatizer. The dataset includes multiple files: train.csv, dev.csv and test.csv for in-domain data (sourced from Knesset materials and Wikipedia, based on the IAHLT UD Treebank), with approximately 191k, 11k and 11k rows respectively; ood.csv and other related files for out-of-domain benchmarking, containing around 5k rows; and oov.csv for handling unseen lemmas, which has 100 rows in total. The dataset columns consist of form, lemma, pos (part-of-speech), sentence, source and sent_id (sentence ID). This dataset is licensed under CC BY 4.0, and its data originates from the IAHLT Hebrew UD Treebank and public Hebrew lexical dictionaries.
提供机构:
HebArabNlpProject
搜集汇总
数据集介绍
HebArabNlpProject/shoshan-data 数据集图片
构建方式
Shoshan数据集的构建依托于IAHLT希伯来语UD树库(涵盖以色列议会与维基百科语料)及公开希伯来语词汇资源,通过上下文感知的标注策略,为每个表层词形赋予唯一的词元。数据集划分为领域内(Knesset、Wikipedia、IAHLT UD)训练/开发/测试集(191k/11k/11k行),以及多领域外基准集(ood.csv及其子文件,含Bagatz、GeekTime、Dicta三个子领域各100句),并包含罕见词元尾部(oov.csv)。所有数据以CSV格式存储,包含form、lemma、pos、sentence、source、sent_id六列,确保了标注的完整性与可追溯性。
特点
该数据集的核心特色在于其细粒度的词元消歧能力与领域多样性。每个表层词形在具体上下文中仅对应一个词元,突破了传统静态词典的局限。领域内数据覆盖议会辩论与百科全书等正式文本,而领域外基准则涵盖司法判决、科技博客与语言词典等小众领域,全面检验词元化器的泛化性能。此外,oov.csv专门聚焦训练中未见的词元尾部,为模型处理稀有形态变化提供了严苛的评测基准。数据规模虽仅约200k行,但通过精心设计的层次化拆分,实现了对模型能力的多维评估。
使用方法
用户可通过Shoshan配套Python包便捷调用数据集。以`from shoshan import data`导入后,`data.load()`函数支持指定`'train'`、`'dev'`、`'test'`、`'ood'`或`'oov'`参数,返回缓存的pandas DataFrame,无需手动管理文件路径。对于需要跨领域分析的场景,可分别加载`ood_Bagatz`、`ood_GeekTime`、`ood_Dicta`子文件。所有数据遵循CC BY 4.0许可协议,允许自由使用与衍生,仅需标注原始来源。开发者可据此训练希伯来语词元化模型,或作为独立基准评估现有NLP流水线的形态学分析能力。
背景与挑战
背景概述
希伯来语作为闪含语系的重要语言,其形态丰富且复杂,词形变化高度依赖上下文,给自然语言处理带来了独特挑战。在此背景下,Shoshan数据集于近年由以色列研究团队(包括Avner Algom及IAHLT组织)创建,旨在为希伯来语的词形还原(lemmatization)提供高质量的训练与评估资源。该数据集以每个表层词对应一个上下文相关词条为核心设计,覆盖了以色列议会会议记录、维基百科等内域来源,并包含多个外域基准测试集,如Bagatz、GeekTime、Dicta等。Shoshan数据集的发布显著推动了希伯来语形态分析的研究,为词形还原器的开发与评测奠定了标准化基础,成为该领域的重要参考资源。
当前挑战
希伯来语词形还原面临的主要挑战包括:语言层面,希伯来语具有高度形态融合性,同一词根可衍生出大量表面形态,且语境对词条消歧至关重要,传统基于规则或统计的方法难以兼顾准确性与覆盖度。数据集构建过程中则需应对以下难题:一是数据来源多样性带来的标注一致性,如从议会记录、百科到技术论坛的术语跨度;二是稀有词素(OOV)的处理,数据集中特设未见词条尾集以评估模型泛化能力;三是外域迁移挑战,需通过跨领域测试集验证词形还原器的鲁棒性,确保模型在真实应用场景中的可靠性。
常用场景
经典使用场景
在现代自然语言处理研究中,形态丰富的语言如希伯来语因其复杂的词形变化体系而面临独特的挑战。Shoshan数据集正是为应对这一挑战而生,其经典使用场景是上下文相关的词目还原任务,即为每一个表层词元在具体语境中标注唯一的词目。该数据集涵盖了内领域(以色列议会与维基百科语料)和跨领域(如司法判决、科技博客及词典语料)的多个子集,提供了超过20万条高质量标注样本,为训练和评估希伯来语词目还原模型奠定了坚实基础。
解决学术问题
Shoshan数据集的核心价值在于解决了希伯来语自然语言处理中一个长期存在的难题:如何在保留上下文信息的前提下,高效、准确地从复杂词形中还原出词目。传统规则方法因希伯来语丰富的形态变化而难以泛化,而该数据集的问世推动了从规则到数据驱动范式的转变。学术上,它使得研究者能够系统评估不同模型在领域内与领域外场景下的词目还原性能,尤其为研究形态学消歧、词汇语义统一等前沿课题提供了标准化基准,在提升希伯来语信息检索与文本分析的底层能力上具有深远意义。
衍生相关工作
围绕Shoshan数据集,学术界与工业界已衍生出多项具有代表性的工作。最直接的是以其命名的Shoshan词目还原器,该工具基于上下文感知的序列标注模型,在多个跨领域基准上取得了卓越性能。此外,该数据集常被与IAHLT希伯来语依存树库联合使用,推动了对希伯来语形态句法交互的深入探索。另一类衍生工作则聚焦于域适应与零样本学习问题,利用Shoshan提供的领域外测试集来验证模型在新兴领域(如法律文本、科技媒体)中的泛化能力,这些研究进一步拓展了数据集的应用边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

