peterkchung/commonsense_cot_partial_raw
收藏资源简介:
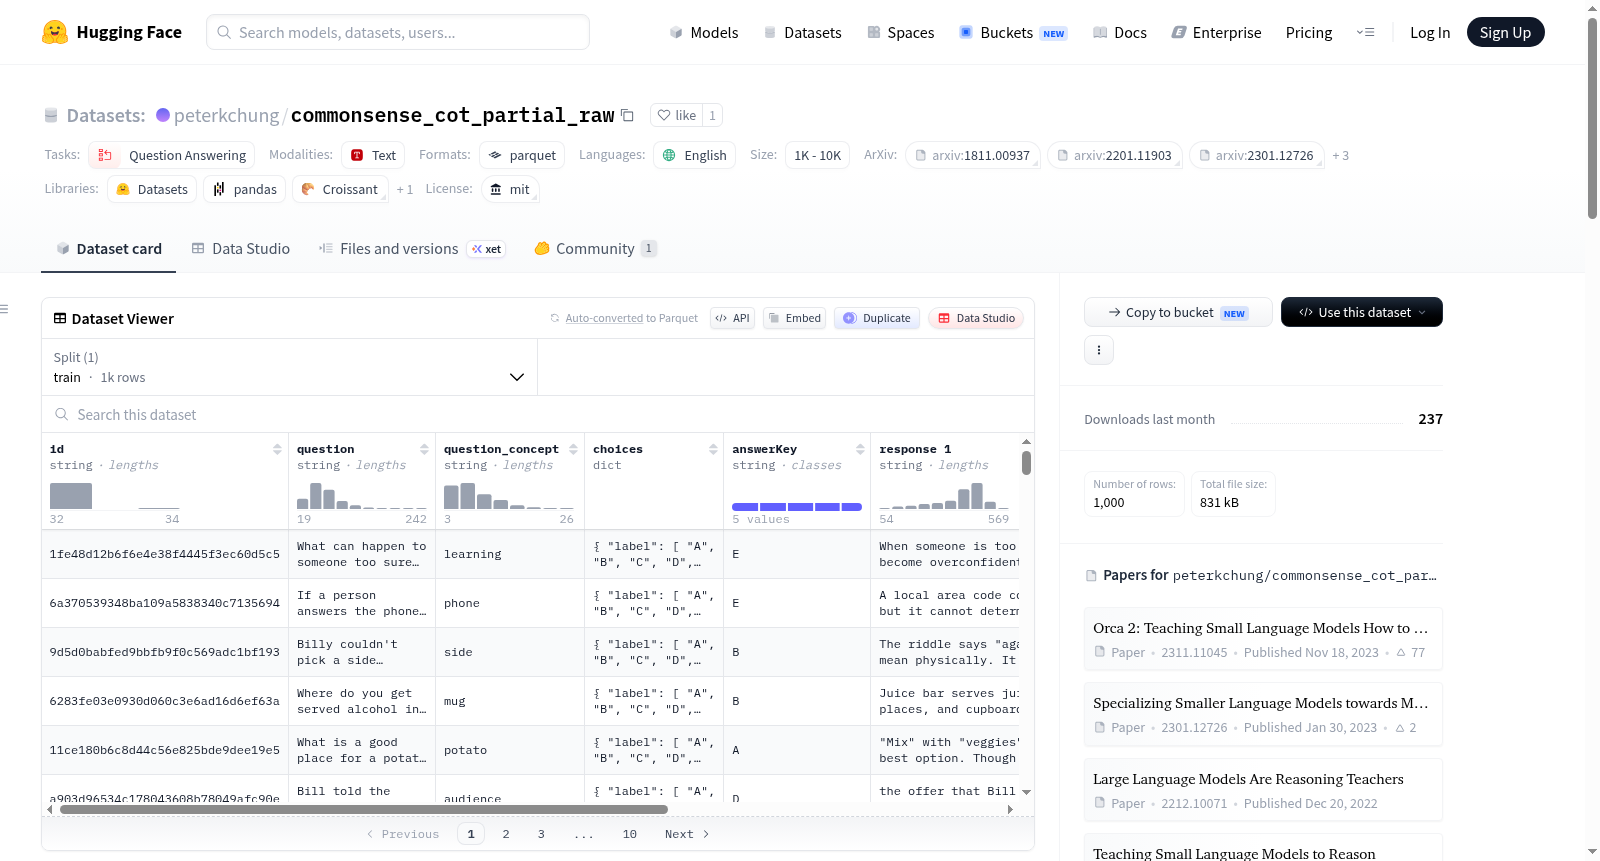
该数据集是基于CommonsenseQA数据集的一个初步版本,随机抽取了1000个问答条目,并使用Mixtral模型生成了3个独特的CoT(Chain-of-Thought)推理过程。该数据集的创建是为了作为微调语言模型(LM)以专注于常识推理的初步步骤。数据集的结构包括唯一ID、问题、问题相关的概念、选项、答案以及三个生成的推理过程。数据集的语言为英语,且未经过人工标注。
该数据集是基于CommonsenseQA数据集的一个初步版本,随机抽取了1000个问答条目,并使用Mixtral模型生成了3个独特的CoT(Chain-of-Thought)推理过程。该数据集的创建是为了作为微调语言模型(LM)以专注于常识推理的初步步骤。数据集的结构包括唯一ID、问题、问题相关的概念、选项、答案以及三个生成的推理过程。数据集的语言为英语,且未经过人工标注。
Commonsense QA CoT (Partial, Raw, No Human Annotation)
数据集概述
该数据集基于CommonsenseQA数据集(tau/commonsense_qa),随机抽样了1,000个问题-答案条目,并使用Mixtral(mistralai/Mixtral-8x7B-Instruct-v0.1)生成了3个独特的CoT(Chain-of-Thought)推理过程。这是为了微调语言模型(LM)以专门处理常识推理的初步步骤。
数据集结构
语言
数据集为英语(en)。
数据字段
id(str): 唯一ID。question(str): 问题。question_concept(str): 与问题相关的ConceptNet概念。choices: 包含以下字段的字典特征:label(str): 选项标签。text(str): 选项文本。
answerKey(str): 答案键。response1(str): 第一个推理过程。response2(str): 第二个推理过程。response3(str): 第三个推理过程。
数据示例
json { "id": "1fe48d12b6f6e4e38f4445f3ec60d5c5", "question": "What can happen to someone too sure of their learning?", "question_concept": "learning", "choices": { "label": ["A", "B", "C", "D", "E"], "text": ["growth", "gaining knowledge", "enlightenment", "knowing more", "overconfidence"] }, "answerKey": "E", "response 1": "When someone is too sure of their learning, they become overconfident, thinking that they know everything. This can prevent them from learning more, as they stop seeking new knowledge and ideas. They might also miss out on enlightenment, as they close themselves off to new perspectives. Overall, their growth might be stunted, as they stop challenging themselves and expanding their understanding. So, out of the given choices, the most appropriate answer is overconfidence.", "response 2": "Overconfidence can lead someone to fail to question their own preconceptions, in turn hindering further learning and receptiveness to new information. On the other hand, growth, gaining knowledge, enlightenment, and knowing more would all be positive consequences of learning. Therefore, the most accurate answer would be overconfidence.", "response 3": "Knowing more and gaining knowledge come with learning, so those are probably not the answers. Growth is a natural response to learning, and one should always be open to enlightenment, so those cant be the answers either. Overconfidence may be the best answer - being too sure of ones learning can lead to arrogance and a lack of willingness to learn more. (Source: English Consonant Spelling)" }
数据集信息
- 特征:
id: 字符串类型。question: 字符串类型。question_concept: 字符串类型。choices: 包含以下结构的特征:label: 字符串序列。text: 字符串序列。
answerKey: 字符串类型。response 1: 字符串类型。response 2: 字符串类型。response 3: 字符串类型。
- 分割:
train: 1,000个样本,1,364,962字节。
- 下载大小: 823,371字节。
- 数据集大小: 1,364,962字节。
- 配置:
default: 数据文件路径为data/train-*。
- 许可证: MIT许可证。
- 任务类别: 问答。
- 语言: 英语。
- 数据集名称: CommonsenseQA CoT - Partial list, Raw entries, No Human Annotation。
- 大小类别: n<1K。