遇见数据集

zh-tw-tts-arena-votes

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

该数据集名为zh-TW TTS Arena — votes,是一个用于记录盲测A/B偏好投票的追加日志,由zh-tw-tts-arena Space收集。它专注于文本到语音(TTS)领域,特别针对中文(台湾)语言(zh-TW),旨在通过人类反馈评估和比较不同TTS模型的性能。数据以JSONL格式存储,每个JSON对象代表一次投票记录,包含时间戳(ts)、会话标识(session)、句子ID(sentence_id)、模型A(model_a)、模型B(model_b)、条件A(condition_a)、条件B(condition_b)、胜者(winner,可选模型A、模型B或平局)、停留时间(dwell_s,以秒为单位)、用户代理(ua)和应用程序版本(app_version)等字段。这些字段详细记录了每次投票的上下文和结果,适用于A/B测试、TTS模型评估、偏好分析和人类反馈收集等任务。数据集采用CC-BY-4.0许可证,支持开源使用和共享。

This dataset, named zh-TW TTS Arena — votes, is an append-only log for recording blind-tested A/B preference votes, collected by the zh-tw-tts-arena Space. It focuses on the text-to-speech (TTS) domain, specifically targeting Traditional Chinese (zh-TW), and aims to evaluate and compare the performance of various TTS models via human feedback. The dataset is stored in JSONL format, where each JSON object represents a single voting record, containing fields including timestamp (ts), session identifier (session), sentence ID (sentence_id), model A (model_a), model B (model_b), condition A (condition_a), condition B (condition_b), winner (with optional values: model A, model B, or tie), dwell time (dwell_s, in seconds), user agent (ua), and application version (app_version). These fields thoroughly record the context and outcome of each voting event, making the dataset applicable to tasks such as A/B testing, TTS model evaluation, preference analysis, and human feedback collection. This dataset is licensed under CC-BY-4.0, permitting open-source usage and sharing.

创建时间:
2026-06-27
原始信息汇总

数据集概述

数据集名称:zh-TW TTS Arena — blind-test votes
许可证:CC-BY-4.0
标签:人类反馈、文本转语音、竞技场
显示名称:zh-TW TTS Arena — 盲测投票

数据集描述

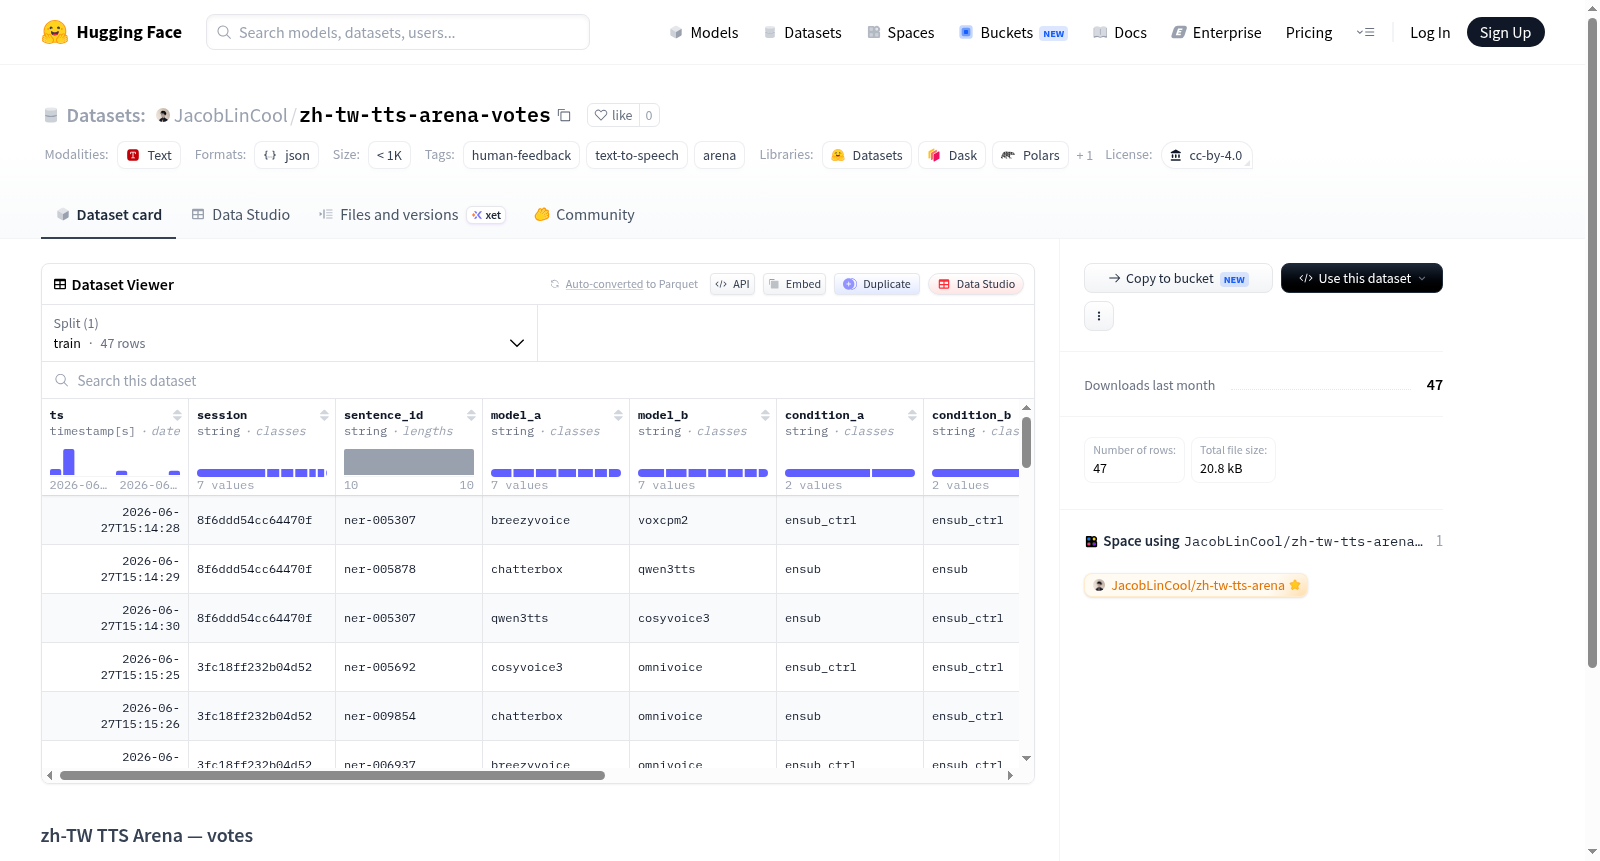
这是一个由 zh-tw-tts-arena Space 收集的盲测 A/B 偏好投票的仅追加日志(append-only log)。数据以 JSON 对象形式存储,每行一个对象,位于 data/ 目录下。

数据架构

每条 JSON 对象包含以下字段:

  • ts:时间戳
  • session:会话标识
  • sentence_id:句子标识
  • model_a:模型 A 的名称
  • model_b:模型 B 的名称
  • condition_a:模型 A 的条件
  • condition_b:模型 B 的条件
  • winner:获胜者(abtie,分别表示模型 A 获胜、模型 B 获胜或平局)
  • dwell_s:停留时间(秒)
  • ua:用户代理
  • app_version:应用版本

数据配置

  • 默认配置default
  • 数据文件data/*.jsonl(所有 data/ 目录下的 .jsonl 文件)
搜集汇总
数据集介绍
zh-tw-tts-arena-votes 数据集图片
构建方式
本数据集源自名为「zh-tw-tts-arena」的HuggingFace Space应用,通过其部署的盲测A/B偏好投票系统持续累积而成。系统在后台以追加写入方式记录每一次投票事件,所有原始数据按行存储于JSON Lines格式文件中,每条记录包含时间戳、会话标识、句子编号、两个待比较的语音合成模型名称及其生成条件、投票结果(胜出方或平局)、用户停留时长、用户代理信息及应用版本等字段,确保了数据来源的实时性、完整性与可追溯性。
使用方法
使用者可通过HuggingFace Datasets库直接加载该数据集,在代码中指定配置名为'default'并指向'data/*.jsonl'文件即可获取全部记录。每条JSON对象可直接解析为字典结构,字段如'model_a'和'model_b'用于识别对比模型,'winner'字段指示胜方。研究人员可据此统计分析不同TTS模型的获胜频率,结合'sentence_id'与'condition_a'等字段深入探究特定文本或生成条件对偏好结果的影响,亦可利用'timestamp'与'session'进行时间序列分析或用户行为建模。
背景与挑战
背景概述
在文本到语音(TTS)技术迅猛发展的当下,针对特定语言与方言的高质量评估资源仍显匮乏,尤其是对于中文繁体(zh-TW)这一具有独特音韵与语法特征的语言。zh-tw-tts-arena-votes数据集应运而生,由Hugging Face社区维护,通过众包盲测平台“zh-TW TTS Arena”收集用户对多个TTS模型输出的成对偏好投票。该数据集创建于2024年,采用CC-BY-4.0许可协议,致力于为中文繁体TTS系统的比较提供标准化、无偏见的反馈基准。其核心研究问题在于如何通过人类主观评价量化不同TTS模型在自然度、流畅性和语音清晰度等维度的表现差异,从而推动该语种下语音合成技术的客观评测与迭代优化。作为首个大规模收集中文繁体TTS盲测偏好的公开数据集,它在语音交互、本地化服务及辅助技术等领域具有重要的应用价值。
当前挑战
该数据集所解决的领域问题在于,传统的TTS评测常依赖客观指标(如MOS),但难以捕捉真实听感中的细微差异,尤其是中文繁体特有的声调、语调和停连等韵律特征。zh-tw-tts-arena-votes通过人类盲测引入主观偏好,但面临数据质量控制难题:投票用户来自非专业背景,可能受情感、设备或环境噪声干扰,导致偏好偏差。构建过程中,平台需解决会话管理、重复投票过滤、反作弊机制及实时持久化等工程挑战,同时确保不同TTS模型在随机配对下的公平比较。此外,数据稀疏性(如某些模型对的出现次数不足)与长尾模型的处理,也对统计推断的可靠性提出了额外要求,需谨慎设计偏好聚合与置信度估计方法。
常用场景
经典使用场景
zh-tw-tts-arena-votes 数据集的核心应用在于构建基于人类偏好的文本转语音(TTS)模型评估基准。通过收集大规模盲测投票数据,研究人员可以系统性地比较不同TTS系统在繁体中文语音合成中的自然度、清晰度及情感表达等维度的表现。该数据集尤为适用于训练偏好预测模型,例如利用用户投票作为弱监督信号,优化TTS系统的音频生成策略,从而推动语音合成技术向着更符合人类听觉审美的方向发展。
解决学术问题
在学术研究中,该数据集有效解决了TTS领域长期存在的主观评价缺乏标准化的问题。传统的客观指标(如MOS分数)难以全面反映语音质量,而zh-tw-tts-arena-votes 提供的细粒度偏好数据,使得研究者能够从数百万条真实用户反馈中挖掘合成语音的感知差异。这为分析不同声学模型、声码器或语言特征对语音自然度的影响提供了实证基础,促进了语音质量评估方法从单一得分向多维偏好建模的范式转变。
实际应用
实际应用层面,该数据集直接服务于繁体中文地区的智能语音助手、有声读物生成、新闻播报及教育软件等场景。企业可利用投票数据训练定制化的TTS模型,使其输出更适合台湾地区的语音习惯、语速偏好和文化语境。例如,通过分析用户对特定发音风格或情绪传达的投票,开发者能调整语音合成参数以提升人机交互的沉浸感,广泛应用于客服对话系统、语音导航及辅助阅读工具中。
数据集最近研究
最新研究方向
在中文文本转语音领域,zh-tw-tts-arena-votes数据集通过众包盲测偏好投票机制,系统性地采集了台湾繁体中文语音合成的听觉偏好数据。该数据集记录了时间戳、会话标识、句子编号、模型配对及胜负判定等结构化信息,为评估不同TTS模型在自然度、情感表达和发音准确性上的感知差异提供了可复现的基准。其连续追加的日志式设计反映了人类反馈量化评估的前沿方向,能够支撑强化学习与微调策略的验证,推动个性化语音合成与跨语言情感迁移等热点问题的研究,对优化面向台湾用户的听觉体验具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务