
遇见数据集

richardr1126/spider-natsql-context-validation

收藏
Hugging Face2023-07-06 更新2024-03-04 收录
官方服务:

资源简介:

该数据集是基于Spider数据集创建的,用于验证LLMs在Spider开发数据集上的表现,并使用了NatSQL。Spider是一个大规模、复杂且跨领域的语义解析和文本到SQL数据集,由11名耶鲁学生标注。NatSQL是一种SQL的中间表示形式,它简化了查询并减少了自然语言与SQL之间的不匹配。NatSQL保留了SQL的核心功能,但删除了一些难以从自然语言描述中推断的条款和关键字,同时通过减少需要预测的模式项数量,使模式链接更容易。NatSQL可以轻松转换为可执行的SQL查询,并可以提高文本到SQL模型的性能。

该数据集是基于Spider数据集创建的,用于验证LLMs在Spider开发数据集上的表现,并使用了NatSQL。Spider是一个大规模、复杂且跨领域的语义解析和文本到SQL数据集,由11名耶鲁学生标注。NatSQL是一种SQL的中间表示形式,它简化了查询并减少了自然语言与SQL之间的不匹配。NatSQL保留了SQL的核心功能,但删除了一些难以从自然语言描述中推断的条款和关键字,同时通过减少需要预测的模式项数量,使模式链接更容易。NatSQL可以轻松转换为可执行的SQL查询,并可以提高文本到SQL模型的性能。

提供机构:
richardr1126
原始信息汇总

数据集概述

数据集名称

Spider NatSQL Context Validation

数据集摘要

Spider是一个大规模、复杂且跨领域的语义解析和文本到SQL的数据集,由11名耶鲁大学学生标注。该数据集旨在验证大型语言模型在Spider开发数据集上使用NatSQL进行数据库上下文验证的能力。

数据集特征

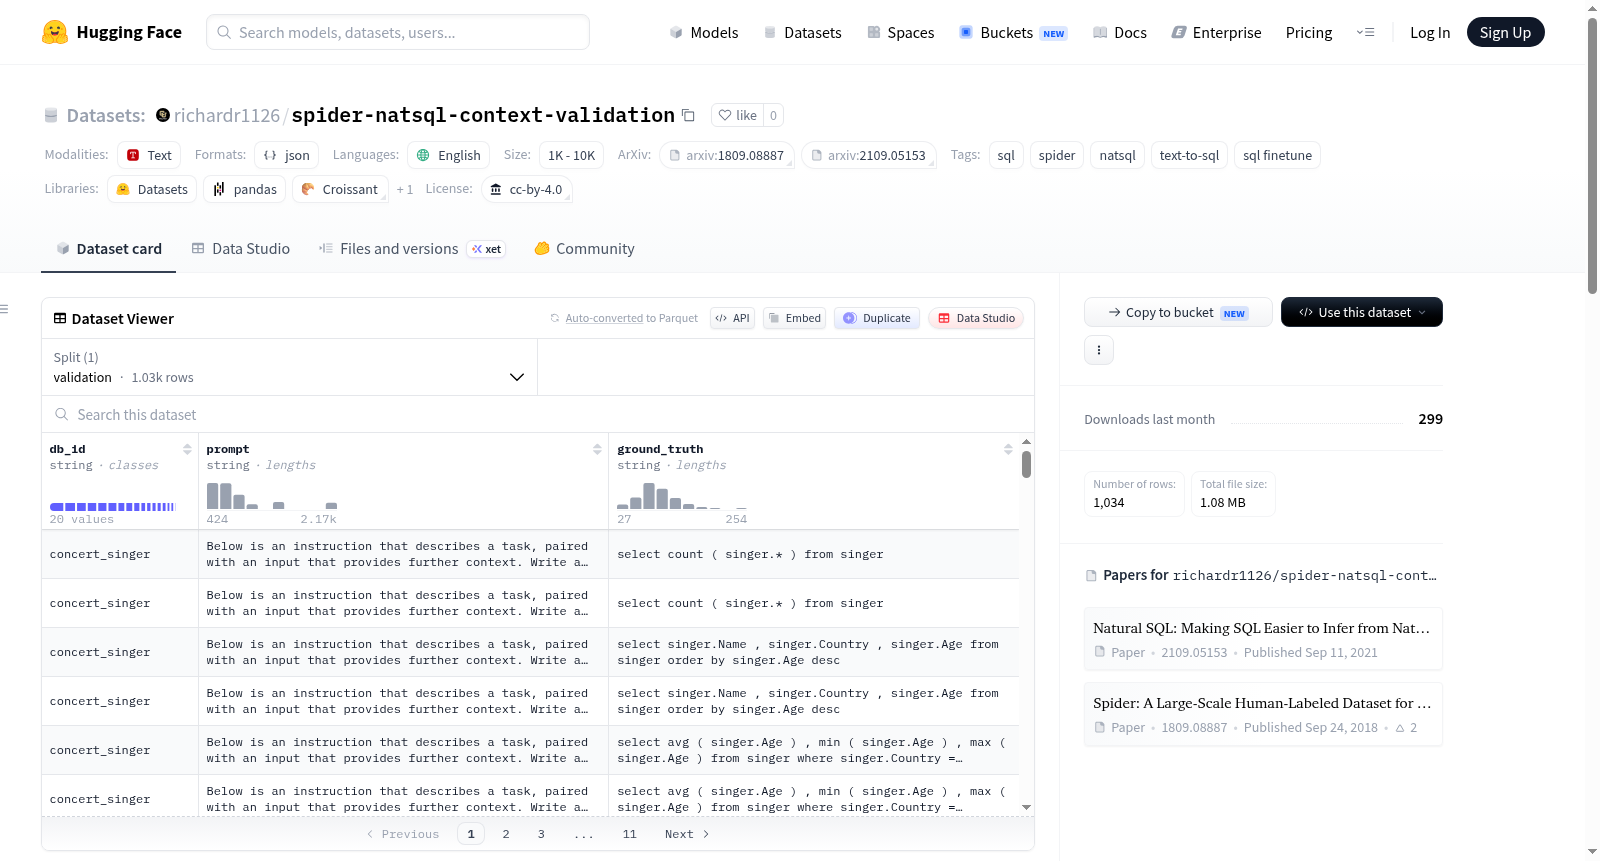
  • db_id: 数据类型为字符串
  • prompt: 数据类型为字符串
  • ground_truth: 数据类型为字符串

语言

数据集中的文本语言为英语

许可证

数据集遵循CC BY-SA 4.0许可证

引用信息

@article{yu2018spider, title={Spider: A large-scale human-labeled dataset for complex and cross-domain semantic parsing and text-to-sql task}, author={Yu, Tao and Zhang, Rui and Yang, Kai and Yasunaga, Michihiro and Wang, Dongxu and Li, Zifan and Ma, James and Li, Irene and Yao, Qingning and Roman, Shanelle and others}, journal={arXiv preprint arXiv:1809.08887}, year={2018} }

@inproceedings{gan-etal-2021-natural-sql, title = "Natural {SQL}: Making {SQL} Easier to Infer from Natural Language Specifications", author = "Gan, Yujian and Chen, Xinyun and Xie, Jinxia and Purver, Matthew and Woodward, John R. and Drake, John and Zhang, Qiaofu", booktitle = "Findings of the Association for Computational Linguistics: EMNLP 2021", month = nov, year = "2021", address = "Punta Cana, Dominican Republic", publisher = "Association for Computational Linguistics", url = "https://aclanthology.org/2021.findings-emnlp.174", doi = "10.18653/v1/2021.findings-emnlp.174", pages = "2030--2042", }
搜集汇总
数据集介绍
richardr1126/spider-natsql-context-validation 数据集图片
构建方式
该数据集基于Spider大规模跨领域语义解析语料库构建,旨在评估大语言模型在数据库上下文中的自然语言到SQL转换能力。构建过程中引入了NatSQL中间表示,这是一种简化SQL查询、降低自然语言与SQL之间语义鸿沟的表示形式。NatSQL通过去除难以从自然语言中推断的从句和关键词,保留了SQL的核心功能,并简化了模式链接任务。原始Spider开发集经过NatSQL转换后,形成了包含db_id、prompt和ground_truth三个字段的验证数据集,每个样本均提供了数据库标识符、自然语言查询及其对应的NatSQL表示。
特点
该数据集的核心特点在于融合了NatSQL中间表示,显著降低了文本到SQL任务的复杂性。NatSQL减少了需要预测的模式项数量,使得模型能够更专注于核心语义匹配,从而提升跨领域泛化能力。数据集保留了Spider的跨领域特性,覆盖多个领域的数据库,并采用英文自然语言查询。此外,每个样本均提供数据库上下文信息(db_id),便于模型在真实数据库环境中进行验证。数据集采用CC-BY-SA 4.0许可协议,确保了学术研究和商业应用的开放性。
使用方法
该数据集可直接用于大语言模型的微调与评估,支持文本到SQL任务的验证。使用时,用户可加载prompt字段作为模型输入,ground_truth字段作为目标输出,db_id字段用于关联数据库模式。推荐将NatSQL表示转换为可执行SQL后再计算执行准确率。数据集与Spider官方评估脚本兼容,用户可通过Yale Lily Spider排行榜提交结果。建议在微调时结合数据库模式信息,以充分利用上下文验证能力。数据加载可通过HuggingFace Datasets库实现,支持Python环境下的快速集成。
背景与挑战
背景概述
文本到SQL(Text-to-SQL)任务旨在将自然语言查询自动转换为可执行的SQL语句,是实现智能数据库交互的核心技术之一。Spider数据集由耶鲁大学Lily实验室于2018年创建,由11名耶鲁大学学生精心标注,包含200个跨领域数据库和超过10,000条复杂查询,成为评估语义解析模型泛化能力的权威基准。该数据集推动了从简单单表查询到复杂多表关联、嵌套子查询等挑战性场景的研究进展,显著提升了自然语言接口在跨领域数据库中的应用潜力。在此基础上,richardr1126/spider-natsql-context-validation数据集引入NatSQL中间表示,旨在通过简化SQL结构并保留核心功能,进一步缩小自然语言与SQL之间的语义鸿沟,为大型语言模型提供更精准的验证环境。该数据集不仅继承了Spider的复杂性和跨领域特性,还通过NatSQL降低了模式链接难度,为探索高效、鲁棒的Text-to-SQL模型提供了新的研究视角。
当前挑战
该数据集面临的核心挑战源于Text-to-SQL任务的固有复杂性。首先,跨领域泛化问题要求模型理解多样化的数据库模式(如电商、医疗、教育等),并适应不同领域的术语和关系结构,这远超传统单领域模型的能力范围。其次,自然语言查询的歧义性与SQL的精确性之间存在巨大鸿沟,模型需精准解析用户意图,处理隐式条件、否定表达和复杂逻辑(如多表连接、聚合函数与嵌套查询)。在构建过程中,NatSQL中间表示的引入虽然简化了查询,但如何确保其与原始SQL的语义等价性,并避免信息丢失,是数据标注和验证的关键难点。此外,大规模人工标注的准确性和一致性维护、多数据库模式下查询覆盖的全面性,以及模型对未见数据库的零样本适应能力,均构成严峻的技术挑战。
常用场景
经典使用场景
该数据集专为评估和验证大型语言模型在跨领域数据库上的文本到SQL转换能力而设计,特别引入NatSQL作为中间表示,以简化SQL的复杂结构,降低自然语言与SQL之间的语义鸿沟。通过提供带有数据库上下文的验证集,研究者可系统性地测试模型在复杂、多领域查询场景下的鲁棒性与准确性,从而推动语义解析技术的边界拓展。
实际应用
在实际应用中,该数据集为构建智能数据库查询接口提供了关键验证工具,助力开发能够理解用户自然语言提问并自动生成准确SQL查询的对话系统。其跨领域特性使其适用于金融、医疗、教育等多个行业的非技术用户,降低数据库交互门槛,提升数据获取效率,从而赋能商业智能分析和数据驱动决策。
衍生相关工作
基于该数据集,衍生出多项关于中间表示优化与跨领域语义解析的经典研究,如NatSQL的提出本身即是对传统SQL表示的革新,后续工作进一步探索了将NatSQL与其他预训练语言模型结合的方法,以及如何利用该验证集设计更高效的上下文感知解码策略。这些工作共同推动了文本到SQL领域从单一领域向复杂、多领域场景的演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

