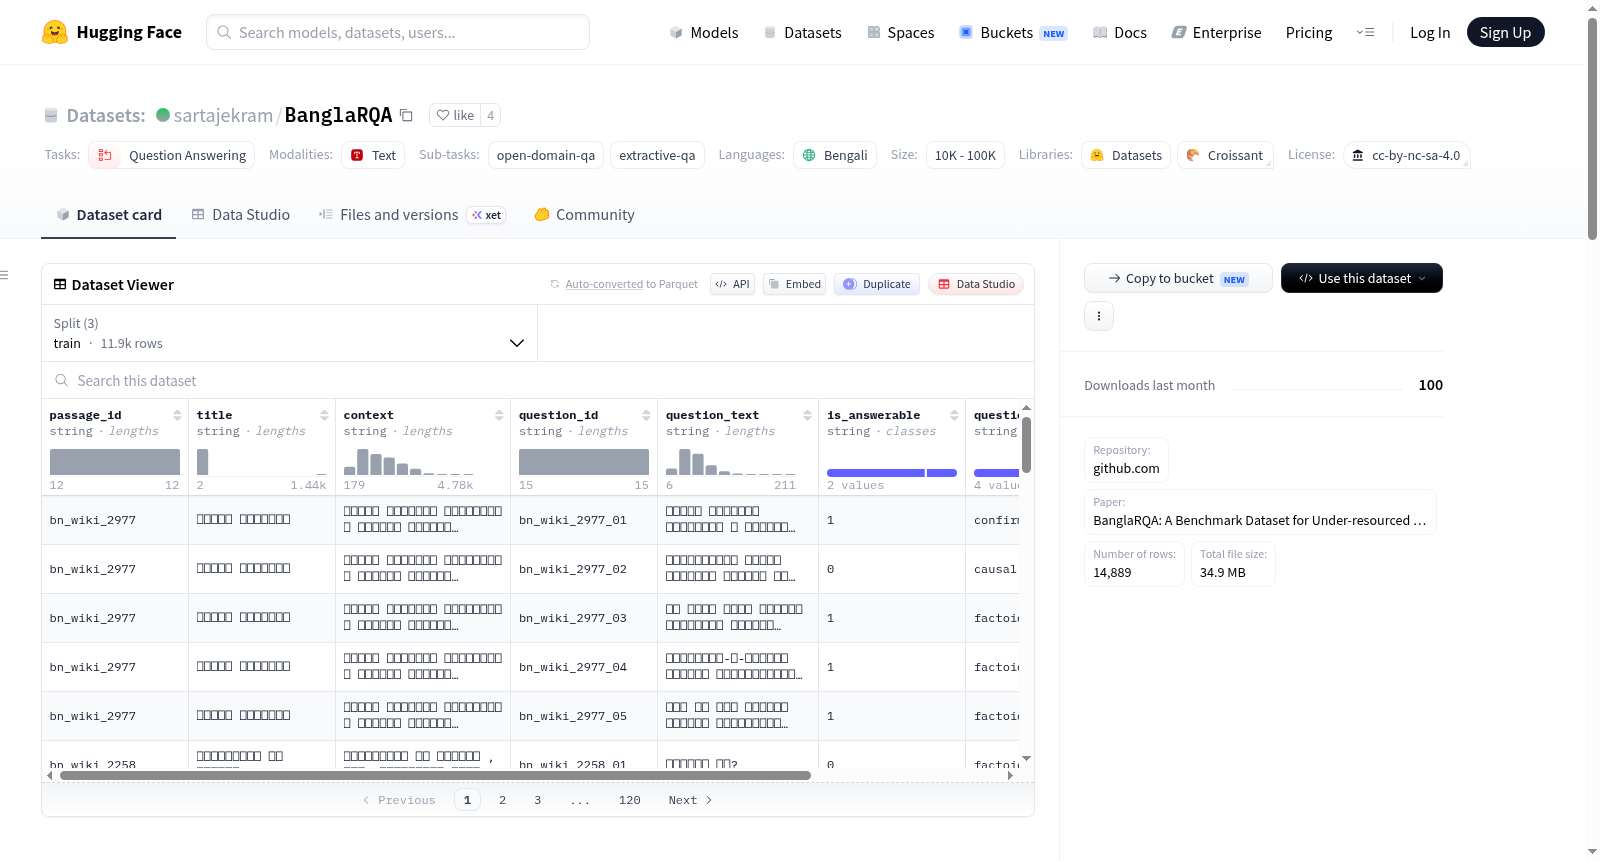
sartajekram/BanglaRQA
收藏资源简介:
BanglaRQA是一个人工标注的孟加拉语问答数据集,包含多种问答类型。该数据集旨在解决孟加拉语在阅读理解问答数据集方面的不足,特别是针对资源匮乏的语言。数据集包含3,000个上下文段落和14,889个问答对,涵盖了可回答和不可回答的问题,以及四种独特的问题类别和三种答案类型。数据集的使用受限于非商业研究目的,遵循CC BY-NC-SA 4.0许可。
BanglaRQA is a manually annotated Bengali question answering (QA) dataset encompassing diverse QA types. It is designed to alleviate the scarcity of Bengali reading comprehension QA datasets, particularly for low-resource languages. The dataset consists of 3,000 context paragraphs and 14,889 QA pairs, covering both answerable and unanswerable questions, alongside four unique question categories and three answer types. Its use is limited to non-commercial research purposes, and it is released under the CC BY-NC-SA 4.0 license.
数据集概述
数据集名称
BanglaRQA
数据集摘要
这是一个由人类标注的孟加拉语问答(QA)数据集,包含多种问题-答案类型。
语言
Bangla
使用示例
python from datasets import load_dataset dataset = load_dataset("sartajekram/BanglaRQA")
数据集结构
- 数据实例:提供了一个JSON格式的示例,包含文章ID、标题、上下文、问题ID、问题文本、是否可回答、问题类型和答案。
- 数据字段:包括文章ID、标题、上下文、问题ID、问题文本、是否可回答、问题类型和答案。
- 数据分割:
train: 11,912validation: 1,484test: 1,493
许可信息
本数据集内容仅限于非商业研究目的使用,遵循Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International License (CC BY-NC-SA 4.0)。数据集内容的版权属于原始版权持有者。
引用信息
如果您使用此数据集,请引用以下论文:
@inproceedings{ekram-etal-2022-banglarqa, title = "{B}angla{RQA}: A Benchmark Dataset for Under-resourced {B}angla Language Reading Comprehension-based Question Answering with Diverse Question-Answer Types", author = "Ekram, Syed Mohammed Sartaj and Rahman, Adham Arik and Altaf, Md. Sajid and Islam, Mohammed Saidul and Rahman, Mehrab Mustafy and Rahman, Md Mezbaur and Hossain, Md Azam and Kamal, Abu Raihan Mostofa", booktitle = "Findings of the Association for Computational Linguistics: EMNLP 2022", month = dec, year = "2022", address = "Abu Dhabi, United Arab Emirates", publisher = "Association for Computational Linguistics", url = "https://aclanthology.org/2022.findings-emnlp.186", pages = "2518--2532", abstract = "High-resource languages, such as English, have access to a plethora of datasets with various question-answer types resembling real-world reading comprehension. However, there is a severe lack of diverse and comprehensive question-answering datasets in under-resourced languages like Bangla. The ones available are either translated versions of English datasets with a niche answer format or created by human annotations focusing on a specific domain, question type, or answer type. To address these limitations, this paper introduces BanglaRQA, a reading comprehension-based Bangla question-answering dataset with various question-answer types. BanglaRQA consists of 3,000 context passages and 14,889 question-answer pairs created from those passages. The dataset comprises answerable and unanswerable questions covering four unique categories of questions and three types of answers. In addition, this paper also implemented four different Transformer models for question-answering on the proposed dataset. The best-performing model achieved an overall 62.42{%} EM and 78.11{%} F1 score. However, detailed analyses showed that the performance varies across question-answer types, leaving room for substantial improvement of the model performance. Furthermore, we demonstrated the effectiveness of BanglaRQA as a training resource by showing strong results on the bn{_}squad dataset. Therefore, BanglaRQA has the potential to contribute to the advancement of future research by enhancing the capability of language models. The dataset and codes are available at https://github.com/sartajekram419/BanglaRQA", }