
遇见数据集

leeroy-jankins/OWASP-Agentic-AI-Threats

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

OWASP代理AI威胁与缓解问答数据集是一个基于OWASP代理AI-威胁与缓解报告的合成指令式问答数据集。该数据集旨在支持与代理AI安全、大语言模型代理、多代理系统、威胁建模、自主工具使用、代理内存、身份风险、人在回路控制以及缓解策略相关的训练、微调、检索评估和领域特定问答用例。源文档重点关注基于大语言模型的代理,因为这类代理扩展了代理AI应用的规模、自主性、能力和风险。

The OWASP Agentic AI Threats and Mitigations Question Answering Dataset is a synthetic instruction-style question-answering dataset derived from the OWASP Agentic AI - Threats and Mitigations report. The dataset is designed to support training, fine-tuning, retrieval evaluation, and domain-specific question-answering use cases related to agentic AI security, large language model agents, multi-agent systems, threat modeling, autonomous tool use, agent memory, identity risks, human-in-the-loop controls, and mitigation playbooks. The source document focuses on agents based on large language models because LLM-based agents have expanded the scale, autonomy, capabilities, and risks of agentic AI applications.
提供机构:
leeroy-jankins
搜集汇总
数据集介绍
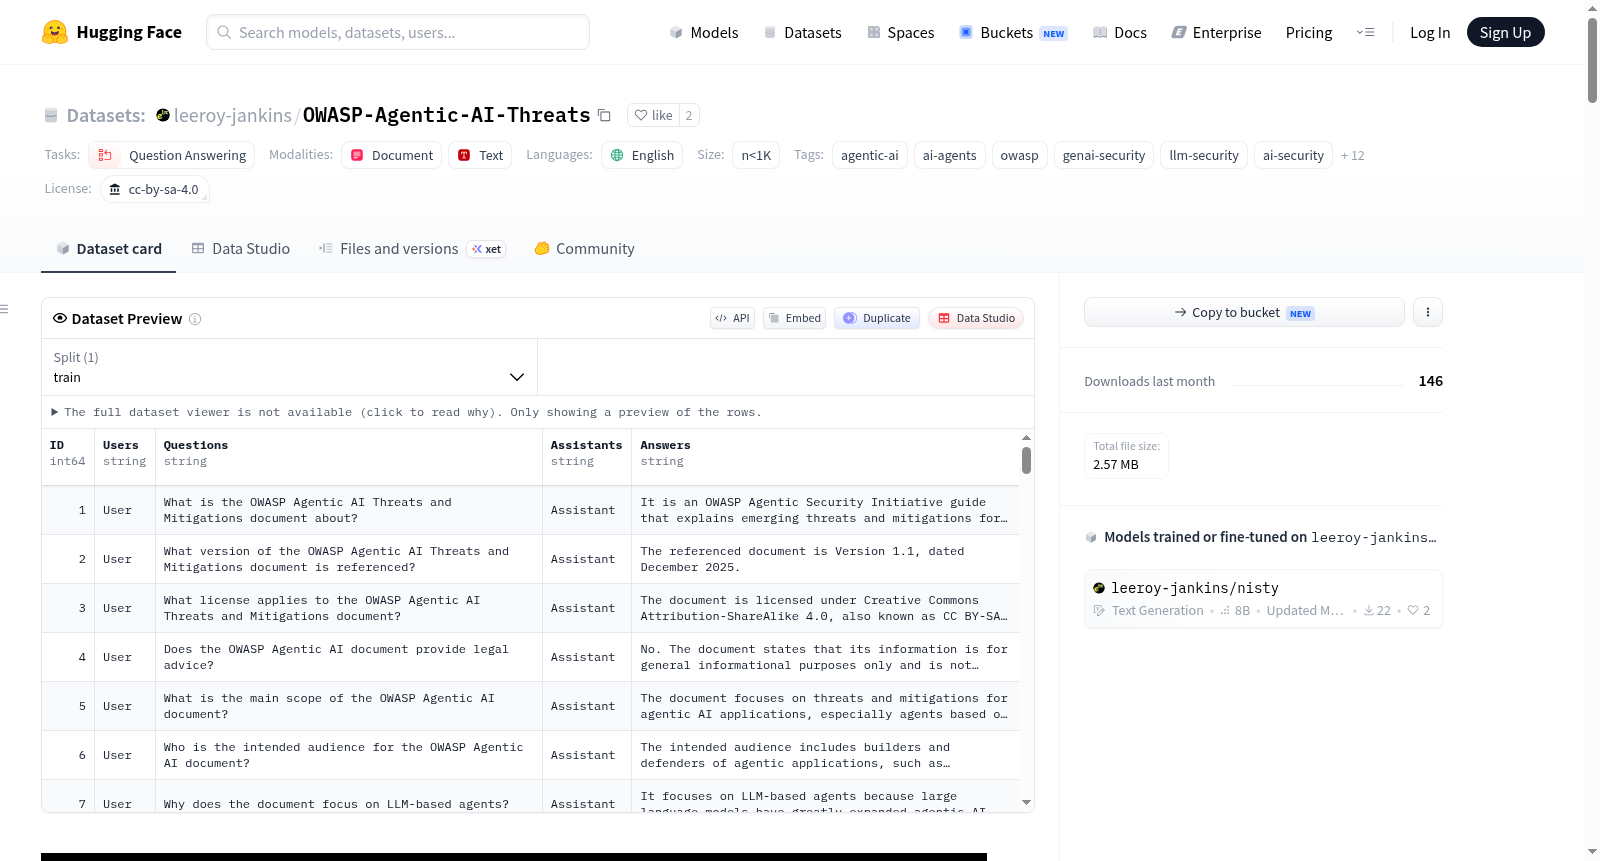
leeroy-jankins/OWASP-Agentic-AI-Threats 数据集图片
构建方式
该数据集源自OWASP《Agentic AI - Threats and Mitigations》报告(v1.1),采用合成生成方式构建。研究者以报告全文为知识基底,覆盖代理型人工智能概念、LLM基代理能力、记忆机制、工具调用、威胁分类(如内存投毒、工具滥用、身份欺骗等)及缓解策略等主题,通过问答对形式将原始内容进行提炼与重构。每一条记录均遵循{ID, Users, Questions, Assistants, Answers}的对话式结构,确保答案忠实于源文档但非原文照搬,最终形成包含100条记录的精炼指令型数据集。
特点
本数据集聚焦于代理型人工智能安全这一前沿领域,系统性封装了OWASP官方威胁模型与缓解方案,呈现出极高的领域专精性与权威性。其特点在于以简洁的问答形式覆盖从单智能体到多智能体架构的广泛威胁面,包括提示注入、工具滥用、级联幻觉攻击、身份欺骗、供应链风险等新兴攻击向量。数据集虽为合成生成,却严格遵循源文档的术语体系与分类逻辑,兼具教育性与实用性,适合用于安全知识蒸馏与模型对齐训练。
使用方法
该数据集适用于多种下游任务,可无缝集成至大语言模型的指令微调流程中,以强化模型对代理型AI安全领域的认知。研究者可将其作为检索增强生成(RAG)系统的评估基准,测试问答系统在安全威胁建模方面的精准度。此外,数据集还可用于构建网络安全教育工具、支持安全开发生命周期培训,或作为红队演练与风险管理的知识参考。使用时需注意其合成属性,在高风险场景下应结合官方源文档与专家评审,避免直接作为操作指南。
背景与挑战
背景概述
随着大语言模型的快速演进,以LLM为核心的智能体系统正以前所未有的自主性、工具调用能力和跨Agent协作能力重塑人工智能的应用边界。然而,这种能力的跃升也引入了全新的安全威胁面,传统安全框架难以覆盖智能体独有的攻击向量。在此背景下,OWASP(开放式Web应用程序安全项目)于2025年12月发布了《Agentic AI - Threats and Mitigations》报告1.1版,由OWASP GenAI安全项目旗下的Agentic安全倡议团队主导。基于该报告,研究团队构建了OWASP-Agentic-AI-Threats问答数据集,旨在为智能体AI安全领域提供高质量的教育与模型微调资源。该数据集以100条合成问答对的形式,系统覆盖了记忆投毒、工具滥用、身份欺骗、供应链攻击等核心威胁场景,为后续智能体安全研究奠定了知识基础,并在红队演练、威胁建模与安全培训等场景中展现出重要影响力。
当前挑战
该数据集所应对的核心领域挑战在于智能体AI系统自身安全边界的模糊性。与静态LLM不同,智能体具备执行工具调用、维护长期记忆和多Agent通信等能力,这催生了诸如级联幻觉攻击、意图破坏、Agent间通信投毒等全新威胁类型,传统Web应用或单模型安全方案无从应对。在构建过程中,团队面临多重困难:其一,智能体威胁分类学尚处早期,需从零构建统一威胁本体;其二,合成问答生成需在忠实于原始报告精简版(1.1版)与避免逐字复制之间取得平衡,以防过度简化或丢失关键上下文;其三,100条记录在覆盖广泛威胁场景的同时,受限于样本量,难以囊括所有攻击变体与缓解策略的细微差别,亦缺乏记录级形式化引用,这在高风险生产场景中构成潜在应用瓶颈。
常用场景
经典使用场景
该数据集最经典的使用场景在于对基于大语言模型的智能体系统进行安全问答训练与评估。研究者可借助这份由OWASP权威报告提炼的指令式问答数据,微调小型语言模型,使其掌握智能体人工智能领域中诸如记忆投毒、工具滥用、身份欺骗与供应链安全等关键威胁概念。同时,该数据集为检索增强生成系统的评测提供了高质量的领域专属基准,能够有效验证模型对智能体威胁建模与缓解策略的理解程度,是构建安全智能体教育工具与威胁建模演练的理想素材。
解决学术问题
该数据集系统性地回应了智能体人工智能安全研究中缺乏结构化、可训练知识库的学术困境。它围绕大语言模型智能体的新兴攻击面,如级联幻觉攻击、意图破坏与目标操纵、多智能体系统中的恶意智能体入侵等,将原本分散的威胁分类与缓解措施整合为可复用的问答对。这一成果推动了威胁建模方法论在智能体领域的规范化,为研究者在自动化安全评估、人机协作风险量化以及防御策略的实证比较等方面提供了坚实的基础支撑,显著降低了该交叉领域的研究门槛。
衍生相关工作
该数据集衍生出多个方向的经典工作。在模型层面,它被用于安全领域大语言模型的指令微调,催生了专注于智能体威胁识别的专用小模型。在评估体系层面,研究者基于其问答框架构建了合成基准测试,用以衡量检索系统对智能体安全文献的召回精度。此外,该数据集推动了交互式威胁建模工具的演进,使得自动化安全审查脚本能够结合数据中的问答逻辑,动态生成针对多智能体通信协议、凭证泄露及供应链攻击场景的测试用例,进一步丰富了智能体安全工程的可操作知识库。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

