
遇见数据集

us-caselaw-nm

收藏
Hugging Face2026-09-10 更新2026-09-11 收录
官方服务:

资源简介:

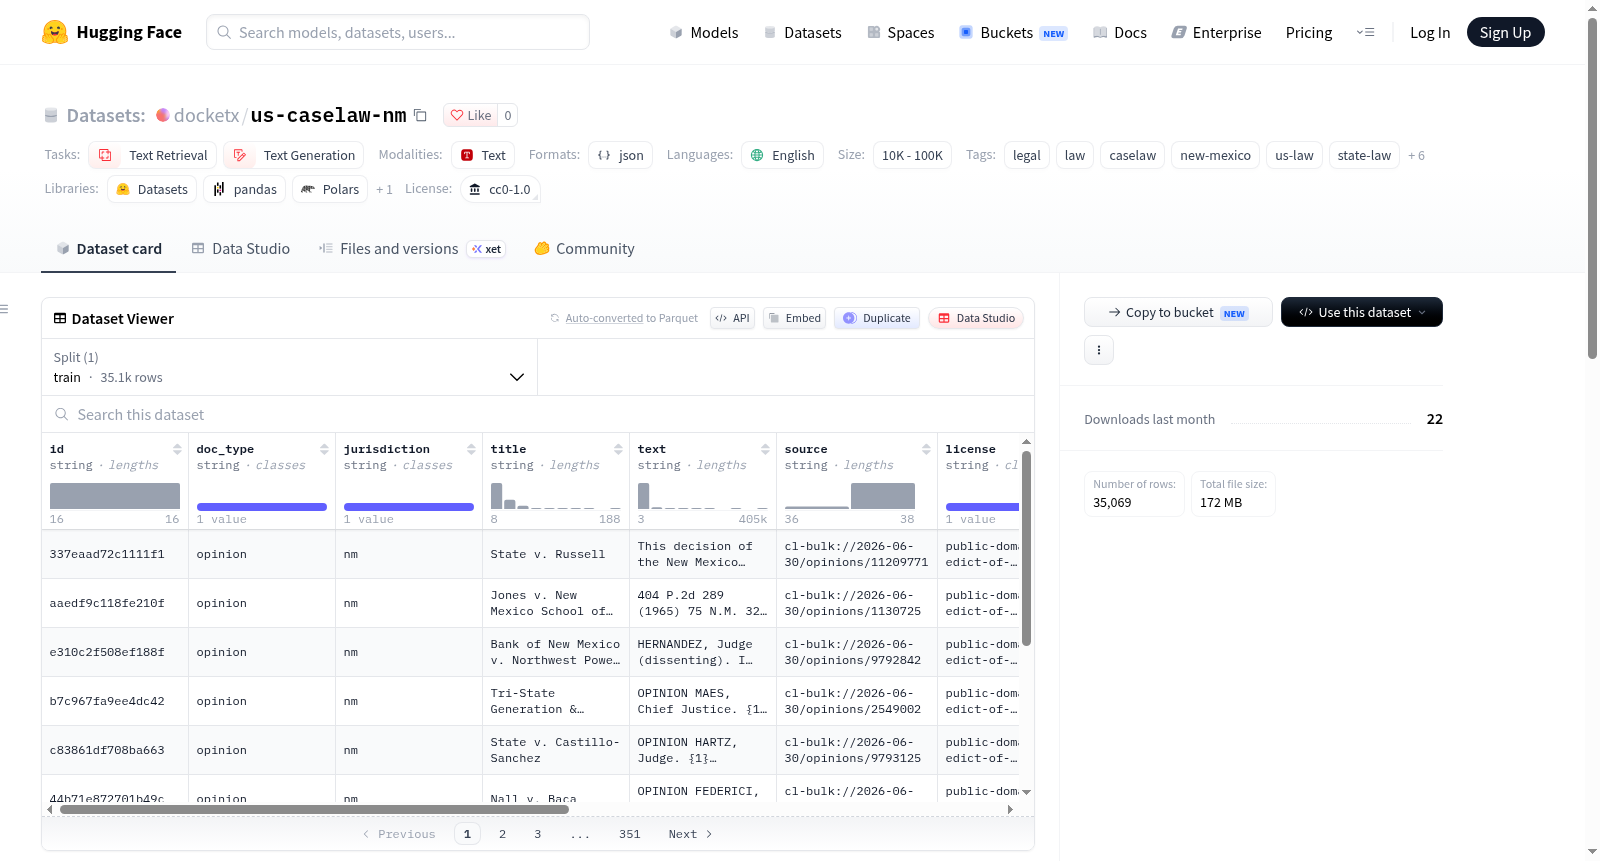
该数据集名为“新墨西哥州判例法”,包含35,069份新墨西哥州上诉法院意见全文。数据来源于Free Law Project/CourtListener在2026年6月30日的批量导出。法院覆盖范围包括新墨西哥州最高法院(nm)和新墨西哥州上诉法院(nmctapp)。数据集包含主意见和单独意见,排除了文本长度少于1字符的文档。数据采用docketx record v1格式,每行一个意见,字段包括:id、doc_type、jurisdiction、title、text、source、license、retrieved_at,以及citation、court、date和extra(包含CourtListener意见/案件ID、意见类型)。文本长度分布:30,172份文档(86.0%)包含2000+字符,2,694份(7.7%)包含200-1999字符,2,203份(6.3%)低于200字符。该数据集适用于文本检索和文本生成等任务,标注了法律、判例法、新墨西哥州、美国法律、州法、法院意见、公共领域、RAG、检索、法律NLP、法律研究等标签。许可协议为CC0 1.0。

The dataset is named New Mexico Case Law and contains 35,069 full-text opinions from the New Mexico appellate courts. The data originates from a bulk export of Free Law Project/CourtListener on June 30, 2026. Courts covered include the New Mexico Supreme Court (nm) and the New Mexico Court of Appeals (nmctapp). The dataset includes majority and separate opinions, excluding documents with text length less than 1 character. Data is in docketx record v1 format, one opinion per line, with fields: id, doc_type, jurisdiction, title, text, source, license, retrieved_at, as well as citation, court, date, and extra (containing CourtListener opinion/case ID, opinion type). Text length distribution: 30,172 documents (86.0%) contain 2000+ characters, 2,694 (7.7%) contain 200-1999 characters, and 2,203 (6.3%) contain fewer than 200 characters. The dataset is suitable for tasks such as text retrieval and text generation, and is tagged with labels including law, case law, New Mexico, US law, state law, court opinion, public domain, RAG, retrieval, legal NLP, legal research. License: CC0 1.0.
创建时间:
2026-09-07
搜集汇总
数据集介绍
us-caselaw-nm 数据集图片
构建方式
本数据集源自Free Law Project旗下CourtListener平台于2026年6月30日发布的批量导出数据,经系统化筛选与切片而成。构建过程严格限定新墨西哥州上诉法院的明确允许列表,涵盖 `nm` 与 `nmctapp` 两个法院标识,杜绝前缀匹配带来的范围泛化。原始文档中长度不足1字符者被剔除,最终保留35,069份上诉意见书全文,包括主意见与并存意见。切片结果经SHA-256哈希校验,确保数据完整性与可复现性。
使用方法
研究者和开发者可通过Hugging Face的`datasets`库便捷加载,调用`load_dataset("docketx/us-caselaw-nm")`即可获取数据。该数据集适用于文本检索、文本生成、法律问答及检索增强生成等任务。若需聚焦实质性判决,可依据`len(text)`字段进行过滤。数据以JSONL压缩格式存储,便于大规模处理与集成至法律自然语言处理流程。
背景与挑战
背景概述
新墨西哥州判例法数据集(us-caselaw-nm)源自自由法律项目(Free Law Project)下属CourtListener平台的公开批量导出数据,于2026年6月30日完成切片,涵盖新墨西哥州上诉法院(nm)和新墨西哥州上诉法院(nmctapp)的35,069份上诉意见书全文。该数据集由DocketRouter法律语料库团队构建,旨在为法律文本检索、生成及法律自然语言处理研究提供高质量的公开裁判文书资源。其核心研究问题在于如何以标准化格式组织并开放州级判例法,促进法律信息学领域的可复现研究。作为公共领域作品,该数据集对法律检索增强生成(RAG)和司法裁判分析具有重要支撑价值,推动了法律人工智能在州法层面的应用与发展。
当前挑战
该数据集所解决的领域问题在于州级判例法全文的细粒度检索与生成,其挑战源于法律文本的复杂性与多样性。构建过程中面临多重挑战:其一,数据来源的完整性与准确性需严格保障,须从CourtListener批量导出中精确切片,并确保法院标识符的显式白名单匹配,避免前缀误匹配导致数据污染。其二,文本长度分布不均,约6.3%的文档不足200字符,包含调卷令驳回、单行命令等简短记录,如何在保留完整公共记录的同时支持有效检索与建模成为难题。其三,格式标准化要求遵循docketx record v1规范,需统一字段结构并处理引证、法院、日期等元数据,确保跨数据集一致性,这增加了数据清洗与整合的复杂度。
常用场景
经典使用场景
在计算法学与法律信息检索领域,新墨西哥州判例全文数据集最经典的应用场景在于构建判例检索系统与法律问答引擎。研究者常将其作为语料库,训练基于稠密向量表示的检索模型,或直接用于检索增强生成(RAG)流水线,使语言模型能够依据真实判例文本回答法律问题。该数据集完整收录了35,069份新墨西哥州上诉法院意见书,涵盖主导意见与独立意见,且保留简短裁定与调卷令驳回记录,为检索模型提供了真实而多样的司法文本分布,尤其适合评估模型在长文本、专业术语密集场景下的语义匹配性能。
解决学术问题
该数据集有效缓解了法律自然语言处理研究中长期存在的州级判例资源匮乏问题。既往研究多聚焦联邦最高法院或少数大州判例,新墨西哥州等中小司法辖区的判例文本难以获取,导致法律检索与生成模型的跨辖区泛化能力评估受限。该数据集以公开记录为基础,提供格式统一、来源可溯的判例全文,使研究者能够系统探究司法意见的检索、摘要、引文解析及判决预测等任务,并推动跨州法律语言模型的公平比较。其公共领域属性亦消除了版权顾虑,为可复现研究奠定了数据基础。
实际应用
在法律实务中,该数据集可支撑律师与法官助理进行类案检索、裁判要旨提取与法律论证辅助。律所可基于此构建内部判例知识库,利用语义检索快速定位与新墨西哥州上诉法院相关争点最接近的先例。法律援助机构亦可借助检索增强生成系统,为当事人提供初步法律信息。此外,该数据集可用于开发面向公众的法律问答工具,帮助非专业用户理解上诉判决的推理逻辑。其涵盖的简短裁定与程序性命令,亦有助于实务人员追踪案件处理动态与法院程序性立场。
数据集最近研究
最新研究方向
在司法裁判文书公开化与法律信息学深度交融的当下,新墨西哥州判例法数据集(us-caselaw-nm)凭借其取自CourtListener公共记录的35,069份上诉法院意见全文,正成为法律检索增强生成(RAG)与判例推理研究的关键语料。前沿探索聚焦于将完整公共记录中不同篇幅的裁判文书统一嵌入检索-生成流水线,以捕捉certiorari驳回令、单行裁定等简短文书所承载的程序性信号,并借助docketx记录结构实现跨州判例的语义对齐。该数据集推动了对州级上诉法院裁判逻辑的细粒度建模,为法律问答、引证网络分析与判决预测提供了无版权障碍的实证基础,亦回应了公众对司法透明与算法可解释性的双重期待。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

