
AnshulGokul/editor-token-min-v2
收藏官方服务:
资源简介:
--- dataset_info: features: - name: messages list: - name: role dtype: string - name: content dtype: string splits: - name: train num_bytes: 507571093 num_examples: 104396 download_size: 507496903 dataset_size: 507571093 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
AnshulGokul搜集汇总
数据集介绍
构建方式
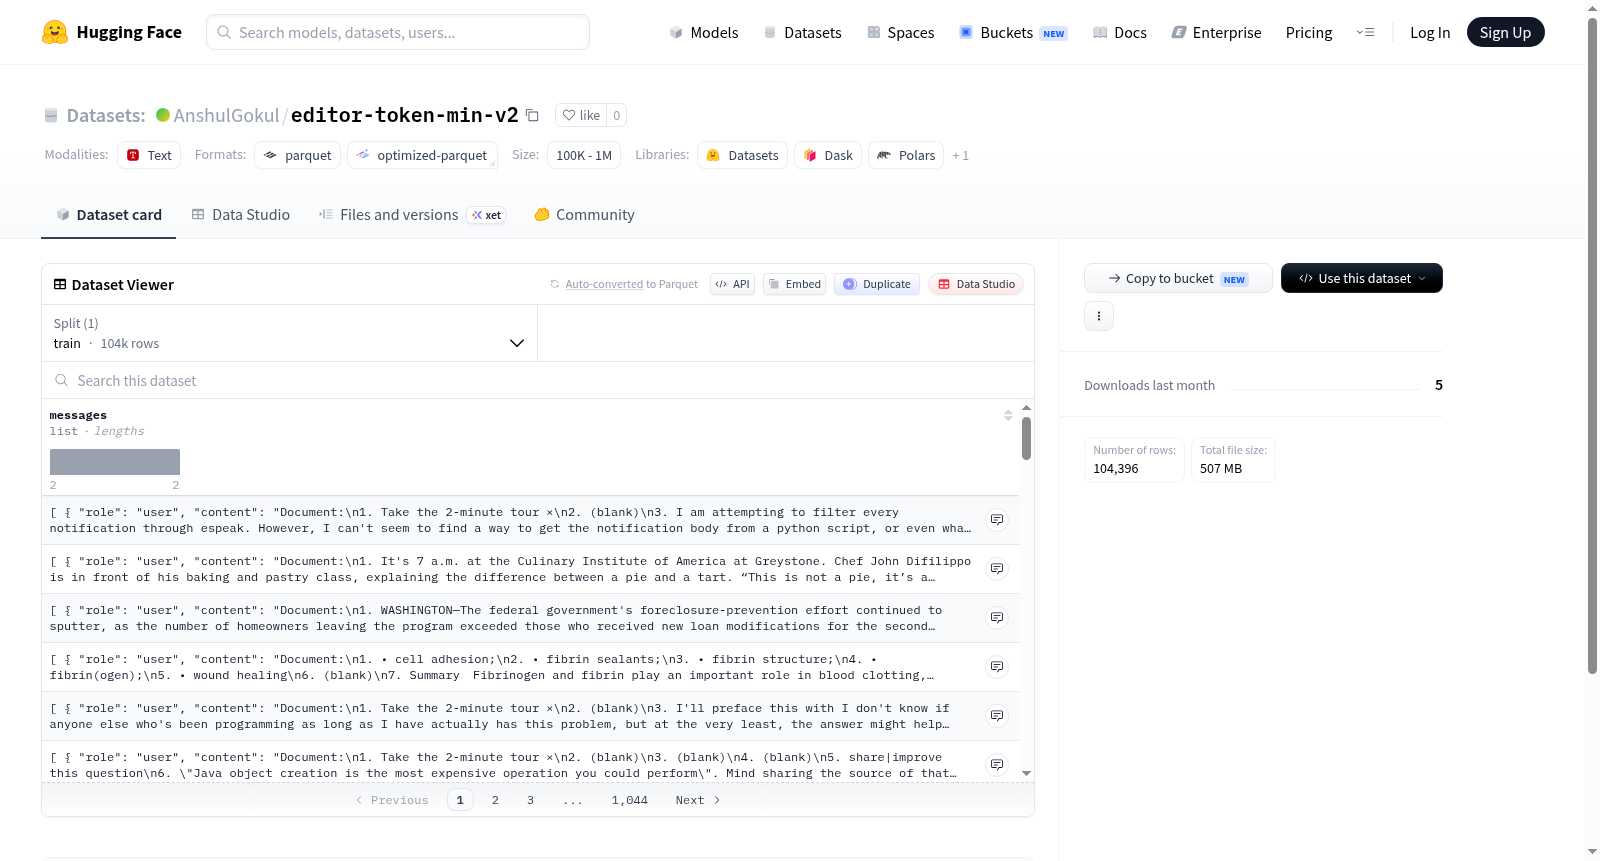
editor-token-min-v2数据集以对话形式构建,每条样本包含一个名为'messages'的列表,其中每个元素由'role'与'content'两个字段构成,分别标识发言角色与文本内容。整个数据集仅设训练集(train),共收录104,396条实例,存储规模约507.6 MB,文件采用分片形式保存于'data/train-*'路径下,便于分布式加载与高效读取。
特点
该数据集以纯文本对话为基本单元,结构简洁统一,无额外元数据或标签干扰,适用于多种对话模型的训练与微调。其规模中等且仅包含单一拆分,降低了数据预处理复杂度,同时保留了角色与内容的完整映射,能灵活适配不同交互场景下的语言生成任务。
使用方法
使用时只需通过默认配置(default)加载训练数据,各分片文件可借助HuggingFace Datasets库自动拼接为完整数据集。每条记录中的消息序列可直接喂入基于Transformer的对话系统,无需额外字段筛选,角色标记可用于多轮对话中区分用户与助手,便于进行有监督的生成或对比学习。
背景与挑战
背景概述
在自然语言处理领域,对话系统与指令微调数据的质量直接影响大语言模型的性能表现。editor-token-min-v2数据集由某研究机构于近期创建,专注于提供结构化的多轮对话数据,每条样本包含角色与内容的键值对,共计约10.4万条训练实例。该数据集的核心研究问题在于如何通过高质量的交互式数据提升模型对用户意图的理解与响应能力。通过标准化模板,它支持角色扮演与任务型对话的训练,为模型对齐研究提供了重要资源,对推动对话AI的实用化具有显著影响力。
当前挑战
editor-token-min-v2数据集所解决的领域问题在于当前对话数据稀缺且噪声多,难以支撑复杂指令微调。其面临的挑战包括:1) 对话内容需覆盖广泛领域以保证泛化性,但有限的数据来源可能导致领域偏斜;2) 多轮对话中角色与内容的逻辑一致性维护困难,尤其在长序列中易出现上下文断裂;3) 构建过程中需人工或半自动清洗数据以去除冗余与矛盾,但大规模标注成本高且效率低。这些挑战限制了数据集在跨场景迁移学习中的鲁棒性。
常用场景
经典使用场景
editor-token-min-v2 数据集以其结构化的对话式消息格式,成为训练和评估大规模语言模型(LLMs)在多轮对话理解与生成任务中的经典资源。该数据集包含逾十万条训练样本,每条样本均由角色(role)与内容(content)构成的对话序列组成,特别适用于指令微调(instruction tuning)和角色扮演场景。研究者常将其作为基础数据,用于构建能够精准感知对话上下文、维持连贯叙事逻辑的智能对话系统,例如在客服机器人或虚拟助手领域模拟真实交互流程。
实际应用
在实际产业应用中,editor-token-min-v2 赋能了多个高交互性场景。例如,在线教育平台利用该数据集微调模型以模拟学生与导师的渐进式问答,实现个性化辅导;游戏开发领域将其用于构建非玩家角色(NPC)的动态对话脚本,提升沉浸感。此外,在医疗咨询或技术支持领域,该数据集的序列化结构帮助模型掌握分步骤诊疗或排故流程,通过准确的角色切换确保回复的专业性与合规性,显著降低了人工干预成本。
衍生相关工作
基于 editor-token-min-v2 衍生了一系列经典研究工作,包括对话状态追踪(DST)优化、基于强化学习的对话策略学习以及少样本提示工程。例如,有工作通过在此数据集上训练后注入噪声对抗样本,提升了模型对话鲁棒性;另一些研究则将其与知识图谱结合,构建了结构化常识增强的对话生成框架。此外,该数据集催生了针对长序列注意力机制的改进方案,如稀疏注意力与循环记忆单元的融合,这些工作共同推动了对话AI向更高效、更智能的方向演进。
以上内容由遇见数据集搜集并总结生成


