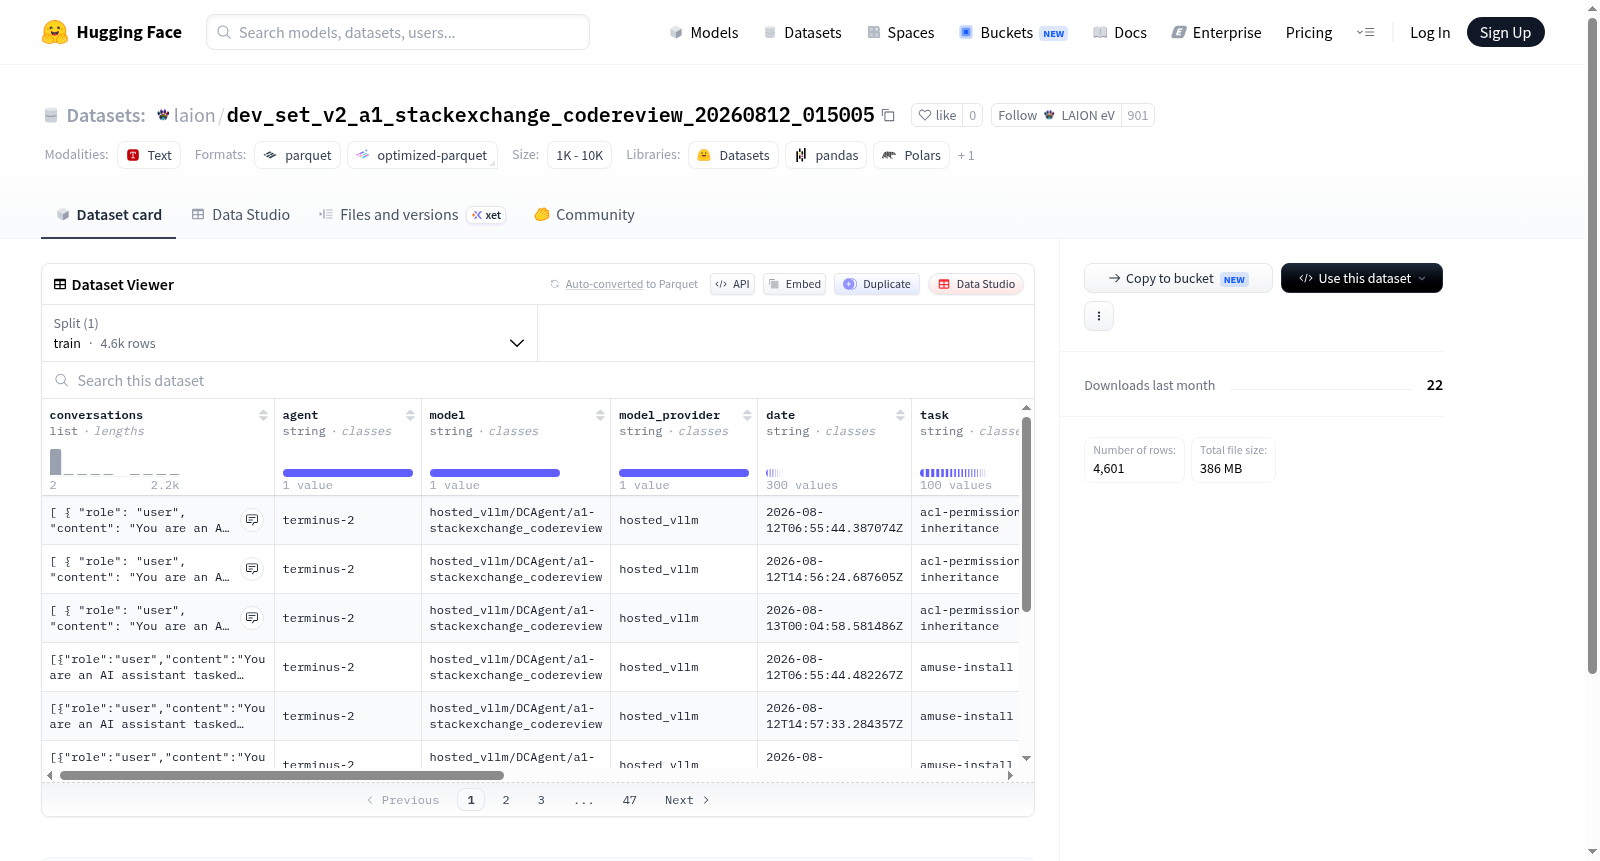
dev_set_v2_a1_stackexchange_codereview_20260812_015005
收藏资源简介:
该数据集包含多轮对话记录,每条数据由多个对话回合组成,每个回合包含角色(role)和内容(content)。此外,还记录了代理(agent)、模型(model)、模型提供商(model_provider)、日期(date)、任务(task)、轮次(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及追踪来源(trace_source)。数据集共有 4601 个训练样本,总大小约 459 MB。适用于对话系统训练、任务型代理行为分析、AI 交互追踪等场景。
This dataset contains multi-turn dialogue records, each consisting of multiple dialogue turns, with each turn including role and content. Additionally, it records agent, model, model_provider, date, task, episode, run_id, trial_name, result, verifier_output, and trace_source. The dataset has 4601 training samples and a total size of approximately 459 MB. It is suitable for dialogue system training, task-oriented agent behavior analysis, AI interaction tracking, etc.
数据集概述
基本信息
- 数据集名称:dev_set_v2_a1_stackexchange_codereview_20260812_015005
- 来源平台:Hugging Face
- 提供方:LAION(Large-scale Artificial Intelligence Open Network)
内容描述
该数据集专注于Stack Exchange平台上的代码审查(Code Review) 相关对话数据,版本为dev_set_v2,具体生成时间为2026年8月12日。
数据规模
- 总数据集大小:459,391,690 字节(约438 MB)
- 下载大小:386,474,326 字节(约369 MB)
- 训练集样本数:4,601 条
- 数据划分:仅包含 train(训练)划分
数据特征(字段说明)
每条数据包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
| conversations | 列表(含 role 和 content 两个子字段) | 对话内容,role 标识角色(如用户/助手),content 为对话文本 |
| agent | 字符串 | 智能体标识 |
| model | 字符串 | 使用的模型名称 |
| model_provider | 字符串 | 模型提供方 |
| date | 字符串 | 日期信息 |
| task | 字符串 | 任务类型 |
| episode | 字符串 | 对话轮次/回话编号 |
| run_id | 字符串 | 运行标识 |
| trial_name | 字符串 | 试验名称 |
| result | 字符串 | 结果信息 |
| verifier_output | 字符串 | 验证器输出 |
| trace_source | 字符串 | 追踪来源 |
用途
该数据集适用于代码审查领域的对话系统训练、模型评估、多轮对话生成等自然语言处理任务,也可用于研究代码质量评估和审查流程的自动化。