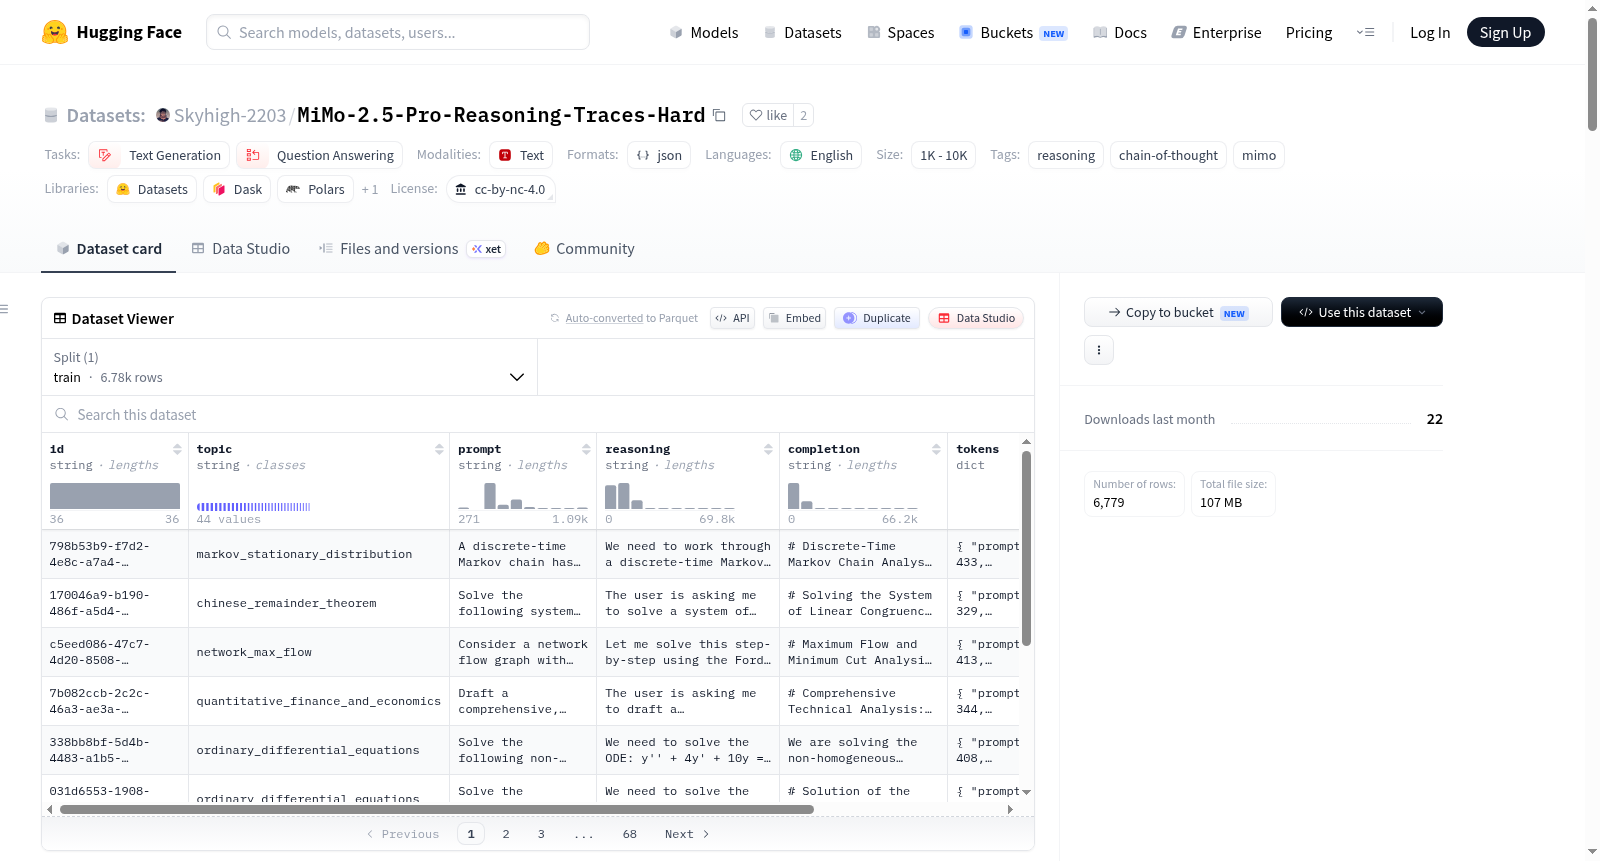
MiMo-2.5-Pro-Reasoning-Traces-Hard
收藏资源简介:
MiMo-2.5-Pro-HardReasoning-Traces 是一个大规模推理轨迹数据集,专门设计用于支持复杂推理任务的研究与开发。该数据集由 MiMo-v2.5-Pro 模型生成,包含 4,713 个专家级提示(prompts)及其对应的完整逐步推理过程(reasoning traces),涵盖 32 个不同的学术与技术主题。数据规模方面,总计包含 27,104,198 个 token,其中提示部分占 1,771,339 个 token,完成部分占 25,332,859 个 token,推理过程专门占用了 16,542,264 个 token。每个数据条目采用结构化格式,包含唯一标识符(id)、主题分类(topic)、问题陈述(prompt)、完整的逐步推理轨迹(reasoning)、最终答案或解决方案(completion)、token 使用统计(tokens)以及生成时间戳(timestamp)。数据集覆盖的主题广泛且深入,主要包括五大领域:数学(如特征值/乔丹形、拉格朗日乘数法等)、物理(如量子谐振子、相对论/天体物理学等)、计算机科学(如算法/复杂度、数据结构等)、生命科学(如生物化学、遗传学/生物信息学等)以及其他领域(如哲学/认识论、博弈论等)。适用于文本生成、问答、思维链推理、知识蒸馏、多输入多输出(MIMO)建模以及智能体轨迹分析等任务,尤其适合需要硬推理(hard-reasoning)能力的学术和技术场景。数据集采用 CC BY-NC 4.0 许可协议,作者为 Vaishant Sai Sambu。
MiMo-2.5-Pro-HardReasoning-Traces is a large-scale reasoning traces dataset specifically designed to support research and development of complex reasoning tasks. Generated by the MiMo-v2.5-Pro model, it contains 4,713 expert-level prompts and their corresponding complete step-by-step reasoning traces, covering 32 distinct academic and technical topics. In terms of overall scale, the dataset totals 27,104,198 tokens, with 1,771,339 tokens allocated to the prompt section, 25,332,859 tokens to the completion section, and 16,542,264 tokens specifically used for the reasoning processes. Each data entry follows a structured format, including a unique identifier (id), topic classification (topic), problem statement (prompt), complete step-by-step reasoning traces (reasoning), final answer or solution (completion), token usage statistics (tokens), and generation timestamp (timestamp). The dataset covers a wide and in-depth range of topics, primarily divided into five major fields: mathematics (e.g., eigenvalues/Jordan form, Lagrange multiplier method), physics (e.g., quantum harmonic oscillator, relativity/astrophysics), computer science (e.g., algorithm complexity, data structures), life sciences (e.g., biochemistry, genetics/bioinformatics), and other fields (e.g., philosophy/epistemology, game theory). It is applicable to tasks such as text generation, question answering, chain-of-thought reasoning, knowledge distillation, multiple-input multiple-output (MIMO) modeling, and AI agent trajectory analysis, and is particularly suitable for academic and technical scenarios requiring hard-reasoning capabilities. The dataset is licensed under CC BY-NC 4.0, and its author is Vaishant Sai Sambu.
数据集概述
MiMo-2.5-Pro-HardReasoning-Traces 是一个大型推理数据集,包含 6,779 个专家级提示及其完整的推理轨迹,覆盖 44 个学术与技术主题。该数据集使用 MiMo-v2.5-Pro 模型生成,每个条目包含逐步推理链和最终答案,适用于训练和评估语言模型的推理能力。
数据集统计
| 指标 | 数值 |
|---|---|
| 总条目数 | 6,779 |
| 独特主题数 | 44 |
文件结构
reasoning_data_1.jsonl— 条目 1-2000reasoning_data_2.jsonl— 条目 2001-4000reasoning_data_3.jsonl— 条目 4001-6000reasoning_data_4.jsonl— 条目 6001-6779generate_dataset.py— 数据集生成脚本test_api.py— API 连接测试test_concurrent.py— 并发测试
数据格式
每个 JSONL 文件中的条目包含以下字段:
id— 唯一标识符topic— 主题类别prompt— 问题或问题描述reasoning— 完整的逐步推理轨迹completion— 最终答案或解决方案tokens— 包含prompt_tokens、completion_tokens、total_tokens、reasoning_tokens的字典timestamp— ISO 8601 时间戳
覆盖主题(32 个类别)
数学
matrix_eigenvalues_jordan— 特征值、特征向量、Jordan 标准型calculus_lagrange_multipliers— 多变量约束优化ordinary_differential_equations— 带边界条件的二阶常微分方程linear_programming_simplex— 单纯形法线性规划markov_stationary_distribution— 马尔可夫链与平稳分布diophantine_equations— 基于扩展欧几里得算法的线性丢番图方程chinese_remainder_theorem— 线性同余方程组elliptic_curves— 有限域上的椭圆曲线combinatorics_burnsides_lemma— Burnside 引理与组合计数network_max_flow— Ford-Fulkerson 算法与最小割
物理
quantum_harmonic_oscillator— 量子力学、升降算符、不确定原理relativity_and_astrophysics— 广义相对论、宇宙学、黑洞thermodynamics_and_statistical_mechanics— 熵、配分函数、相变particle_and_nuclear_physics— QED、QCD、核物理、费曼图wave_physics_and_acoustics— 波动方程、多普勒效应、衍射、超材料
计算机科学
algorithms_and_complexity— NP 完全性、近似算法、随机算法data_structures_and_databases— B+ 树、LSM 树、MVCC、CRDTdistributed_systems_and_cloud— 共识协议、CAP 定理、分布式存储cryptography_and_security— 零知识证明、后量子密码、侧信道攻击compilers_and_programming_languages— SSA、垃圾回收、类型系统artificial_intelligence_and_ml— Transformer、RLHF、扩散模型、GANoperating_systems_and_networking— TCP 拥塞控制、虚拟内存、调度control_systems_and_information_theory— 卡尔曼滤波、信道容量、注水算法distributed_system_architecture— 大规模系统设计(遥测数据采集)automata_and_formal_languages— DFA/NFA、图灵机、泵引理、乔姆斯基层级neural_network_architecture_and_training— 反向传播、Transformer、注意力、RLHF、扩散模型
生命科学
biochemistry_and_molecular_biology— GPCR、代谢通路、光合作用genetics_and_bioinformatics— 序列比对、GWAS、转座因子organic_and_physical_chemistry— NMR 光谱、催化机制、分子轨道
信号处理与数值方法
signal_processing_and_transforms— FFT、小波、FIR/IIR 滤波器、压缩感知numerical_methods_and_monte_carlo— 蒙特卡洛积分、Runge-Kutta、共轭梯度
统计学与推断
bayesian_statistics_and_inference— MCMC、变分推断、贝叶斯因子、高斯过程
电气工程
electrical_circuit_analysis— 基尔霍夫定律、戴维南等效、晶体管放大器
量子计算
quantum_computing_and_circuits— 量子隐形传态、Shor 算法、纠错
其他
analytical_philosophy_and_epistemology— 意识、自由意志、认识论game_theory_and_decision_theory— 纳什均衡、机制设计、拍卖理论linguistics_and_formal_semantics— 句法、音系学、形式语义学quantitative_finance_and_economics— Black-Scholes、DSGE 模型、投资组合优化portfolio_optimization_and_finance— Markowitz、Black-Litterman、Delta 对冲、Kelly 准则geometry_and_topology— Gauss-Bonnet 定理、基本群、同调graph_theory_and_coloring— 色数、平面性、谱图理论number_theory_and_rsa— RSA、素性测试、整数分解、椭圆曲线partial_differential_equations— 热方程、波动方程、有限元法、Navier-Stokes
提示类型
- 过程型(约45%) — 动态生成的问题,包含随机化参数(矩阵、容量、系数等),每个提示唯一。
- 理论型(约55%) — 基于模板的提示,从约 400 个高级学术主题池中随机选取子主题,并注入随机缩放参数确保唯一性。
使用方式
Python 加载 python import json
entries = [] for i in range(1, 5): with open(f"reasoning_data_{i}.jsonl", "r") as f: for line in f: entries.append(json.loads(line))
print(f"Loaded {len(entries)} entries")
Hugging Face Datasets 加载 python from datasets import load_dataset
ds = load_dataset("Skyhigh-2203/MiMo-2.5-Pro-HardReasoning-Traces")
生成配置
- 模型:
mimo-v2.5-pro - 并发线程数:10-15(流水线模式)
- max_tokens:4096-16384
- Temperature:0.7
- 自动重试:最多 10 次,带指数退避(针对 429/超时)
许可协议
CC BY-NC 4.0(Creative Commons Attribution-NonCommercial 4.0 International)。允许非商业目的的分享和改编,需注明原作者 Vaishant Sai Sambu。商业用途请联系作者。