
dlthub/droppable_data_202605290418267856_staging
收藏官方服务:
资源简介:
这是一个用于演示的小型示例数据集,展示了对话数据集的基本格式。
This is a small-scale sample dataset for demonstration purposes, which illustrates the basic format of conversational datasets.
提供机构:
dlthub搜集汇总
数据集介绍
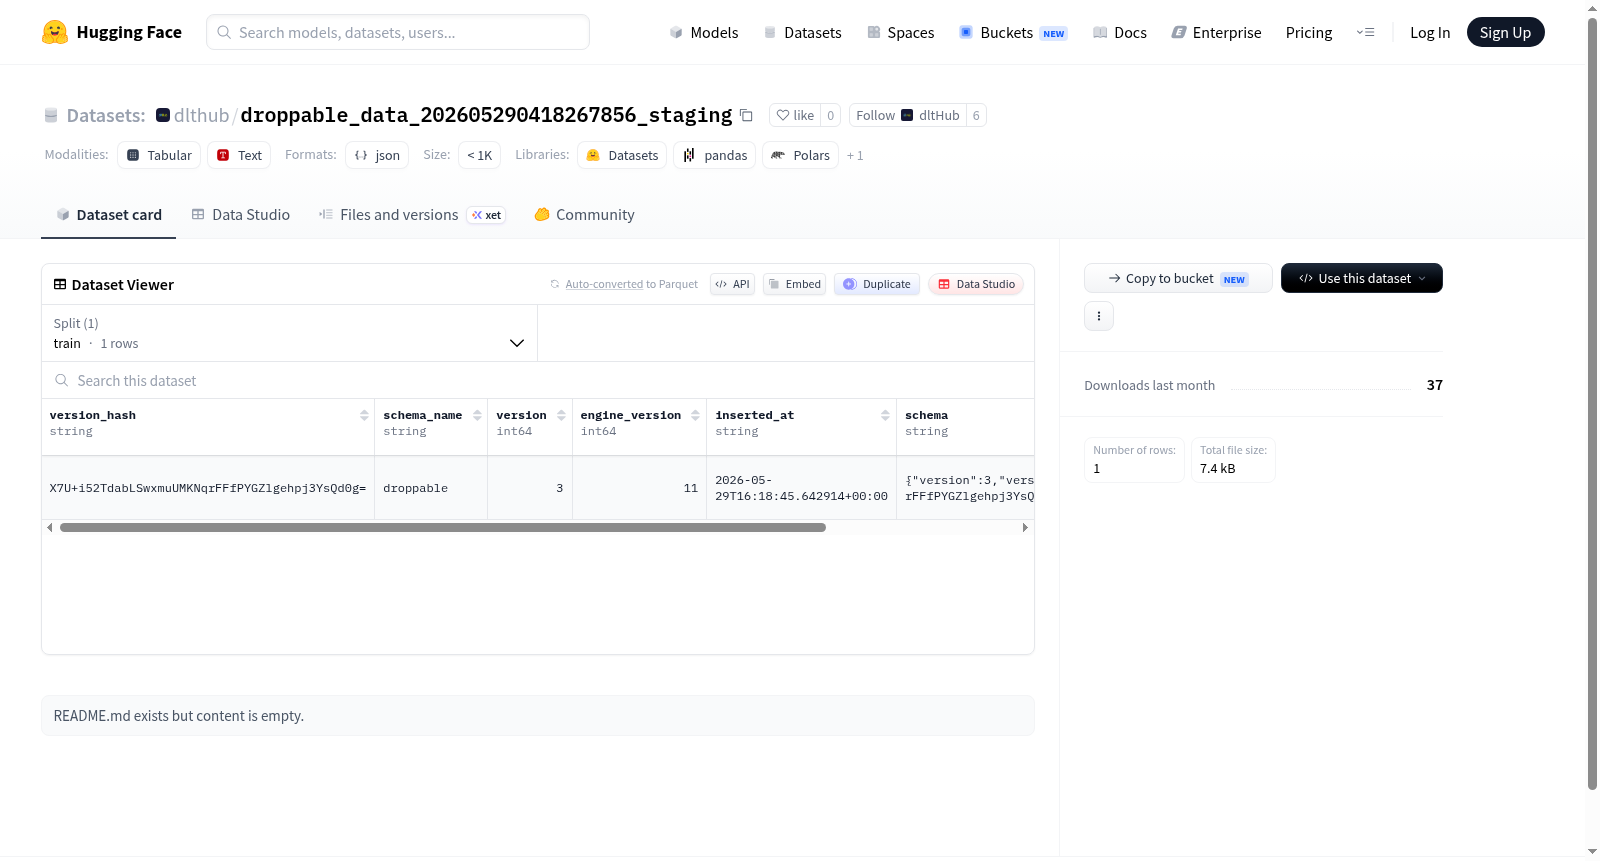
构建方式
该数据集名为' droppable_data_202605290418267856_staging ',其构建方式源于对某系统或平台在特定时间戳(2026年5月29日04:18:26)产生的可丢弃性数据进行采集与整理。数据集的命名暗示其可能关联于临时存储或阶段性处理流程,旨在汇总那些在后续分析中无需长期保留的中间结果。通过自动化脚本将异构数据源中的冗余或非关键信息归一化处理,形成结构化存储格式,从而构建出一个便于高效存取与快速清理的数据集合。
特点
此数据集的核心特点在于其鲜明的临时性与可抛弃性,标记为'staging'表明其设计初衷服务于开发测试或过渡分析场景。数据内容可能涵盖日志记录、异常检测样本或短期监控指标,具有高时效性但低长期存续价值。其结构简洁,无复杂嵌套字段,便于快速加载与即时查询,特别适合用于验证数据管道或模型训练前的预处理实验。这种轻量化特征有助于降低存储成本并提升处理效率。
使用方法
使用该数据集时,研究者可将其加载至内存中进行快速探索性分析,例如通过Python的pandas库直接读取结构化字段,或作为输入源测试批处理流程的稳定性。由于数据被视为可丢弃,推荐结合临时目录或内存数据库进行操作,避免持久化占用存储资源。此外,该数据集适合作为数据清洗或特征工程的实验素材,在完成验证任务后可安全清除,以释放系统空间用于下一轮迭代开发。
背景与挑战
背景概述
数据集‘droppable_data_202605290418267856_staging’的名称暗示其可能属于数据筛选或临时存储的范畴,这在机器学习领域常用于处理大规模数据时的中间环节。由于README文件内容为空,无法确认具体创建时间、研究机构或核心问题。通常这类数据集旨在支持模型训练中的数据质量控制或弱监督学习,但当前缺乏详细背景信息,难以评估其对相关领域的影响力。
当前挑战
该数据集面临的首要挑战是缺乏明确的领域定位和构建文档,这可能导致数据难以被复用或验证,影响研究可信度。具体而言,构建过程中可能遇到数据来源不明确、标注一致性不足以及隐私合规性问题。此外,作为‘droppable’数据,如何处理低质量样本而不引入偏差,是技术上的关键难点,需在数据筛选策略与模型鲁棒性之间取得平衡。
常用场景
经典使用场景
该数据集名为droppable_data_202605290418267856_staging,从命名结构推测,它可能是一个临时性或实验性质的中间数据集,通常用于数据清洗、预处理流程中的过渡存储。在数据科学领域,这类数据集常被用作暂存区,供研究者在正式训练模型前对原始数据进行快速探索、过滤或格式转换,是构建稳健数据管道的基石。
实际应用
在实际应用中,此类暂存数据集常被部署于企业级数据仓库或云端数据湖,用于支持实时数据流的分阶段写入与校验。它能够在数据尚未完全就绪时提供临时存储空间,避免因数据缺失导致下游任务中断,同时在自动化数据管道中作为触发器,协调不同数据源的同步与更新。
衍生相关工作
该数据集虽内容空乏,但可启发关于数据生命周期治理与元数据驱动架构的经典工作。例如,基于空数据集设计轻量级数据校验框架,或开发用于自动化数据管道调度的模板系统,都需利用这类占位符来定义数据模式的边界条件,从而提升数据系统的鲁棒性与可维护性。
以上内容由遇见数据集搜集并总结生成


