
遇见数据集

cds-jb/synthweb-qwen3-8b-multiscale-inference

收藏
Hugging Face2026-05-21 更新2026-05-31 收录
官方服务:

资源简介:

synthweb-qwen3-8b-multiscale-inference 是一个基于Qwen3-8B模型对FineWeb前缀进行延续生成的探测问题数据集,专门设计用于评估方法M(一种激活预言技术),该方法旨在从语言模型的隐藏状态中恢复尚未在表面文本中显现的信息。数据集包含591,541个探测,覆盖了37,042个不同的源文档,每个文档生成最多16个探测,分为五个范围组:单词(word)、长度(lens)、句子(sentence)、段落(paragraph)和整体(whole)。每个探测都设计为满足两个关键约束:HARD-FROM-TEXT(仅从互补文本中难以自信地得出答案)和EASY-FROM-LATENT(答案应是源模型在分割点隐藏状态中已承诺的内容)。数据集通过Claude Haiku 4.5模型生成,包括探测问题、目标响应、错误但合理的答案等字段,并进行了回答者和评判员评分,以评估探测的难度和有效性。数据集的目的是为方法M提供评估基准,确保探测测量的是隐藏状态恢复能力,而非文本阅读能力。

synthweb-qwen3-8b-multiscale-inference is a probing question dataset generated by continuing the FineWeb prefix based on the Qwen3-8B model, specifically designed to evaluate Method M, an activation probing technique that aims to recover information that has not yet appeared in the surface text from the hidden states of language models. The dataset contains 591,541 probing instances covering 37,042 distinct source documents, with up to 16 probing instances generated per document, divided into five scope groups: word, length, sentence, paragraph, and whole. Each probing instance is designed to satisfy two key constraints: HARD-FROM-TEXT (the answer can hardly be confidently deduced solely from the complementary text) and EASY-FROM-LATENT (the answer should be the information that the source model has already committed to in its hidden states at the segmentation point). The dataset is generated via the Claude Haiku 4.5 model, including fields such as probing questions, target responses, and plausible but incorrect answers, and has been scored by respondents and judges to evaluate the difficulty and validity of the probing instances. The purpose of this dataset is to provide an evaluation benchmark for Method M, ensuring that the probing measurements target the capability of hidden state recovery rather than text reading ability.
提供机构:
cds-jb
搜集汇总
数据集介绍
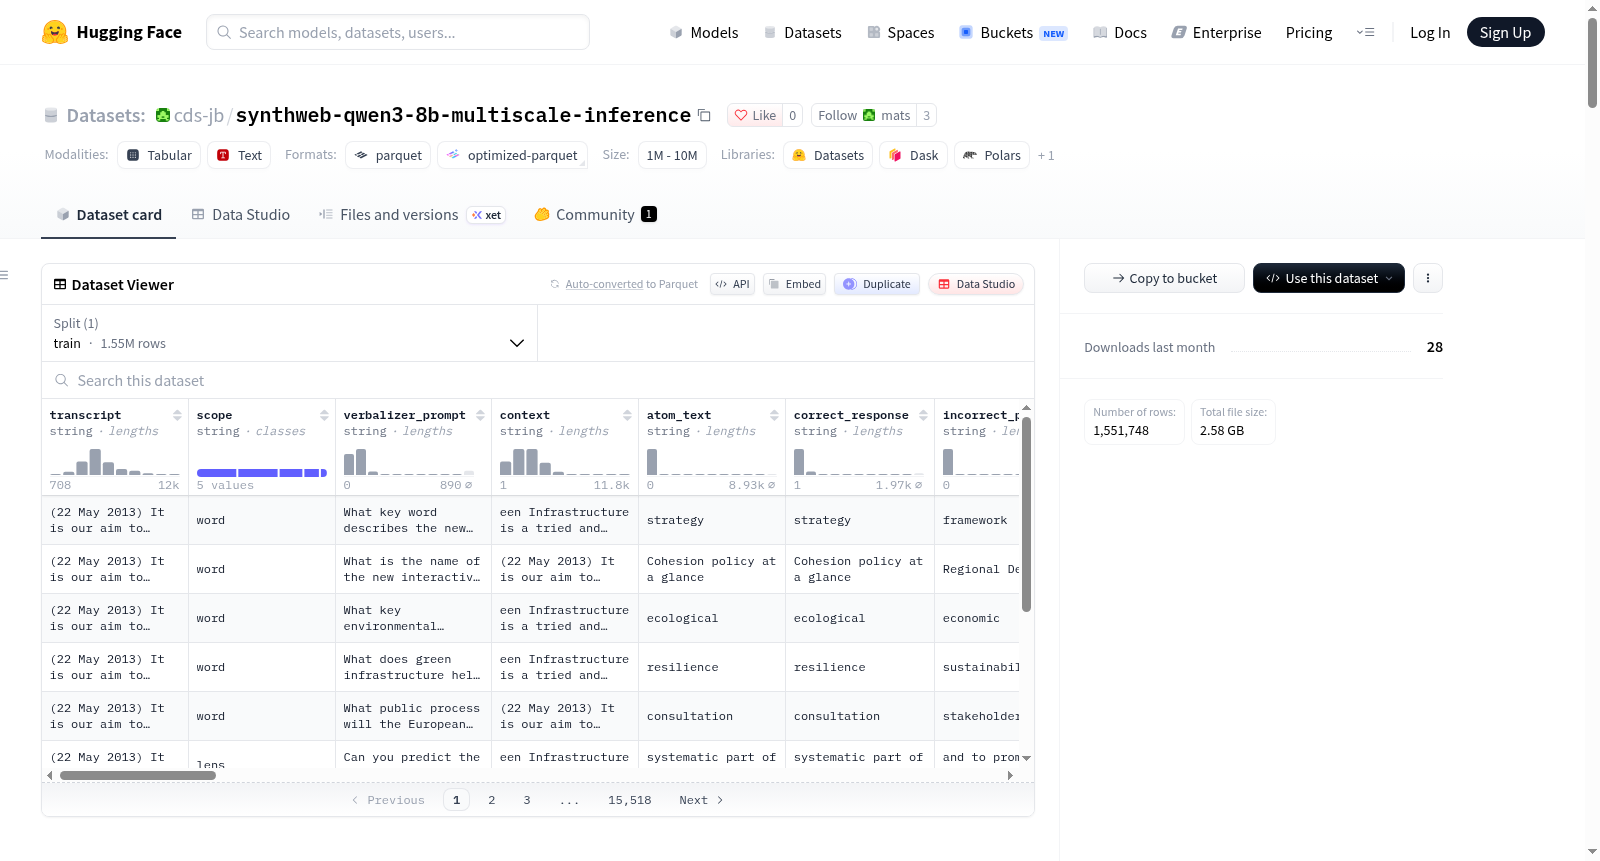
cds-jb/synthweb-qwen3-8b-multiscale-inference 数据集图片
构建方式
该数据集以cds-jb/synthweb-qwen3-8b中Qwen3-8B对FineWeb前缀的续写文本为基底,采用程序化生成与Claude Haiku 4.5扩展思维模式相结合的方式,在每条文档的字符级切分边界处构造探测问题。构建过程以多尺度槽位分配为框架,每条源文档分配16个探测槽,涵盖词、镜头、句子、段落与整篇五个粒度,由Haiku一次性选定四个字符级切分偏移,并生成目标原子、言语化提示、错误但合理的备选答案及协同性检验等字段,最终汇聚为1,551,748条探测样本,覆盖97,160份源文档。
特点
数据集的核心特征在于同时满足“文本难解”与“潜空间易解”的双重约束。每条探测均附带bb_answer_score_max字段,以五轮随机答案采样中的最高评判分数作为难度过滤信号,低分者即文本不可直接推导,构成评估激活预言机方法M的理想基准。数据粒度跨越词级到整篇级,并配有典型性标签、分布检验、协同性检验及错误合理答案,支持对比评分。分数分布呈明显双峰,约35.2%为困难探测,19.4%为容易探测,为方法评估提供了层次分明的难度谱系。
使用方法
该数据集主要用于评测激活预言机方法M从语言模型隐藏状态中解码自然语言内容的能力。使用者可依据bb_answer_score_max筛选困难探测,将模型M的预测与atom_text对比,并借助incorrect_plausible_answer进行对比评分。词与镜头探测可采用精确匹配或令牌对数概率本地评分,句子、段落与整篇探测则依赖Haiku答案器与评判器打分。数据集按轮次增量构建,支持通过score_probes.py脚本以线性成本增加采样轮数以降低评分噪声,便于在统一框架下开展可复现的基准测试。
背景与挑战
背景概述
激活探针方法旨在解读大语言模型隐状态中尚未表面化的信息,但其效能评估长期缺乏受控基准。synthweb-qwen3-8b-multiscale-inference数据集由cds-jb团队于2025年基于Qwen3-8B模型构建,以FineWeb前缀及其续写文本为素材,生成超过155万条探测问题,系统检验隐状态内容能否被解码为自然语言。该数据集区分文本难解与隐状态易解两类约束,为激活预言机方法提供了严格的评测框架,推动了可解释性研究从定性观察向定量验证的范式转变。
当前挑战
该数据集所应对的核心挑战在于设计同时满足“文本难解”与“隐状态易解”的探测问题。前者要求答案无法从补全侧文本中直接推断,后者要求答案确实编码于源模型隐状态中。构建过程中,需从跨兄弟续写分布中采样并生成多样化的探测目标,覆盖词、片段、句子、段落及半文档五个粒度,且每个原子须满足协同约束。此外,需生成合理的错误备选答案以支持对比评分,并校准难度水平,确保探针既不过于浅显也不过于晦涩。自动化生成中的JSON解析异常亦需稳健修复,以维持高成品率。
常用场景
经典使用场景
在语言模型可解释性研究中,探究模型隐状态所编码的语义信息长期占据核心地位。synthweb-qwen3-8b-multiscale-inference数据集即为评估“激活预言机”(activation oracle)方法而构建的大规模探针基准,其经典使用场景在于检验解码器能否从Qwen3-8B在文本分界点处的隐状态中,精准还原出尚未显现在表层文本中的目标内容。每一行探针均要求模型基于隐状态推断出另一侧的字词、句子或段落,从而系统衡量隐状态所含信息的可解码程度。
衍生相关工作
围绕该数据集,已衍生出一系列经典工作,包括基于对比评分的探针筛选方法、利用典型性标签分析模型分布偏移的研究,以及面向多轮次增量构建的复现流水线。其上游合成数据与多尺度推理框架亦被拓展至其他模型族,催生了跨架构隐状态可比性的探索,并为后续激活预言机基准的标准化提供了可借鉴的模板。
数据集最近研究
最新研究方向
在语言模型可解释性研究向内部表征探测纵深推进的背景下,该数据集聚焦于激活预言机(activation oracle)这一前沿范式,旨在检验外部方法能否从模型隐状态中解码出尚未浮现于表层文本的信息。其构建逻辑回应了当前学界对隐状态编码内容与行为可预测性之间关系的核心关切,通过跨词、镜头、句子、段落与全文五个粒度层级设计约155万条探测样本,并以盲测回答分数作为文本可推导性的过滤信号,为区分真实隐状态增益与单纯文本推断提供了操作化基准。该工作与稀疏自编码器、表征工程及链式思维忠实性等热点议题形成呼应,其规模化的多尺度探测框架有望推动隐状态解码方法的标准化评估,并对模型内部信念追踪与安全监控研究产生实质性影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

