
MathArena/brokenarxiv-training_outputs_original
收藏官方服务:
资源简介:
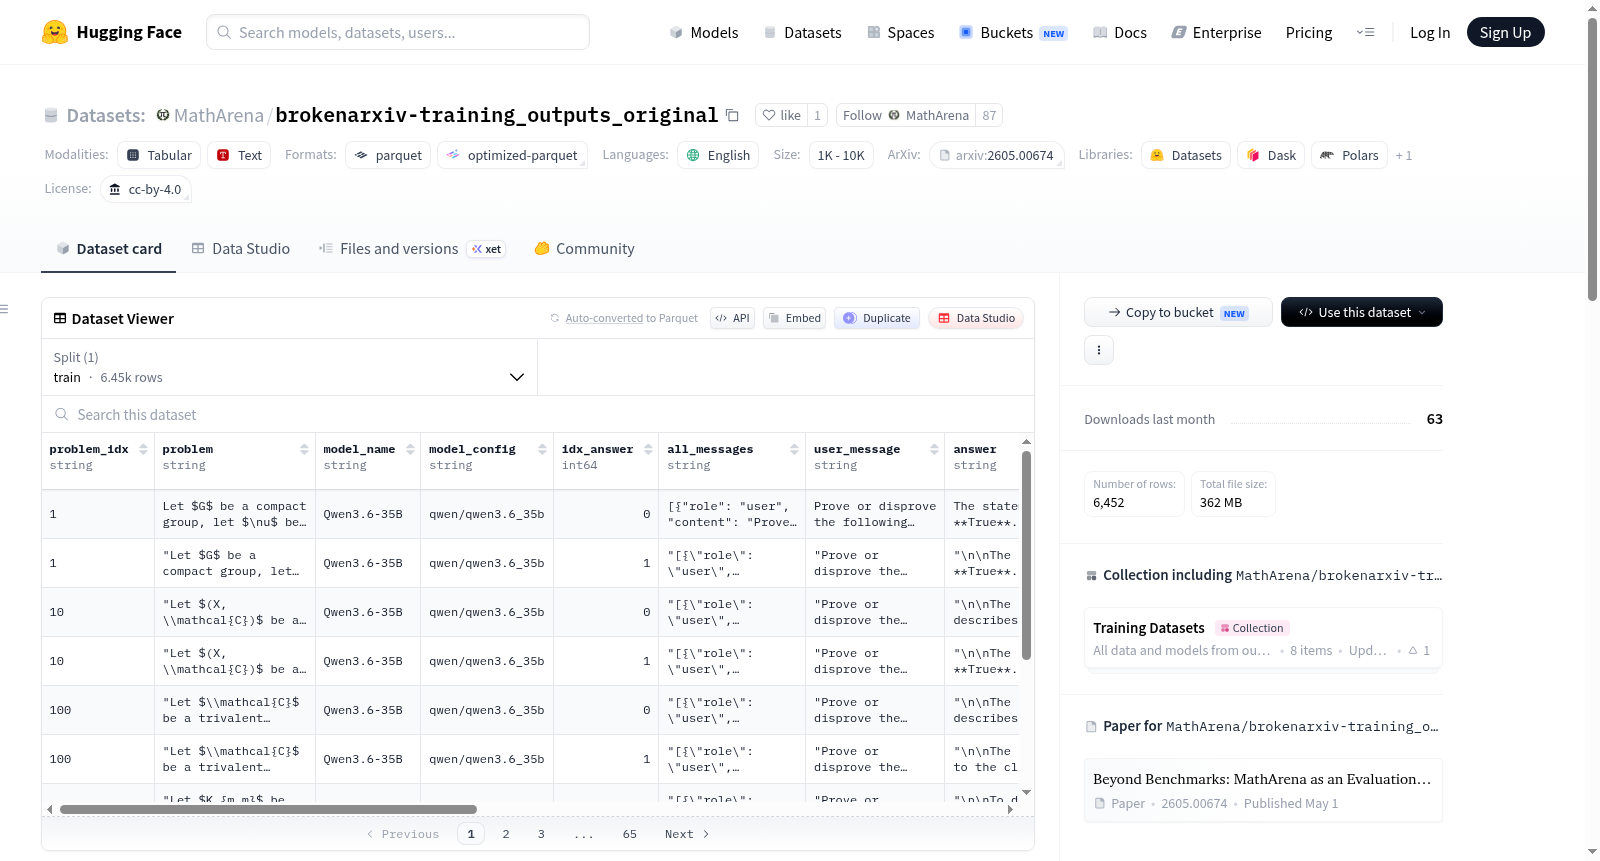
该数据集包含从过去的ArXiv文章中生成的训练数据,以及由Qwen3.6-35B生成的输出。具体来说,该数据集包含模型对问题(即原始陈述在https://huggingface.co/datasets/MathArena/brokenarxiv-training/中是否正确)的答案。因此,预期答案始终为“True”。
This dataset contains training data generated from historical arXiv articles, along with outputs produced by Qwen3.6-35B. Specifically, this dataset includes the model's answers to the query: whether the original statement is correct as referenced in the dataset at https://huggingface.co/datasets/MathArena/brokenarxiv-training/. As such, the expected answer is always "True".
提供机构:
MathArena搜集汇总
数据集介绍
构建方式
该数据集源自数学领域的大规模语言模型评估平台MathArena,专门收集了Qwen3.6-35B模型对过去ArXiv论文中数学命题的判定结果。构建过程以公开数据集brokenarxiv-training为基础,将每篇论文中的原始命题作为输入,要求模型判断其正确性,预期答案均为“True”。每个样本不仅包含模型生成的回答,还详细记录了输入输出令牌数、API调用成本等元数据,并通过MathArena解析器提取模型回答,与标准答案进行比对,形成包含正确性标签的完整训练数据集。
使用方法
该数据集适用于训练或微调数学推理模型,特别是在判断数学命题真伪的任务上。研究者可直接使用problem字段作为输入,将answer字段作为输出进行监督学习,或利用all_messages字段进行多轮对话训练。cost与token字段可用于优化模型推理效率,而correct字段则直接提供评估标签。数据集以default配置名提供,训练数据位于data/train-*路径下,采用CC-BY-4.0许可协议,便于学术研究与开放共享。
背景与挑战
背景概述
在大型语言模型(LLM)的数学推理能力评估领域,标准化的基准测试虽能反映模型的部分性能,却难以捕捉其在真实学术文献中的推理稳健性。为此,来自苏黎世联邦理工学院(ETH Zurich)的Jasper Dekoninck、Nikola Jovanović、Tim Gehrunger等研究者于2026年创建了brokenarxiv-training_outputs_original数据集。该数据集是MathArena评估平台的核心组件之一,专注于探究LLM对ArXiv数学论文中原始陈述正确性的判别能力。通过收集Qwen3.6-35B模型对来自历史ArXiv文章的问题回答,它揭示了模型在验证数学命题真伪时的表现,为推动LLM在学术推理领域的可靠性研究提供了关键资源,并对自动化数学内容审核与辅助研究具有重要启示。
当前挑战
该数据集面临的首要挑战在于其核心的领域问题:LLM在数学推理中常出现逻辑悖论、计算错误或对复杂证明的误解,导致对数学命题真伪的判断失准。这要求模型不仅具备基础数学知识,还需理解严谨的证明结构和隐含的数学公理。其次,构建过程中遇到诸多挑战,包括从海量ArXiv文章中自动提取并标准化问题与答案,确保跨领域数学表述的一致性;模型输出解析的鲁棒性,即从冗长文本中准确抽取答案并与真实标签比对;以及计算成本与效率的平衡,因生成数据需调用昂贵API,且每问题平均成本需精确控制以避免资源浪费。
常用场景
经典使用场景
在数学推理与自然语言处理的交叉领域中,该数据集被广泛应用于评估和训练大型语言模型(LLMs)对定理陈述真伪判别的能力。其经典使用方式是基于ArXiv论文中的数学问题,要求模型输出对原始命题正确性的判断,由于标准答案恒为“True”,这一设定为衡量模型在数学语境下的忠实性与鲁棒性提供了理想测试床。研究者通过分析模型生成的回答、解析后答案与标准答案的一致性,以及令牌消耗与成本等元信息,能够系统性地剖析模型在形式化数学推理任务中的表现优劣。
解决学术问题
该数据集解决了学术界在数学语言模型评估中缺乏高质量、可复现训练数据与系统性评测基准的难题。它不仅提供了来源于真实ArXiv论文的数学问题,还涵盖了多轮对话记录、令牌使用统计和API成本等精细化元数据,使得研究者能够深入探究模型在数学推理中的计算效率、成本效益与输出准确性之间的权衡关系。这一资源极大地推动了数学与自然语言处理交叉领域的研究进展,为设计更高效、更可信的数学推理语言模型奠定了数据基础,也促进了学术界对模型推理能力和潜在偏差的深入理解。
实际应用
在实际应用层面,该数据集的核心价值在于支撑自动化数学审稿系统、智能学术助手以及教育辅助工具的开发。例如,它可用于训练能够自动验证论文中数学论证正确性的AI代理,辅助期刊编辑和审稿人进行初步筛选。此外,基于该数据集培育的模型能够嵌入到学术搜索引擎或知识管理平台中,实现对数学文献的智能解析与事实核查,从而提升科研工作效率。在在线教育场景中,该数据集也能帮助构建自动判题与反馈系统,为学生提供实时、准确的数学问题解答评估。
数据集最近研究
最新研究方向
该数据集聚焦于数学领域大语言模型的鲁棒性与可靠性评估,通过追踪Qwen3.6-35B模型对过往arXiv数学论文中命题真伪的判别能力,为探究前沿模型在形式化数学推理中的局限性提供了关键训练资源。结合MathArena平台对数学基准测试的革新理念,此数据集的构建呼应了当前学术界对LLM在复杂数学任务中逻辑自洽性与事实一致性的深切关注,其包含的细粒度成本与正确性标注,为剖析模型决策过程、优化数学推理的神经符号融合方法开辟了新的实验路径,对推动可信赖人工智能在科学文献验证中的落地具有深远意义。
以上内容由遇见数据集搜集并总结生成


