2026-08-17-post-action-retrospection
收藏资源简介:
本数据集是一个合成训练数据,通过名为“post_action_retrospection”的多阶段流水线生成。流水线包含多个阶段,分别对应数据构建的不同步骤:从最初的分块宪法(stage_1_chunk_constitution)、编写场景(stage_2_write_scenarios)、去重场景(stage_3_dedupe_scenarios)、起草提示(stage_4_draft_prompts)、修订提示(stage_5_revise_prompts)、起草第一轮对话(stage_6_draft_first_turn)、修订第一轮对话(stage_7_revise_first_turn)、编写后续轮次(stage_8_write_followup)、起草反思(stage_9_draft_reflection)、修订反思(stage_10_revise_reflection),最终导出为 SFT 格式(stage_11_export_sft)。每个阶段的数据均以 JSONL 文件形式保存,可作为独立配置加载。数据集使用了特定的宪法(claude_distilled_09_principles_mid_20260804)作为指导原则,生成日期为 2026-08-17。该数据集适用于训练模型进行情境对话、事后反思生成或相关任务的监督微调。
This dataset is a synthetic training data generated through a multi-stage pipeline called post_action_retrospection. The pipeline includes multiple stages corresponding to different steps of data construction: from initial chunk constitution (stage_1_chunk_constitution), writing scenarios (stage_2_write_scenarios), deduplicating scenarios (stage_3_dedupe_scenarios), drafting prompts (stage_4_draft_prompts), revising prompts (stage_5_revise_prompts), drafting first turn (stage_6_draft_first_turn), revising first turn (stage_7_revise_first_turn), writing follow-up turns (stage_8_write_followup), drafting reflection (stage_9_draft_reflection), revising reflection (stage_10_revise_reflection), and finally exporting to SFT format (stage_11_export_sft). Data from each stage is saved as JSONL files and can be loaded as independent configurations. The dataset uses a specific constitution (claude_distilled_09_principles_mid_20260804) as guiding principles, and the generation date is 2026-08-17. This dataset is suitable for supervised fine-tuning of models for contextual dialogue, post-hoc reflection generation, or related tasks.
数据集概述
该数据集是 post_action_retrospection 合成数据流水线的阶段性快照集合,用于可恢复的生成缓存。
基本信息
| 属性 | 值 |
|---|---|
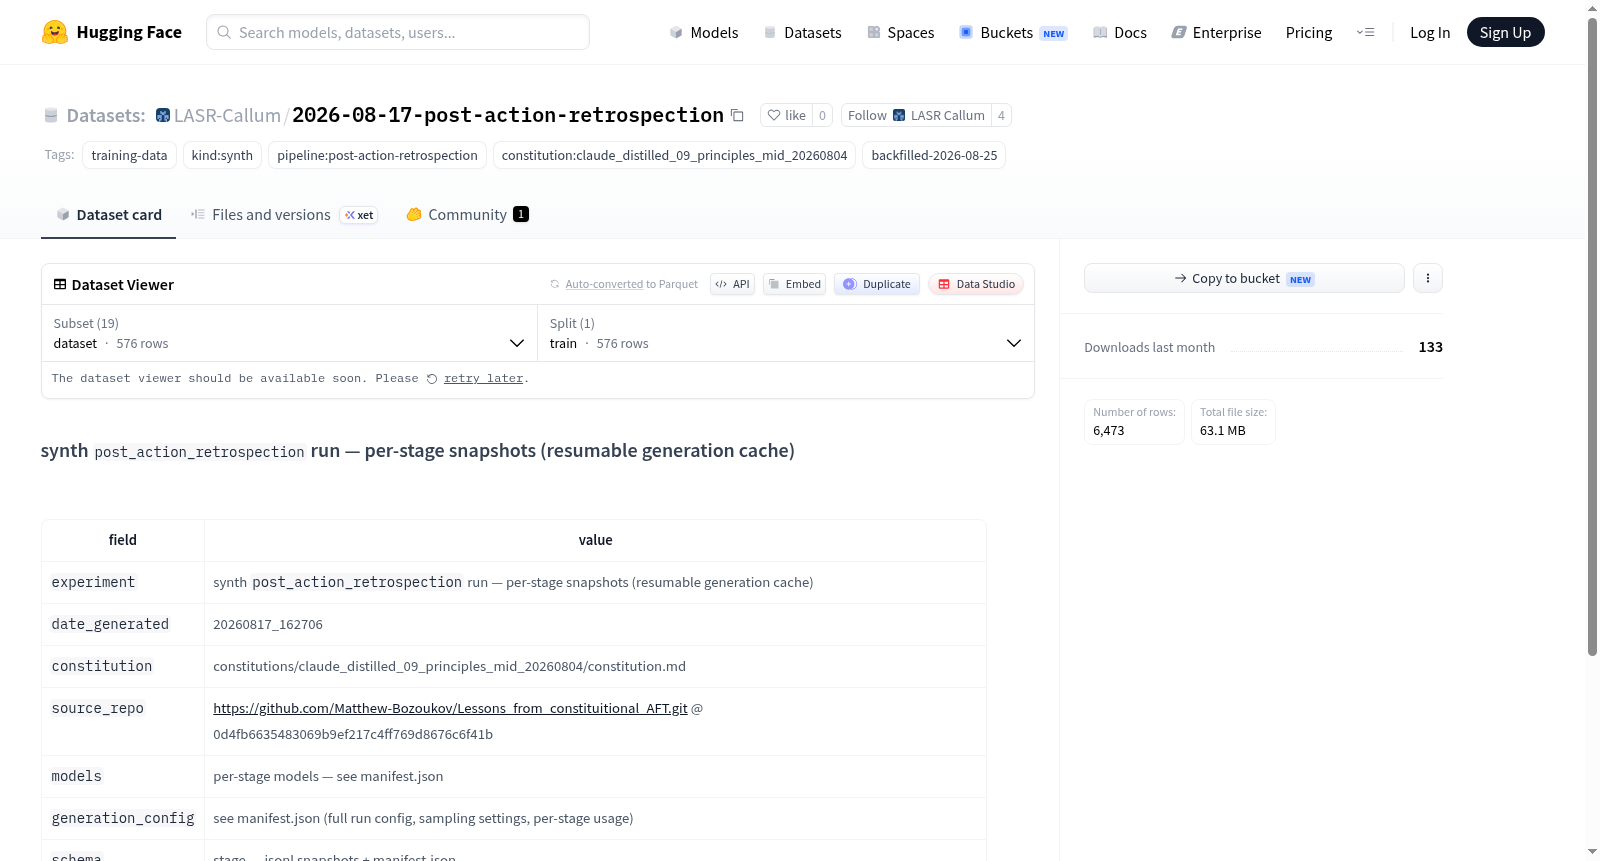
| 实验名称 | synth post_action_retrospection run — per-stage snapshots (resumable generation cache) |
| 生成日期 | 20260817_162706 |
| 数据标签 | training-data, kind:synth, pipeline:post-action-retrospection, constitution:claude_distilled_09_principles_mid_20260804, backfilled-2026-08-25 |
| 来源仓库 | https://github.com/Matthew-Bozoukov/Lessons_from_constituitional_AFT.git @ 0d4fb6635483069b9ef217c4ff769d8676c6f41b |
配置与数据文件
数据集包含多种配置,对应流水线不同阶段的 JSONL 快照文件:
| 配置名称 | 数据文件 |
|---|---|
| dataset | dataset.jsonl |
| stage_1_chunk_constitution | stages/stage_1_chunk_constitution.jsonl |
| stage_2_write_scenarios | stages/stage_2_write_scenarios.jsonl |
| stage_3_dedupe_scenarios | stages/stage_3_dedupe_scenarios.jsonl |
| stage_4_draft_prompts | stages/stage_4_draft_prompts.jsonl |
| stage_4_draft_prompts.partial | stages/stage_4_draft_prompts.partial.jsonl |
| stage_5_revise_prompts.partial | stages/stage_5_revise_prompts.partial.jsonl |
| stage_5_revise_prompts | stages/stage_5_revise_prompts.jsonl |
| stage_6_draft_first_turn.partial | stages/stage_6_draft_first_turn.partial.jsonl |
| stage_6_draft_first_turn | stages/stage_6_draft_first_turn.jsonl |
| stage_7_revise_first_turn | stages/stage_7_revise_first_turn.jsonl |
| stage_7_revise_first_turn.partial | stages/stage_7_revise_first_turn.partial.jsonl |
| stage_8_write_followup.partial | stages/stage_8_write_followup.partial.jsonl |
| stage_8_write_followup | stages/stage_8_write_followup.jsonl |
| stage_9_draft_reflection | stages/stage_9_draft_reflection.jsonl |
| stage_9_draft_reflection.partial | stages/stage_9_draft_reflection.partial.jsonl |
| stage_10_revise_reflection.partial | stages/stage_10_revise_reflection.partial.jsonl |
| stage_10_revise_reflection | stages/stage_10_revise_reflection.jsonl |
| stage_11_export_sft | stages/stage_11_export_sft.jsonl |
数据模式与来源
- 模式:
stage_<n>_<name>.jsonl快照文件及manifest.json(包含完整运行配置、采样设置和各阶段使用情况) - 宪法文件:
constitutions/claude_distilled_09_principles_mid_20260804/constitution.md - 生成命令:
uv run synth run --config configs/data/synth/post_action_retrospection.yaml - 模型:各阶段使用的模型详见
manifest.json