
nihiluis/argureviews
收藏官方服务:
资源简介:
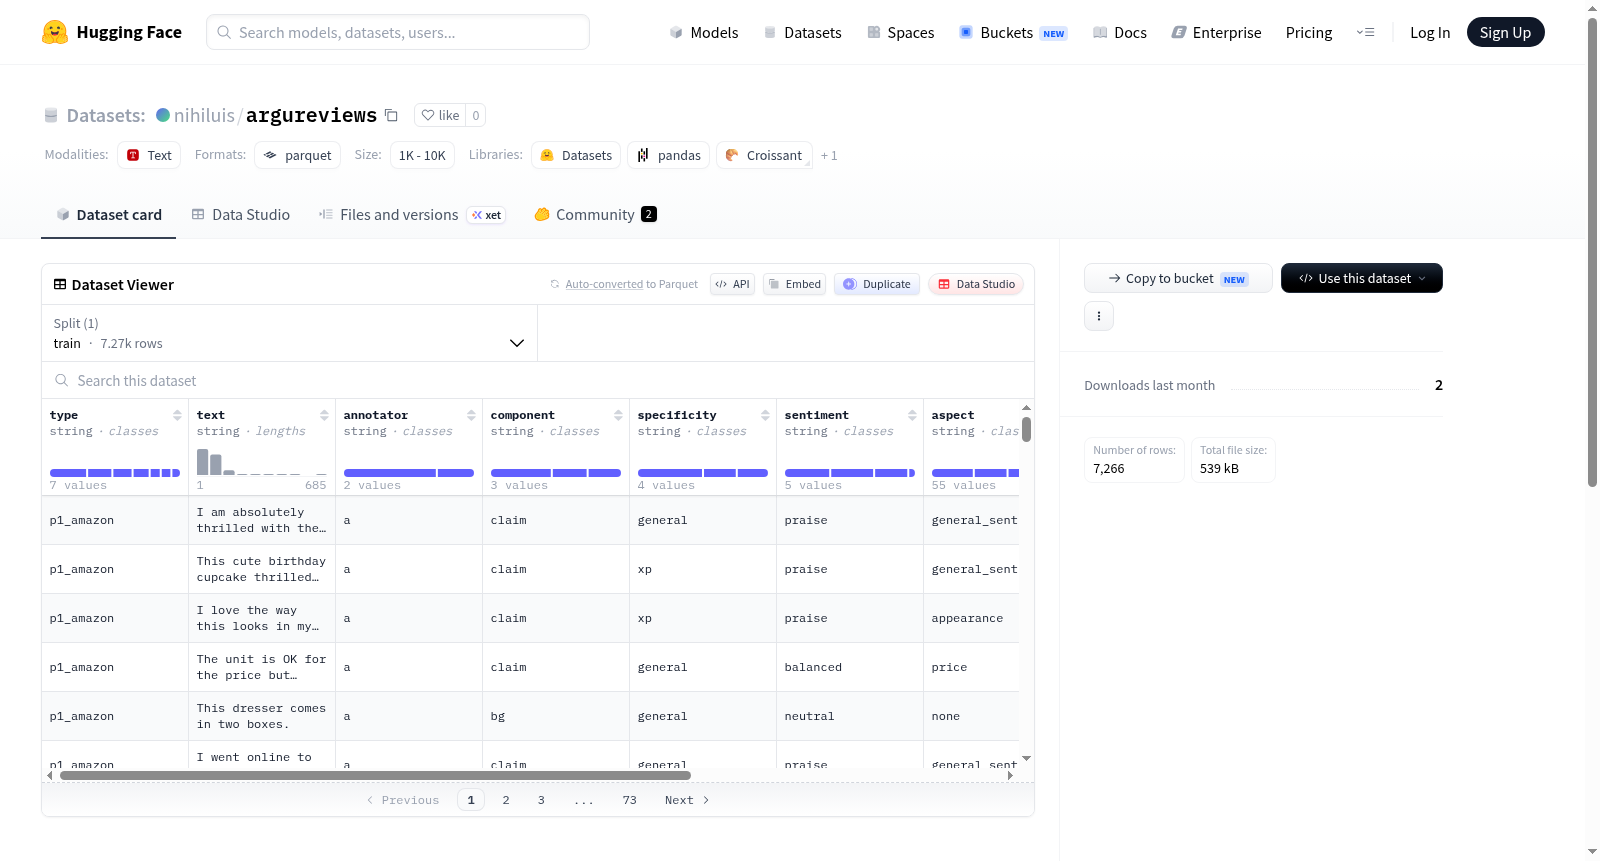
该数据集旨在标注在线评论句子的基本论证质量、情感和关注方面。它涵盖了1016条在线评论,共7286个句子,涉及以下领域:亚马逊产品、本地服务、Yelp上的餐厅和酒店以及Google Play Store上的经纪应用。数据集的特征包括类型、文本、注释者、组件、特异性、情感、方面、ID和sidx。数据集分为训练集,包含7266个示例,文件大小为1328357字节。
该数据集旨在标注在线评论句子的基本论证质量、情感和关注方面。它涵盖了1016条在线评论,共7286个句子,涉及以下领域:亚马逊产品、本地服务、Yelp上的餐厅和酒店以及Google Play Store上的经纪应用。数据集的特征包括类型、文本、注释者、组件、特异性、情感、方面、ID和sidx。数据集分为训练集,包含7266个示例,文件大小为1328357字节。
提供机构:
nihiluis原始信息汇总
数据集概述
数据集名称
"argureviews"
数据集目的
用于在线评论中的基本论证质量、情感和兴趣方面的标注。
数据集内容
- 领域覆盖:产品(Amazon)、本地服务、餐厅和酒店(Yelp)、经纪应用(Google Play Store)。
- 数据量:包含1016个在线评论,共7286个句子。
数据集特征
- 名称:type, text, annotator, component, specificity, sentiment, aspect, id, sidx
- 数据类型:均为字符串类型,除了sidx为float64类型。
数据集分割
- 训练集:7266个样本,数据大小为1328357字节。
标签集描述
- 论证组件:区分使用的论证组件,可能的值为:claim, premise, background。
- 具体性:区分通用陈述和更深入的用户陈述,可能的值为:general, specific, experience。
- 情感:关于被评论项目的正面、平衡、负面或中性论证陈述。
- 方面:提供关于论证陈述所涵盖的兴趣方面的更多见解,可能的值为:general sentiment, price, delivery, function and quality, fun and usage, style, installation, customer service, none。仅适用于Amazon评论子集。
搜集汇总
数据集介绍
构建方式
在在线评论的论辩分析领域,对评论语句的论辩质量、情感倾向及关注方面进行系统标注是提升自然语言理解能力的关键。nihiluis/argureviews数据集正是基于这一需求而构建,其数据来源涵盖亚马逊商品、Yelp本地服务与酒店、以及Google Play商店的经纪应用等多个领域的1016条在线评论,共计7286条语句。每条语句均经过人工标注,包含论辩成分(主张、前提、背景)、具体性(通用、具体、体验)、情感(积极、平衡、消极、中性)以及关注方面(如价格、功能、安装等)等多个维度。该数据集以标准格式存储,包含训练集7266个样本,并提供了基于DeBERTa的预训练模型权重,便于下游任务的迁移学习。
特点
该数据集的核心特点在于其多维度的论辩标注体系,能够同时捕捉评论语句的论辩结构、表达具体性、情感倾向及关注方面,为细粒度的论辩分析提供了丰富的信息。其中,论辩成分标签区分了主张、前提与背景,帮助识别论证的逻辑骨架;具体性标签则区分了通用陈述与基于经验的细致描述,反映了用户表达的深度;情感标签覆盖了从积极到中性的完整情感谱系;关注方面标签则针对亚马逊评论子集,提供了更细致的主题维度。此外,数据集跨领域覆盖了商品、服务与应用程序,增强了模型的泛化能力,并提供了配套的DeBERTa模型,便于研究者直接应用于论辩质量评估、情感分析及方面抽取等任务。
使用方法
使用nihiluis/argureviews数据集时,研究者可直接通过HuggingFace的datasets库加载默认配置的训练集,并进行数据预处理。每条样本包含类型、文本、标注者、论辩成分、具体性、情感、方面及唯一标识符等字段,适合用于多标签分类或序列标注任务的训练与评估。建议将文本字段与对应的论辩成分、具体性、情感标签组合,构建监督学习模型。对于方面标签,需注意其仅适用于亚马逊评论子集,可通过过滤或拆分数据集进行针对性实验。此外,数据集提供了预训练的DeBERTa模型,可基于这些模型进行微调,以提升在论辩分析相关任务上的性能表现。
背景与挑战
背景概述
在线评论作为消费者决策的重要参考,其论证质量直接影响用户对产品或服务的判断。然而,现有研究多聚焦于情感分析或主题建模,对评论中隐含的论证结构、逻辑严谨性及表达具体性的探讨尚显不足。nihiluis/argureviews数据集由研究团队于近年构建,覆盖亚马逊、Yelp及Google Play商店等多个领域的1016篇在线评论,包含7286条标注句子。该数据集的核心研究问题在于系统化标注评论中的论证成分、具体性、情感倾向及关注方面,从而为计算论证学、自然语言推理及细粒度情感分析提供基础资源。其发布推动了论证挖掘在电商与服务平台的应用,尤其为理解用户如何通过论证构建说服性语言提供了重要基准。
当前挑战
该数据集面临的挑战主要体现在两个层面。在领域问题层面,在线评论的语言高度口语化、碎片化,且论证结构常隐于情感表达之中,传统论证挖掘方法难以精准区分主张、前提与背景信息,同时多标签方面(如功能、价格、服务)的共现与冲突增加了标注歧义性。在构建过程中,跨领域(如产品与本地服务)的论证模式差异导致标注一致性维护困难,且亚马逊子集之外的其他领域缺少方面标签,限制了跨域泛化能力。此外,数据规模相对有限(7286条),可能影响深度学习模型对少众论证模式的捕捉效果,需通过迁移学习或数据增强策略予以缓解。
常用场景
经典使用场景
在计算论辩学与自然语言处理的交叉领域中,argureviews数据集为在线评论中基础论证元素的自动识别与分类提供了精细化的标注资源。该数据集涵盖亚马逊、Yelp及谷歌应用商店等多元平台,共计1016条评论与7286个句子,每句均标注了论证成分(主张、前提、背景)、特异性(一般、具体、经验)、情感倾向(正面、平衡、负面、中性)以及兴趣方面(仅亚马逊子集)。研究者常利用此数据集训练序列标注或文本分类模型,以精准解析评论文本中的论证结构,从而推动论证质量评估与观点挖掘的前沿探索。
衍生相关工作
基于argureviews数据集,研究者已衍生出多个专门化的DeBERTa微调模型,分别聚焦于论证成分、特异性、情感与方面的预测任务。这些模型不仅复现了原标注框架,还通过跨域迁移学习验证了论证特征在不同行业评论中的泛化能力。后续工作进一步探索了论证元素与立场检测、说服力评估的关联,并尝试将多标签方面识别与情感极性融合,构建端到端的论证分析管线。这些衍生研究共同充实了计算论辩学在电商、旅游等垂直领域的应用版图。
数据集最近研究
最新研究方向
在论辩挖掘与情感分析交叉领域,argureviews数据集为细粒度论辩质量评估提供了多维度标注框架,涵盖论辩成分、特异性、情感倾向及方面类别。当前前沿研究聚焦于利用该数据集训练轻量级DeBERTa模型,以实现对在线评论中论辩结构的自动识别与质量量化。该数据集整合亚马逊、Yelp及Google Play多源评论,覆盖产品、服务、餐饮及应用软件等场景,推动了评论论辩性分析从粗粒度情感分类向论辩逻辑与说服力评估的演进。其与热点事件(如虚假评论治理、用户生成内容可信度分析)紧密关联,为构建更透明、可解释的推荐系统与舆情监测工具提供了关键语义资源,具有重要的学术与应用价值。
以上内容由遇见数据集搜集并总结生成


