
david-thrower/HelixLM-medium-1500.0Mt-2988750pt-20260528
收藏数据链接:
官方服务:
资源简介:
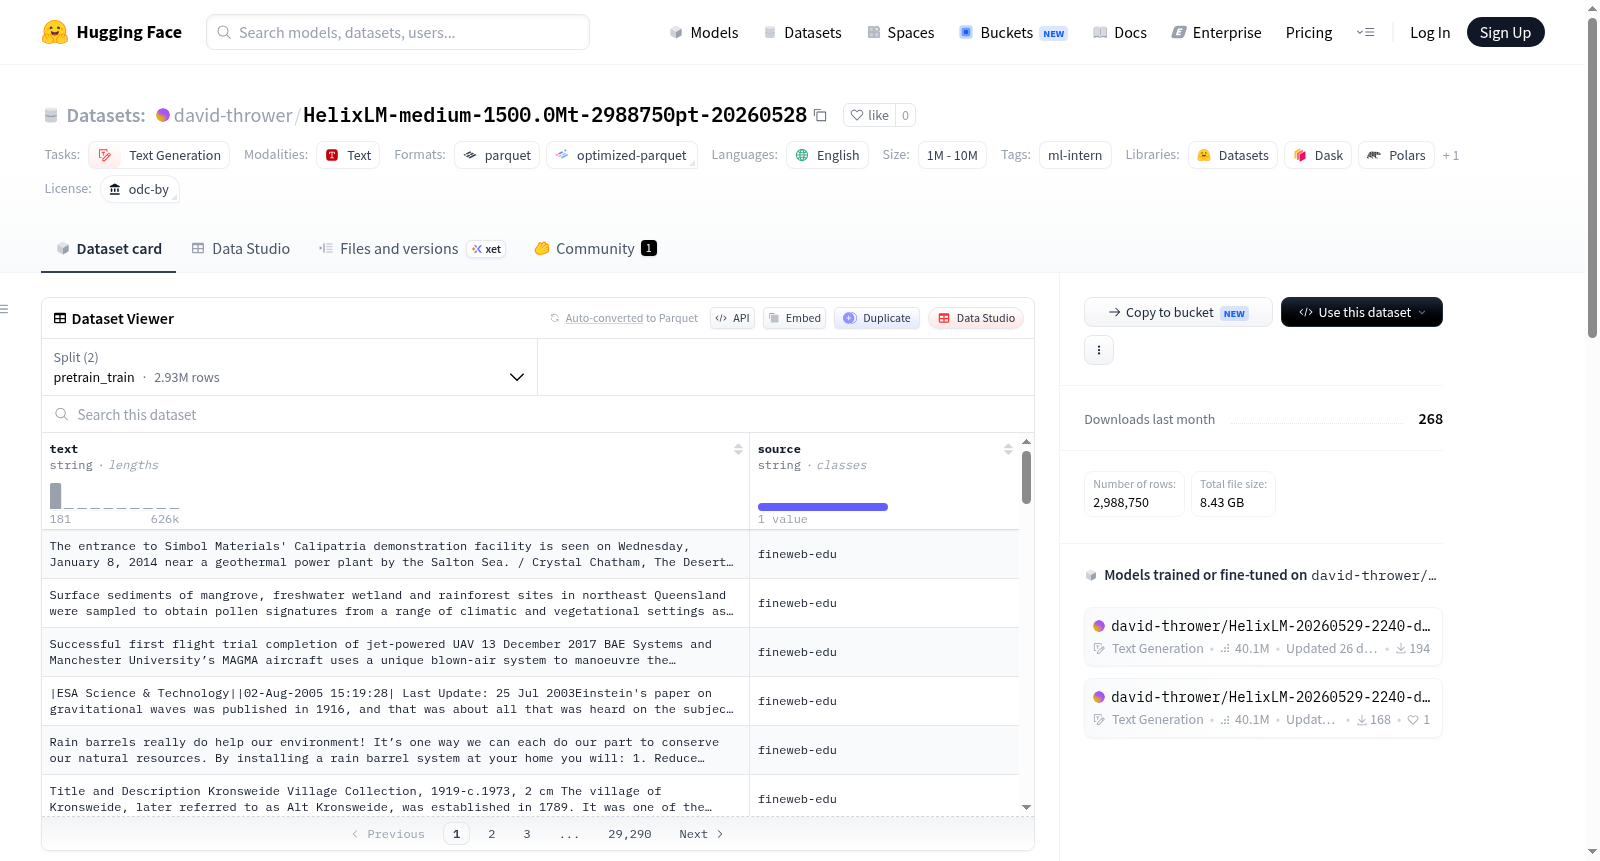
该数据集名为HelixLM-medium-1500.0Mt-2988750pt-20260528,由ML Intern生成,用于机器学习研究和开发。它包含文本和来源两个特征,分为预训练训练集(约2928975个示例)和预训练验证集(约59775个示例),总大小约14.4GB。数据集可能用于HelixLM模型的预训练任务,但具体内容和领域未在README中指定。
This dataset is named HelixLM-medium-1500.0Mt-2988750pt-20260528, generated by ML Intern for machine learning research and development. It includes features such as text and source, with splits for pretrain_train (approximately 2,928,975 examples) and pretrain_val (approximately 59,775 examples), totaling around 14.4 GB. The dataset is likely intended for pretraining tasks related to the HelixLM model, but specific content and domain are not specified in the README.
提供机构:
david-thrower搜集汇总
数据集介绍
构建方式
HelixLM-medium-1500.0Mt-2988750pt-20260528数据集是一个专为自然语言处理预训练任务设计的高质量语料库,其构建灵感源自神经科学中的神经柱与模块化概念,旨在为HelixLM新型模型架构的41M参数概念验证提供训练支撑。该数据集通过混合采样策略构建,其中99%的数据随机抽取自HuggingFaceTB/smollm-corpus语料库的碎片,剩余1%则来源于open-web-math/open-web-math数据集,整体组成遵循了Kye在OpenMythos项目文档中提出的推荐标准。这种精心设计的配比确保了语料在规模与多样性之间取得平衡,既保留了通用文本的广泛覆盖,又融入了数学领域的高质量内容,从而支持模型在多维度知识上的学习。
特点
该数据集最显著的特点在于其内容的高质量与教育属性,总量达15亿词元(1.5 billion tokens),以英文文本为主,专注于教育性预训练数据的构建。数据集中每条记录包含文本(text)和来源(source)两个字段,便于追溯数据出处,并划分为pretrain_train(约292.9万条)与pretrain_val(约5.98万条)两个子集,分别用于模型训练与验证。其设计初衷在于配合HelixLM架构的创新拓扑结构——该结构融合了神经列模块化连接、异构线性与全注意力层、递归深度以及RoPE、SwiGLU、RMSNorm等现代原语,使得数据集能够有效驱动模型在参数规模相对较小的前提下,实现超越同级权重的性能表现。
使用方法
研究者可通过HuggingFace的datasets库便捷地加载该数据集,推荐使用流式模式(streaming=True)以优化内存占用。加载命令为`from datasets import load_dataset`后调用`load_dataset('david-thrower/HelixLM-medium-1500.0Mt-2988750pt-20260528')`,即可获取训练与验证分片。该数据集在HuggingFace上以ODC-BY许可(odc-by)发布,适用于文本生成(text-generation)任务,研究者可基于其特性进行模型预训练、评估或领域适应性微调。由于数据集体积较大(约14.4GB),建议在分布式或云端环境中进行大规模实验,以充分利用其15亿词元的语料规模优势。
背景与挑战
背景概述
HelixLM-medium-1500.0Mt-2988750pt-20260528是一个于2026年5月28日创建的高质量教育预训练语料库,由研究者David Thrower主导,旨在支持其提出的HelixLM新型模型架构的概念验证训练。该数据集包含约15亿个token,其中99%来自SmolLM语料库的随机分片,1%来自OpenWebMath语料库,构成上遵循了Kye等人于OpenMythos项目中提出的数据配比建议。HelixLM模型通过模拟神经科学中的神经柱与模块化概念,将局部紧密连接的神经元集群与稀疏的跨柱通信相结合,以期在参数规模受限的条件下实现超越同量级模型的性能表现。该数据集的出现为探索更具生物启发性的模型拓扑结构提供了基础训练资源。
当前挑战
该数据集面临的挑战主要体现在两个层面:在领域问题层面,其核心在于如何通过仅15亿token的有限语料,有效训练一个41M参数的模型,使其能够在下游任务中超越更大规模的传统模型,这要求数据在质量和多样性之间达到精确平衡,以激发新型架构的模块化与稀疏通信优势。在构建过程中,挑战包括从大型语料库中随机抽取分片时保证数据分布的均衡性与代表性,以及仅以1%比例引入数学语料后,模型是否能维持足够的推理能力,同时避免因数据配比不当导致的知识覆盖偏差或灾难性遗忘。
常用场景
经典使用场景
HelixLM-medium-1500.0Mt-2988750pt-20260528 数据集主要用于大规模语言模型的预训练阶段,尤其适用于验证新型模型架构(如 HelixLM)的有效性。该数据集包含约15亿个高质量的教育类 token,其中99%来源于 SmolLM 语料库的随机分片,1%来自 OpenWebMath 语料库。研究者常利用此数据集对中小规模参数量的模型(如4100万参数的 HelixLM 原型)进行从零开始的预训练,以评估模型在知识获取、语言理解与推理能力上的表现。该数据集的设计强调教育性与高质量,适合用于检验模块化神经网络结构在语言建模任务中的学习效率与收敛性能。
实际应用
在实际应用中,该数据集可支撑教育智能助手、代码辅助生成、科学文献摘要等对语言模型的准确性与可解释性要求较高的场景。由于数据集语料以教育类内容为主,预先训练的模型更倾向于生成逻辑严谨、知识结构清晰的回复,适合部署于在线学习平台或知识问答系统。此外,研究者可借助该数据集训练轻量级模型,在资源受限的边缘设备(如移动终端或嵌入式系统)上实现高效的文本生成与理解功能。该数据集的组成比例与内容质量也为工业界定制垂直领域预训练语料提供了参考范式。
衍生相关工作
该数据集直接衍生并支撑了 HelixLM 模型架构的验证工作,特别是基于 'Cerebros Core Algorithm Alpha' 实现的神经列激励拓扑结构。Kye 关于 OpenMythos 项目的数据集推荐策略为该语料的构建提供了理论来源,推动了模块化语言模型在参数效率上的系统性研究。后续工作可能包括:将该数据集扩展至多语言版本,或结合主动持续学习算法以验证模型在非平稳环境下的适应能力。该数据集的公开也为脑科学与人工智能交叉领域的研究者提供了一种可复现的基准,用以衡量生物启发式架构相较于传统 Transformers 在计算效率与表示学习上的优势。
以上内容由遇见数据集搜集并总结生成


