
giannor/dala_gen_large_v3_ci
收藏官方服务:
资源简介:
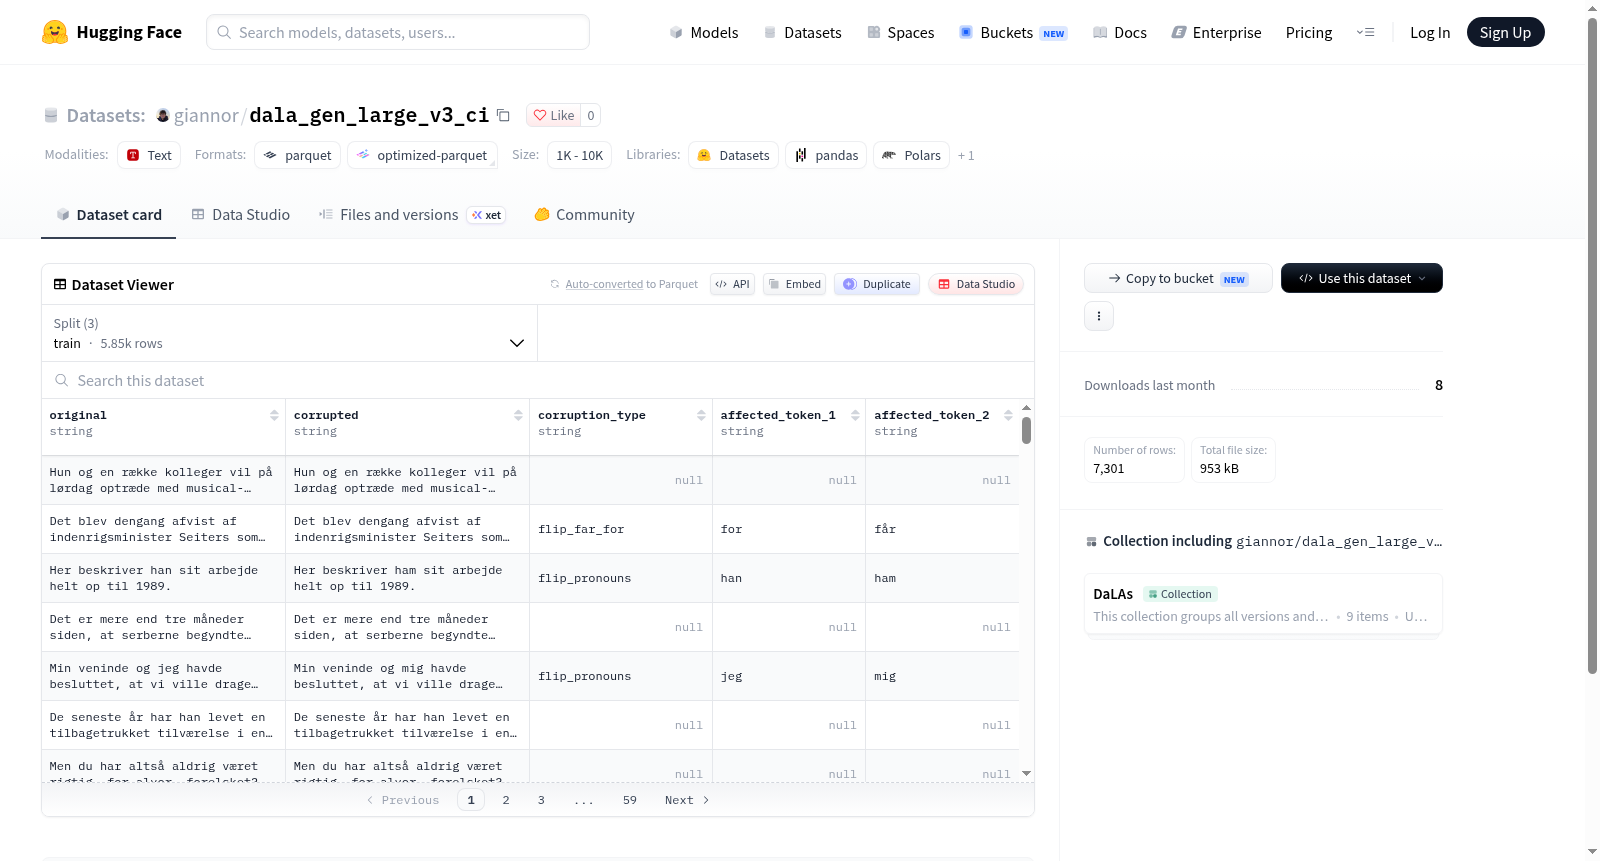
--- dataset_info: features: - name: original dtype: string - name: corrupted dtype: string - name: corruption_type dtype: string - name: affected_token_1 dtype: string - name: affected_token_2 dtype: string splits: - name: train num_bytes: 1526937 num_examples: 5848 - name: val num_bytes: 92005 num_examples: 365 - name: test num_bytes: 281641 num_examples: 1088 download_size: 949485 dataset_size: 1900583 configs: - config_name: default data_files: - split: train path: data/train-* - split: val path: data/val-* - split: test path: data/test-* ---
提供机构:
giannor搜集汇总
数据集介绍
构建方式
在自然语言处理领域,针对文本鲁棒性与错误检测的研究,数据集的构建通常依赖于对原始语料的系统性扰动。该数据集通过自动化流程对原始文本(original)施加多样化的字符级或词级扰动,生成对应的受损文本(corrupted),并记录扰动类型(corruption_type)以及受影响的具体标记(affected_token_1、affected_token_2)。数据被划分为训练集(5848例)、验证集(365例)和测试集(1088例),整体规模适中,便于模型训练与评估。
使用方法
使用该数据集时,研究人员可将original作为输入或目标文本,corrupted作为扰动版本,用于训练错误检测、文本纠错或鲁棒性增强模型。corruption_type和affected_token字段可用于多任务学习或细粒度分析,例如识别特定扰动类型的影响。通过HuggingFace数据集库可便捷加载,利用train、val、test划分进行模型训练、超参数调优和最终评估。该数据集亦适用于探究模型对词元级扰动的注意力机制或鲁棒性边界。
背景与挑战
背景概述
在自然语言处理领域,文本鲁棒性始终是核心议题,尤其面对拼写错误、语法扰动等现实噪声时,模型性能易显著下降。现有资源多聚焦于英文,中文扰动数据稀缺。在此背景下,dala_gen_large_v3_ci数据集应运而生,其构建旨在为中文文本提供涵盖多种扰动类型的平行语料。该数据集包含原始文本、受损文本、扰动类型及受影响词元标注,划分训练、验证与测试集,为评估模型在扰动下的表现及鲁棒性提升提供关键基准,推动了中文噪声建模研究。
当前挑战
该数据集所应对的领域问题在于,如何使模型在遭遇字符替换、插入、删除等扰动时仍能保持语义理解与任务性能,这本质上是对抗自然语言处理中的脆弱性。构建过程中的挑战则体现为扰动生成的多样性与可控性:需在保持语义一致的前提下引入真实且多样的噪声,同时精准标注受影响词元,并确保数据分布无偏。此外,平衡各扰动类型的样本量、避免人工痕迹,以及验证扰动对下游任务的代表性影响,均为构建中需攻克的技术难点。
常用场景
经典使用场景
在自然语言处理领域,文本纠错任务始终是衡量模型语言理解能力的关键基准。dala_gen_large_v3_ci数据集凭借其精细的标注结构,成为评估与训练文本纠错模型的经典资源。该数据集包含原始文本、 corrupted文本、 corruption类型及受影响token等字段,为研究者和开发者提供了端到端的监督信号,常用于训练序列到序列的纠错模型,如基于Transformer的编码器-解码器架构,或用于评估预训练语言模型在字符级与词级错误上的鲁棒性。其训练集、验证集与测试集的划分,支持模型在统一标准下进行性能对比,成为中文文本纠错研究中的常用实验平台。
解决学术问题
该数据集有效缓解了中文文本纠错研究中高质量标注数据匮乏的困境。以往研究多依赖人工构造错误或小规模语料,难以覆盖多样化的错误类型,导致模型泛化能力受限。dala_gen_large_v3_ci通过系统化生成多种 corruption类型,并标注受影响token,为学术研究提供了可控、可复现的错误注入机制。这不仅支撑了错误检测与纠正算法的定量分析,还促进了针对特定错误类型的细粒度研究,如混淆字、缺字、多字等,从而推动了纠错模型在准确率与鲁棒性上的双重提升,对中文信息处理领域具有重要的方法论意义。
实际应用
在实际应用中,dala_gen_large_v3_ci数据集广泛服务于智能写作辅助、搜索引擎查询纠错、社交媒体内容审核以及OCR后处理等场景。例如,在智能输入法中,基于该数据集训练的模型能够实时识别并修正用户输入中的拼写错误或语法偏差,提升交互体验;在内容审核环节,可借助其检测文本中的异常字符或恶意篡改,保障信息质量。此外,该数据集的结构化标注也便于迁移至其他语言或领域,为多语言纠错系统的开发提供参考范式,展现出显著的工程应用价值。
数据集最近研究
最新研究方向
在自然语言处理领域,数据增强与鲁棒性评估日益受到关注。dala_gen_large_v3_ci数据集通过提供原始文本、 corrupted文本、 corruption类型及受影响token的标注,为研究模型在字符级扰动下的鲁棒性提供了细粒度资源。当前前沿研究利用该数据集探索基于token级扰动感知的预训练语言模型微调策略,并分析不同类型字符错误对下游任务性能的影响。该数据集与近年来关于对抗性攻击防御和噪声容忍训练的热点议题紧密相关,其细粒度标注特性有助于推动可解释性鲁棒性研究,对构建更稳健的NLP系统具有重要价值。
以上内容由遇见数据集搜集并总结生成


