
Data-Gouv-FR/benchgecko-toutes-les-donnees-autour-de-l-ia
收藏数据链接:
官方服务:
资源简介:
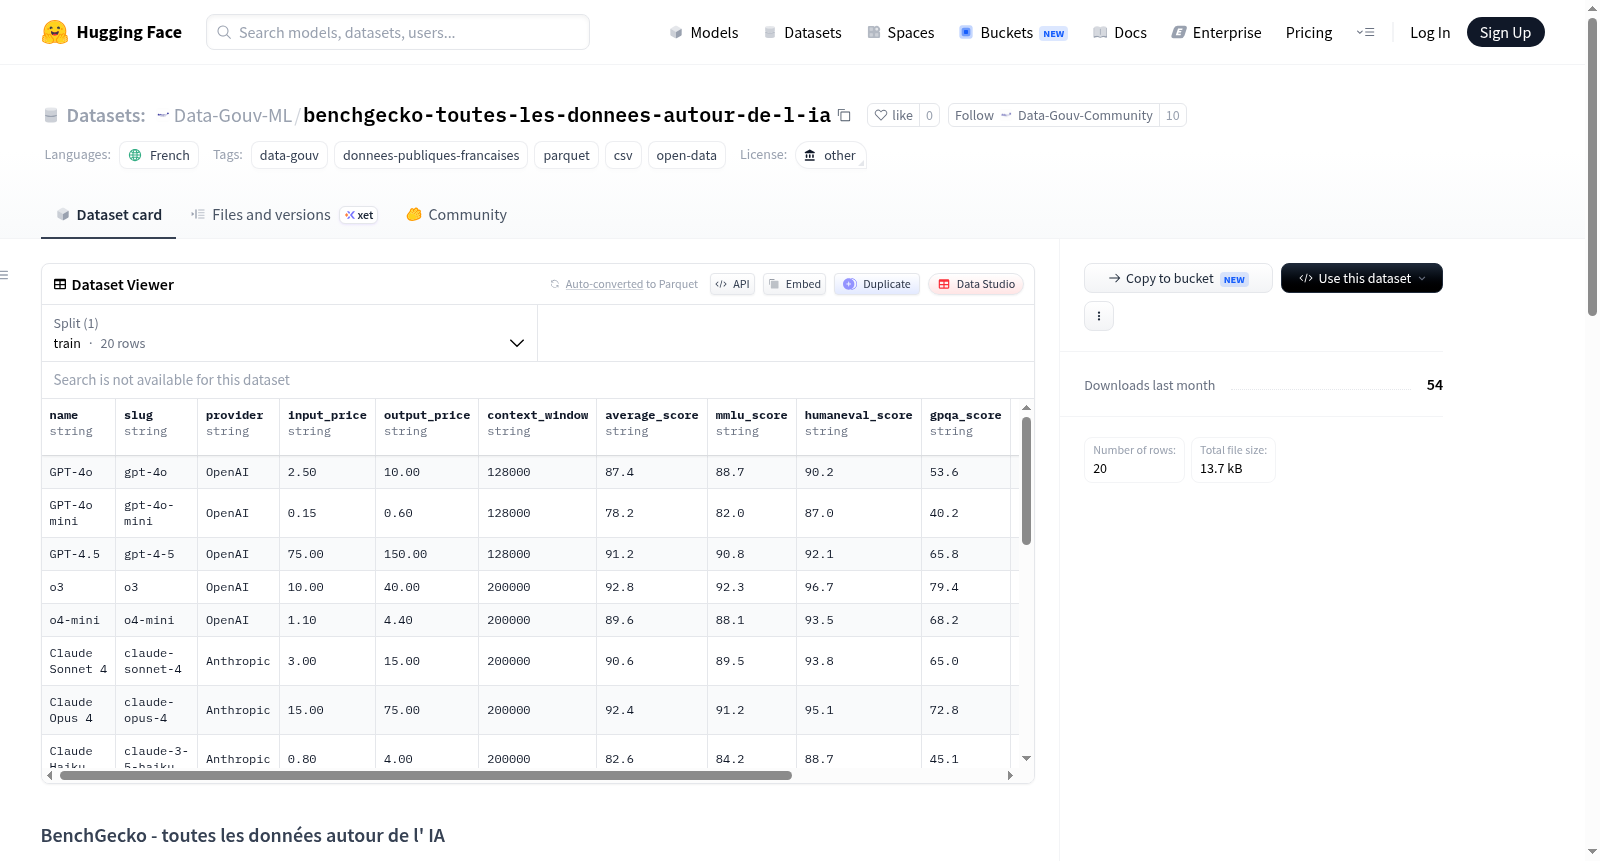
这是一个关于人工智能模型的开放数据集,包含模型的基准测试分数、多供应商定价和技术规格。数据集覆盖了数千个AI模型,并比较了不同供应商之间的定价;包括128个基准测试(如MMLU、HumanEval、SWE-bench、ARC、GSM8K等);涉及268个供应商,提供每百万tokens的价格;以及技术规格(如上下文窗口、开源状态、发布日期)。数据由BenchGecko(AI经济数据层)每日编译和更新。
An open dataset on artificial intelligence models, their benchmark scores, multi-provider pricing, and technical specifications. This dataset covers: thousands of AI models with comparative pricing across providers; 128 benchmarks (e.g., MMLU, HumanEval, SWE-bench, ARC, GSM8K, and more); 268 providers with price per million tokens; and technical specifications (context window, open source, release date). Data is compiled and updated daily by BenchGecko, the data layer of the AI economy.
提供机构:
Data-Gouv-FR搜集汇总
数据集介绍
构建方式
该数据集源自法国开放数据平台data.gouv.fr,由BenchGecko平台每日编译并更新,旨在汇聚人工智能领域模型的全面信息。其构建遵循将原始tabular资源直接映射为Hugging Face子集/配置的方式,每个子集对应一个独立的Parquet格式文件,并统一包含名为'train'的数据拆分。当前版本仅包含'modeles-d-ia'一个子集,数据存储于'data/modeles-d-ia.parquet'路径下,以高效列式存储格式保障后续读取与处理的性能。
特点
数据集的核心特色在于其多维度、跨供应商的综合性。它不仅收录了数千个AI模型在128个基准测试(如MMLU、HumanEval、SWE-bench、ARC、GSM8K等)中的得分,还提供了涵盖268个供应商的定价信息(每百万token价格),并囊括了上下文窗口、开源状态、发布日期等技术规格。这种将性能、成本与规格并置的结构,为研究者与从业者提供了从技术到商业的全景视角,使得模型比较与选型决策有据可依。
使用方法
用户可通过Hugging Face的datasets库便捷加载数据,以Python代码'datasets.load_dataset("Data-Gouv-ML/benchgecko-toutes-les-donnees-autour-de-l-ia", "modeles-d-ia")'完成调用,返回的对象即可按常规数据集API访问'train'拆分中的全部记录。此外,数据集对应的原始交互界面提供了模型排行榜、价格对比器以及围绕AI经济的完整生态图谱,用户亦可借助BenchGecko的API文档进行更定制化的数据检索与分析操作。
背景与挑战
背景概述
BenchGecko 数据集由 BenchGecko 团队创建,于近年来发布,旨在系统性地聚合人工智能模型的多维信息,涵盖模型基准评分、多供应商定价及技术规格。该数据集依托法国开放数据平台 data.gouv.fr,收录了数千个 AI 模型、128 个基准测试(如 MMLU、HumanEval、SWE-bench)、268 个供应商的百万 token 价格,以及上下文窗口、开源状态、发布日期等技术细节,为 AI 经济提供了统一的数据层。其影响力在于连接模型性能与商业成本,支持开发者、研究者和政策制定者进行跨供应商对比分析,推动了 AI 生态透明化与决策理性化。每日更新的特性确保了数据时效性,使其成为 AI 领域动态监测的重要基础设施。
当前挑战
该数据集首先面临 AI 领域基准多样性与标准化的挑战:模型性能评估依赖差异化的基准集(如推理、代码生成),缺乏统一度量衡,导致跨模型对比复杂化。其次,构建过程中的挑战包括多源数据整合与质量保障——需从 268 个供应商爬取动态定价,处理高频更新的版本与规格变动,并消除供应商报告差异。此外,许可证兼容性(licence ouverte 2.0)与法语元数据框架要求精细的格式对齐,而大规模异构数据(如 JSON 与 CSV 混合)的清洗与标注需保证准确性。最终,每日同步机制对计算资源与容错性提出严苛要求,需平衡时效性与数据一致性。
常用场景
经典使用场景
在人工智能领域的研究与开发中,BenchGecko数据集扮演着不可或缺的基石角色。该数据集汇聚了数千个AI模型的详尽信息,涵盖其在不同基准测试中的表现评分、多供应商定价策略以及核心技术规格。研究者与工程师可借助这一丰富的资源,对模型性能进行横向与纵向比较,洞察模型演进趋势,从而为模型选型与优化提供科学依据。无论是进行大规模语言模型的对比分析,还是探索开放源代码模型与封闭模型间的效能差异,BenchGecko都能提供系统化的数据支撑。
衍生相关工作
基于BenchGecko数据集,一系列衍生研究工作得以蓬勃开展。例如,研究者利用该数据集构建了动态的模型排行榜与性能预测模型,能够根据历史数据预测新发布模型的潜在表现。另一类典型工作则聚焦于定价策略分析,通过挖掘供应商间的价格弹性与模型性能关系,为AI服务市场的定价模型提供了实证基础。此外,有学者以此为基础,开发了开源的模型选型推荐系统,该系统能够在考虑任务类型、预算上限和性能要求的情况下,自动推荐最优的AI模型组合,从而降低了非专业用户的技术准入门槛。
数据集最近研究
最新研究方向
当前,BenchGecko数据集聚焦于人工智能模型的性能基准、多供应商定价与技术规格的全面比对,成为追踪AI经济生态演化的关键资源。在前沿研究中,该数据被用于分析大规模语言模型在不同基准(如MMLU、HumanEval)上的表现趋势,以及云计算市场中的价格竞争动态。随着开源模型与闭源模型的性能差距逐渐缩小,研究者利用该数据集探讨模型选择的经济学权衡,并评估芯片供应链与算力成本对AI产业格局的影响。其每日更新的特性使得实时追踪AI技术的商业化落地成为可能,为政策制定者和企业决策提供了数据驱动的洞察。
以上内容由遇见数据集搜集并总结生成


