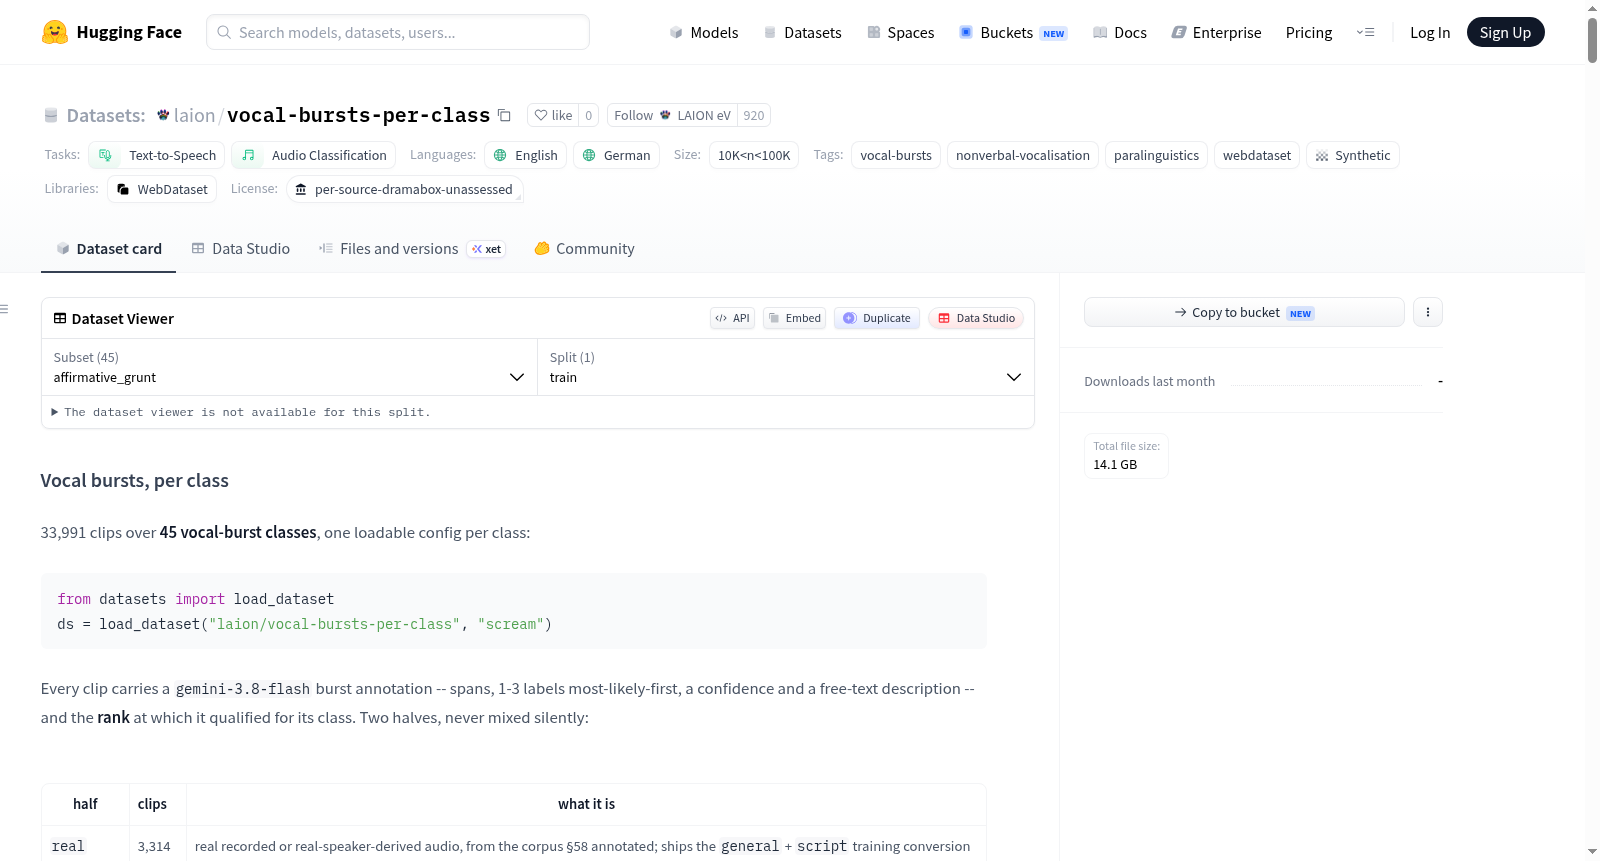
vocal-bursts-per-class
收藏资源简介:
该数据集名为“Vocal bursts, per class”,是一个专注于非言语声音爆发(vocal bursts)的音频数据集,包含 45 个类别,总计 33,991 个音频片段。数据集旨在为文本转语音(TTS)和音频分类任务提供资源,特别是处理诸如笑声、叹气、咳嗽、尖叫等非言语声音。数据来源包括两部分:真实录音(real,共 3,314 个片段)和由 DramaBox TTS 系统生成的合成音频(dramabox,共 30,677 个片段)。每个音频片段都附带由 Gemini 模型生成的 burst 标注,包含时间戳、1-3 个按可能性排序的标签、置信度和自由文本描述,以及一个 rank 字段,指示该类别在标注中的排名(0 表示标注器的首选,1 表示提示与标注的联合声明,-1 表示真实录音)。数据集以 WebDataset 格式组织,每个配置对应一个类别,每个样本包含一个 MP3 文件(合成)或 OGG 文件(真实)以及一个 JSON 文件,元数据包括类别、来源、rank、burst 起止时间、标签、标注原始信息等。需要注意的是,所有标注均为模型输出,未经人工审核,且合成部分的许可证状态未评估,用户需谨慎使用。
This dataset, named Vocal bursts, per class, is an audio dataset focusing on non-verbal vocal bursts, containing 45 classes and a total of 33,991 audio clips. It is designed to provide resources for text-to-speech (TTS) and audio classification tasks, particularly for processing non-verbal sounds such as laughter, sighs, coughs, screams, etc. The data sources consist of two parts: real recordings (real, 3,314 clips) and synthetic audio generated by the DramaBox TTS system (dramabox, 30,677 clips). Each audio clip is accompanied by burst annotations generated by the Gemini model, including timestamps, 1-3 labels sorted by likelihood, confidence scores, free-text descriptions, and a rank field indicating the categorys ranking in the annotation (0 for annotators first choice, 1 for joint declaration of prompt and annotation, -1 for real recordings). The dataset is organized in WebDataset format, with each configuration corresponding to a class, and each sample containing an MP3 file (synthetic) or OGG file (real) along with a JSON file. Metadata includes class, source, rank, burst start and end times, labels, raw annotation information, etc. Note that all annotations are model outputs and have not been manually reviewed, and the license status of the synthetic part has not been evaluated; users should use with caution.
数据集概述:laion/vocal-bursts-per-class
- 数据集地址:https://huggingface.co/datasets/laion/vocal-bursts-per-class
- 简介:该数据集包含33,991个音频片段,覆盖45个“人声突发”(vocal bursts)类别,如笑声、叹息、咳嗽、呼吸声等非语言发声。每个类别作为一个可独立加载的配置(config)提供。所有片段均携带由Gemini模型生成的标注,包括时间跨度、1-3个按可能性排序的标签、置信度及自由文本描述。
- 主要用途:可支持文本转语音(text-to-speech)和音频分类(audio-classification)任务。
数据构成
- 总数:33,991个片段,45个类别。
- 两大组成部分:
- 真实音频(real):共3,314个片段,来自真实录制或真实说话人衍生音频,源自第58节发布的语料库。
- 合成音频(Dramabox):共30,677个片段,由DramaBox TTS根据英文提示生成的合成音频,并由同一标注模型进行标注。
- 来源分离:每个样本的元数据中都有
source字段(“real”或“dramabox”),便于过滤。
数据格式与加载
- 格式:WebDataset格式,按类别存放为tar文件(
data/<类别>/<类别>-*.tar)。 - 每个样本包含:
- 音频文件:DramaBox部分为mp3格式(160 kb/s 单声道 48 kHz,未重新编码);真实部分为ogg格式(48 kHz 单声道 OGG/Vorbis)。
- 一个JSON文件,包含
class、source、rank、qualified_by、burst_starts、burst_ends、burst_labels、burst_labels_norm、gemini_events、dur_s等元数据,以及特定于各半部分的字段(如DramaBox的提示类别、性别、年龄段;真实部分的来源、验证级别等)。
- 加载示例: python from datasets import load_dataset ds = load_dataset("laion/vocal-bursts-per-class", "scream")
重要提示
- 无人工审核:所有标签均由AI模型生成,未经人工试听验证,不构成“真实标签”。
- 许可证未评估:DramaBox合成部分的LTX-2社区许可证未评估,用户需谨慎使用;真实部分的许可证较清晰,遵循特定数据集的条款。
- rank字段含义:并不代表质量,而是对标签源头的说明——rank 0代表标注者的首选标签;rank 1代表标注者的第二选择标签(提示词与标注者的联合声明);rank -1代表真实音频的标注。
- 子集性质:本发布是一个子集,某些真实音频片段因不在发布许可范围内被剔除。
类别分布
数据集中每个类别的大小差异显著。部分类别完全由真实音频构成,例如 breathy_giggle、chuckle、exhausted_groan(无DramaBox数据);大多数类别以DramaBox合成音频为主,如 cackle、childlike_giggle、cough、clears_throat 等。类别涵盖各种笑声(如giggle、chuckle、cackle、guffaw)、呼吸声(如deep_breath、panting、gasp)、叹息声(如sigh、groan)、及其他非语言发声(如咳嗽、打嗝、吞咽、哼哼、尖叫等)。