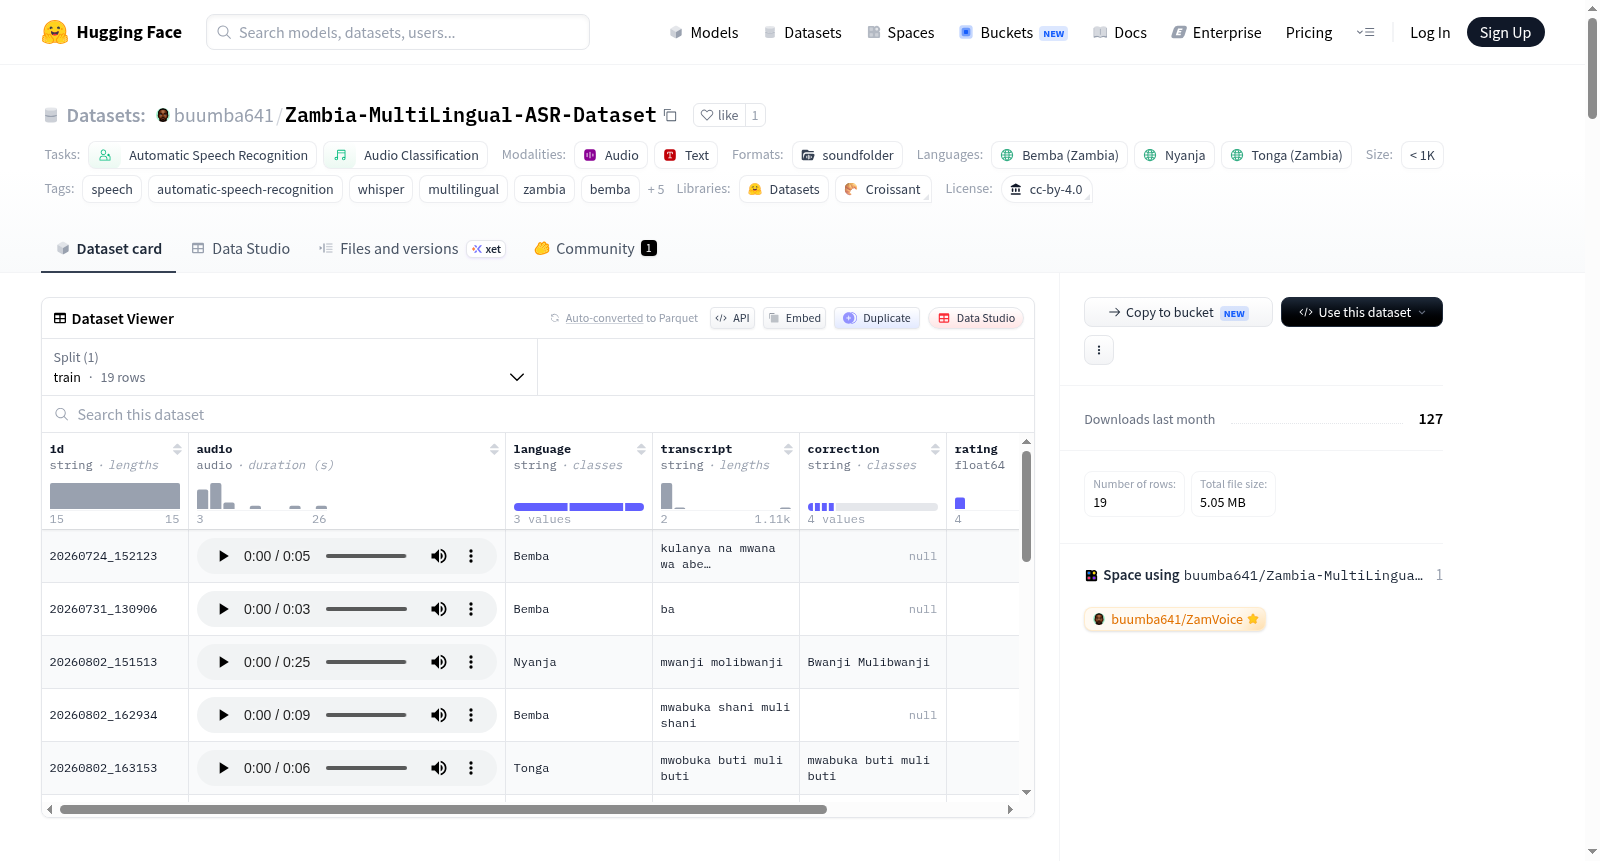
Zambia-MultiLingual-ASR-Dataset
收藏资源简介:
赞比亚多语言ASR数据集(Zambia Multilingual ASR Dataset)是一个开放、持续增长的语音语料库,隶属于ZamVoice项目。该数据集旨在推动低资源赞比亚语言(目前包括Bemba、Nyanja、Tonga)的自动语音识别(ASR)研究。与传统静态数据集不同,它通过社区参与不断增长:语音录音通过ZamVoice平台收集,由语言特定的Whisper模型自动转录,并可选地由贡献者通过评分、纠正转录和书面反馈进行审核。数据集包含音频文件(WAV格式)和元数据表(metadata.csv),每条记录对应唯一ID、提交时间戳、音频路径、语言、使用的Whisper模型、自动转录结果、用户评分(可选)、纠正后转录(可选)和评论(可选)。数据收集流程包括录音、自动转录、保存音频、记录元数据,以及可选的用户反馈阶段。该数据集建立在赞比亚大学语音与语言研究组的Zambezi Voice项目基础之上,并扩展了社区驱动的持续数据收集与策展。数据集可用于ASR、低资源语音处理、领域自适应、持续学习、主动学习、模型基准测试、迁移学习以及非洲语言技术等研究领域。数据集基于CC BY 4.0许可证发布。
The Zambia Multilingual ASR Dataset is an open and continuously growing speech corpus affiliated with the ZamVoice project. This dataset aims to advance automatic speech recognition (ASR) research for low-resource Zambian languages, which currently include Bemba, Nyanja, and Tonga. Unlike traditional static datasets, it expands through community participation: speech recordings are collected via the ZamVoice platform, automatically transcribed by language-specific Whisper models, and optionally reviewed by contributors through scoring, transcript correction, and written feedback. The dataset consists of audio files in WAV format and a metadata table (metadata.csv), with each record containing a unique ID, submission timestamp, audio path, language, utilized Whisper model, automatic transcription result, user rating (optional), corrected transcription (optional), and comments (optional). The data collection workflow encompasses audio recording, automatic transcription, audio storage, metadata logging, and an optional user feedback stage. Built upon the Zambezi Voice project of the Speech and Language Research Group at the University of Zambia, this dataset expands the original project with community-driven continuous data collection and curation. The dataset is applicable to research areas including ASR, low-resource speech processing, domain adaptation, continual learning, active learning, model benchmarking, transfer learning, and African language technology. It is released under the CC BY 4.0 license.
🇿🇲 赞比亚多语言ASR数据集
数据集概述
赞比亚多语言ASR数据集是一个开放、持续增长的多语言语音语料库,作为ZamVoice项目的一部分开发。该数据集旨在通过社区驱动的数据收集和真实世界评估,推进赞比亚语言的自动语音识别(ASR)研究。
核心特点
- 持续演进的语料库:不同于传统静态数据集,该语料库通过社区参与不断增长
- 数据收集流程:语音通过ZamVoice平台收集,使用特定语言的Whisper模型自动转录,并可通过评分、修正转录和书面反馈进行人工审核
- 真实世界语音:包含自然环境中收集的语音,涵盖不同录音设备、背景噪音、口音、语速等变化
支持语言
当前支持三种赞比亚语言:
- Bemba(本巴语)
- Nyanja(尼扬贾语)
- Tonga(汤加语)
未来版本计划扩展到更多赞比亚语言。
数据集结构
Zambia-Multilingual-ASR-Dataset/ ├── audio/ # 音频文件(*.wav) ├── meta_data.csv # 元数据文件 └── README.md
元数据字段
| 字段 | 说明 |
|---|---|
| id | 唯一样本标识符 |
| timestamp | 提交日期和时间 |
| audio_file | 音频录音的相对路径 |
| language | 口语语言 |
| model | 用于转录的Whisper模型 |
| prediction | 自动生成的转录文本 |
| rating | 用户质量评分(可选) |
| corrected_transcript | 用户修正的转录文本(可选) |
| comment | 用户反馈(可选) |
未提供反馈时,相应字段保持为空,直到未来进行标注或审核。
研究动因
现有公开数据集大多为受控条件下精心录制的朗读语音,而实际部署中的语音在录音设备、背景噪音、说话风格、口音方言、语速、发音和录音环境等方面存在显著差异,往往导致识别系统性能下降。该数据集通过持续收集真实世界语音,同时保留基准质量参考录音,支持以下研究方向:
- 领域适应
- 模型鲁棒性
- 持续学习
- 主动学习
- 人在回路标注
与Zambezi Voice的关系
该数据集建立在赞比亚大学语音与语言研究小组及Zambezi Voice项目的开创性工作基础上。ZamVoice使用的特定语言Whisper模型使用Zambezi Voice语料库进行微调后部署。数据集可能包含:
- 来自Zambezi Voice语料库的精选参考录音(在允许且适当归属的情况下)
- 通过ZamVoice收集的社区贡献语音
- 自动生成的转录
- 人工质量评分
- 修正后的转录
- 用户反馈
数据收集工作流程
语音录制 → 自动转录 → 音频保存 → 元数据记录 → (可选)质量评分/修正转录/反馈评论 → 数据集更新
每个录音在转录后立即贡献到数据集,后续可通过用户反馈添加额外标注。
数据策展
数据集定期审查以提高整体质量,策展活动包括:
- 移除损坏的录音
- 移除重复录音
- 移除无有效语音的录音
- 更正元数据
- 使用经验证的用户修正更新转录
- 验证语言标签
- 改进标注质量
预期应用场景
- 自动语音识别(ASR)
- 语音语料库开发
- 低资源语音处理
- 领域适应
- 持续学习
- 主动学习
- 模型基准测试
- 迁移学习
- 非洲语言技术
许可证
该数据集根据**知识共享署名4.0国际许可证(CC BY 4.0)**发布,除非个别子集或外部来源录音另有规定。用户有责任确保遵守任何引用或包含的第三方数据的许可条款。