uilyam_folkner_pah_verbeny_output
收藏资源简介:
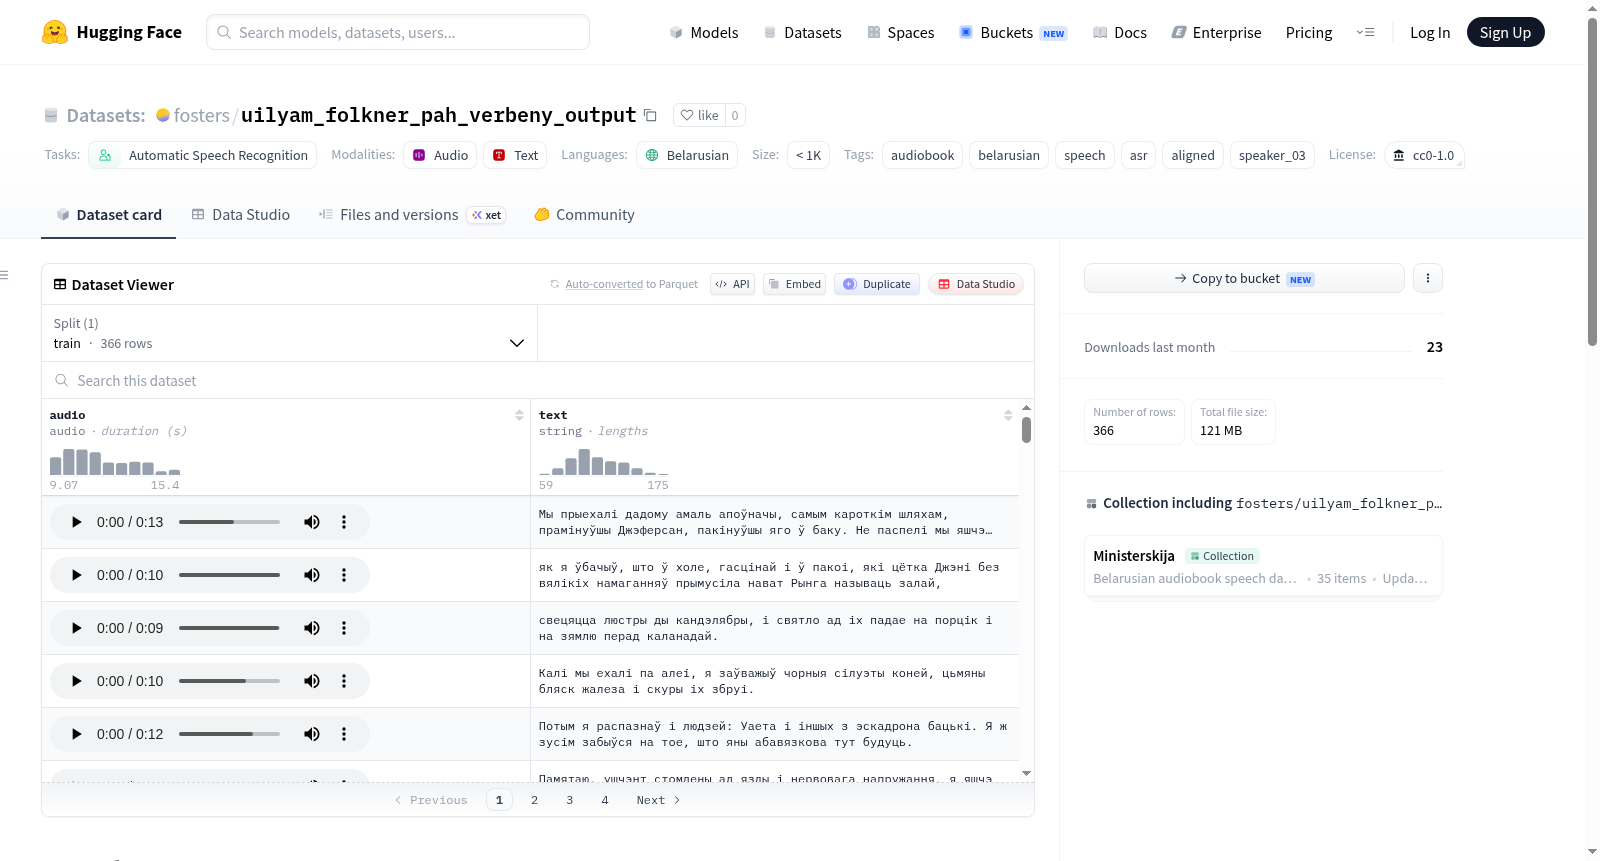
该数据集名为“Пах вербены — Уільям Фолкнер”(威廉·福克纳的《Verbena的香味》),是Ministerskija集合的一部分,该集合专注于提供对齐的、带有转录的Belarusian(白俄罗斯语)有声读物音频数据。数据集旨在支持Belarusian语言的自动语音识别(ASR)任务。数据内容来源于Belarusian有声读物,经过处理被分割成约15秒的短音频片段,并与转录文本进行高精度对齐(对齐置信度≥0.95)。每条数据记录包含三个字段:音频片段(audio)、对应的转录文本(text,通过Gemini和ASR系统对齐生成)以及片段的唯一标识符(chunk_uid)。数据规模方面,在HuggingFace平台上发布了366条记录,总数据库包含531条记录,音频总时长约为1小时22分钟。该数据集适用于训练或评估Belarusian语音识别模型,尤其适用于处理有声读物风格的语音数据。
The dataset is named "Пах вербены — Уільям Фолкнер" (Scent of Verbena by William Faulkner), and it is part of the Ministerskija Collection, which focuses on providing aligned, transcribed Belarusian audiobook audio data. This dataset is designed to support automatic speech recognition (ASR) tasks for the Belarusian language. The dataset's content is sourced from Belarusian audiobooks, processed into short audio clips of approximately 15 seconds in length, and aligned with their corresponding transcriptions with high accuracy (alignment confidence ≥ 0.95). Each data record includes three fields: the audio clip (audio), the corresponding transcription text (text, generated via alignment using Gemini and ASR systems), and the unique identifier of the clip (chunk_uid). In terms of scale, 366 records have been released on the HuggingFace platform, while the full database contains 531 records with a total audio duration of approximately 1 hour and 22 minutes. This dataset is suitable for training or evaluating Belarusian speech recognition models, particularly for processing audiobook-style speech data.
数据集概述
名称: Пах вербены (Pach verbeny)
作者: Уільям Фолкнер (William Faulkner)
语言: 白俄罗斯语 (Belarusian)
许可证: CC0-1.0
任务类型: 自动语音识别 (Automatic Speech Recognition, ASR)
标签: 有声书、白俄罗斯语、语音、ASR、对齐数据、speaker_03
数据规模: 1,000 到 10,000 行 (1K < n < 10K)
数据集详情
- 发布行数 (Hugging Face): 366
- 数据库总行数: 531
- 音频总时长: 1小时22分钟
- 对齐置信度阈值: ≥ 0.95
数据内容结构
每行包含三个字段:
audio: 音频片段,时长约15秒text: 文本转录(由 Gemini 模型与 ASR 系统对齐生成)chunk_uid: 片段唯一标识符
数据处理说明
该有声书内容被分割为短片段,并利用 Gemini 模型及两套独立的 ASR 系统进行文本与音频的对齐,对齐置信度不低于 0.95。
说话人/朗读者信息
| 属性 | 值 |
|---|---|
| 说话人聚类编号 | speaker_03 |
| 平均相似度评分 | 0.898 |
| 最相近的已有数据集 | dzintra_shultse_robertsik_output (相似度 0.94) |
说话人识别基于 WavLM-Base+ 模型(余弦相似度,阈值=0.82)
所属合集
该数据集是 Ministerskija 合集的一部分,该合集包含对齐的白俄罗斯语有声书音频及其转录。