
遇见数据集

imet-open-access

收藏
Hugging Face2026-09-29 更新2026-09-30 收录
官方服务:

资源简介:

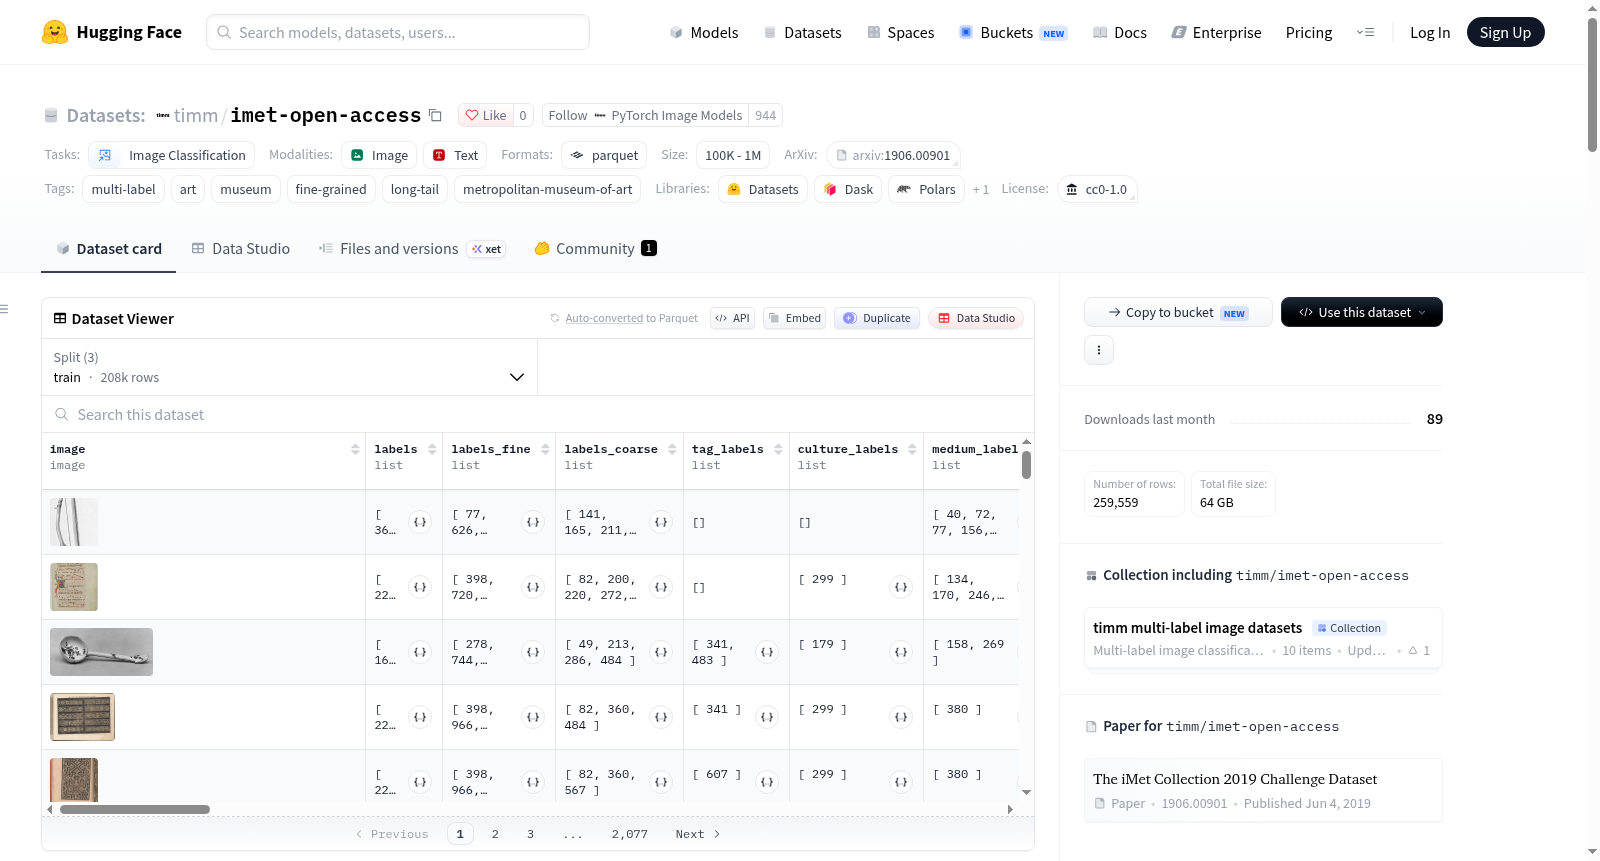
iMet开放访问数据集(大都会艺术博物馆藏品多标签属性)是一个用于多标签图像分类任务的数据集。该数据集包含来自纽约大都会艺术博物馆的藏品图像,每张图像带有多个属性标签,这些标签涵盖了国家(如阿富汗、中国、法国等)、文化(如古希腊、埃及、伊斯兰等)以及媒介(如金、银、油画、陶瓷等)等类别,共计数百个细粒度标签。数据规模在10万到100万之间,分为训练集、验证集和测试集。该数据集适用于多标签分类、细粒度分类、长尾分布学习以及艺术/博物馆领域的图像理解研究。

The iMet Open Access Dataset (Metropolitan Museum of Art Collection Multi-label Attributes) is a dataset for multi-label image classification. It contains images of artworks from the Metropolitan Museum of Art in New York, each annotated with multiple attribute labels covering categories such as countries (e.g., Afghanistan, China, France), cultures (e.g., Ancient Greek, Egyptian, Islamic), and media (e.g., gold, silver, oil painting, ceramic), totaling hundreds of fine-grained labels. The dataset size ranges from 100k to 1M images, split into training, validation, and test sets. It is suitable for research on multi-label classification, fine-grained classification, long-tail distribution learning, and image understanding in the art/museum domain.
提供机构:
PyTorch Image Models
创建时间:
2026-09-29
搜集汇总
数据集介绍
imet-open-access 数据集图片
构建方式
该数据集源于纽约大都会艺术博物馆的开放获取馆藏,经系统化整理与专家标注构建而成。每件藏品被赋予多重属性标签,涵盖国家、文化、媒介等维度,形成精细的多标签分类体系。数据集被划分为训练集、验证集与测试集,并以图像及对应标签列表的形式存储,便于直接用于多标签图像分类模型的训练与评估。
使用方法
使用者可通过HuggingFace的datasets库直接加载数据,利用内置的config定义与划分进行训练或评估。输入图像经预处理后送入多标签分类模型,输出为多个标签的预测结果。该数据集适用于多标签分类、属性预测及艺术图像分析等任务,亦可结合迁移学习策略提升模型性能。
背景与挑战
背景概述
iMet Open Access数据集由纽约大都会艺术博物馆于2023年发布,旨在推动艺术图像的多标签分类研究。该数据集涵盖逾十万件藏品,标注了来源国家、文化归属和创作媒介三个维度的细粒度属性,为计算机视觉与数字人文的交叉研究提供了宝贵资源。其核心研究问题在于如何从视觉特征中同时识别多个艺术属性,并应对艺术领域固有的长尾分布与标注模糊性。该数据集的影响力在于促进了文化遗产的智能检索与跨文化理解,为艺术史学者和机器学习研究者搭建了桥梁。
当前挑战
该数据集面临的领域挑战在于艺术图像分类本身的多标签性与主观性,不同文化背景下的属性定义存在重叠与歧义,且长尾分布导致稀有类别样本稀缺,模型易偏向高频类别。构建过程中的挑战包括从博物馆元数据中提取标准化标签的复杂性,需处理多语言、历史术语不一致及标注缺失问题,同时确保图像质量与版权合规。此外,细粒度媒介分类涉及数百种材料,对特征提取和模型泛化能力提出了极高要求。
常用场景
经典使用场景
在计算机视觉与数字人文的交汇地带,iMet-open-access数据集凭借其来自大都会艺术博物馆的逾十万件藏品图像,成为多标签图像分类与细粒度属性预测的经典基准。每幅图像均标注有国家、文化及材质三级层次化标签,天然契合多标签学习范式,尤其适用于长尾分布下的视觉识别研究。研究者常以该数据集训练与评估模型对艺术品的多维度属性推断能力,涵盖国别归属、文化流派与制作媒材,推动文化遗产图像的自动化理解。
解决学术问题
该数据集直面艺术图像分析中的核心学术难题:如何在标注稀缺、类别极不平衡且语义层次复杂的条件下,实现稳健的多标签分类。它提供了大规模、高质量且富含文化元数据的真实馆藏图像,缓解了艺术领域长期缺乏标准化评测基准的困境。其长尾特性亦为研究类别不平衡学习、小样本泛化及层次化标签建模提供了理想试验场,对推动可解释的计算机视觉方法在文化遗产领域的应用具有深远意义。
实际应用
在博物馆数字化与智慧服务实践中,该数据集支撑诸多落地场景:自动为馆藏图像补全国别、文化与材质标签,提升元数据策展效率;辅助跨文化检索与虚拟展览的智能推荐;赋能艺术品真伪辅助鉴别与材质溯源分析。此外,教育机构与策展团队可借助基于该数据训练的分类模型,快速组织主题展览与学术研究,降低人工标注成本,促进公共文化资源的开放与可及。
数据集最近研究
最新研究方向
在数字人文与计算机视觉交叉领域,iMet Open Access数据集正推动着细粒度多标签艺术图像分类的前沿探索。该数据集源自纽约大都会艺术博物馆的开放获取馆藏,涵盖逾百国文化、数百种材质与流派标签,其长尾分布与多标签共现特性为模型鲁棒性研究提供了独特试验场。当前研究聚焦于利用视觉-语言预训练模型进行跨模态对齐,以缓解艺术史标注中的语义模糊与类别不平衡问题;同时,针对文化遗产领域的小样本与零样本学习亦成为热点,旨在实现未见过文化或材质的自动识别。该数据集不仅促进了博物馆藏品智能编目与跨馆检索技术的进步,还为算法公平性、文化表征多样性等伦理议题提供了实证基础,对推动包容性数字文化遗产研究具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

