
遇见数据集

amazon-from-space

收藏
Hugging Face2026-09-25 更新2026-09-26 收录
官方服务:

资源简介:

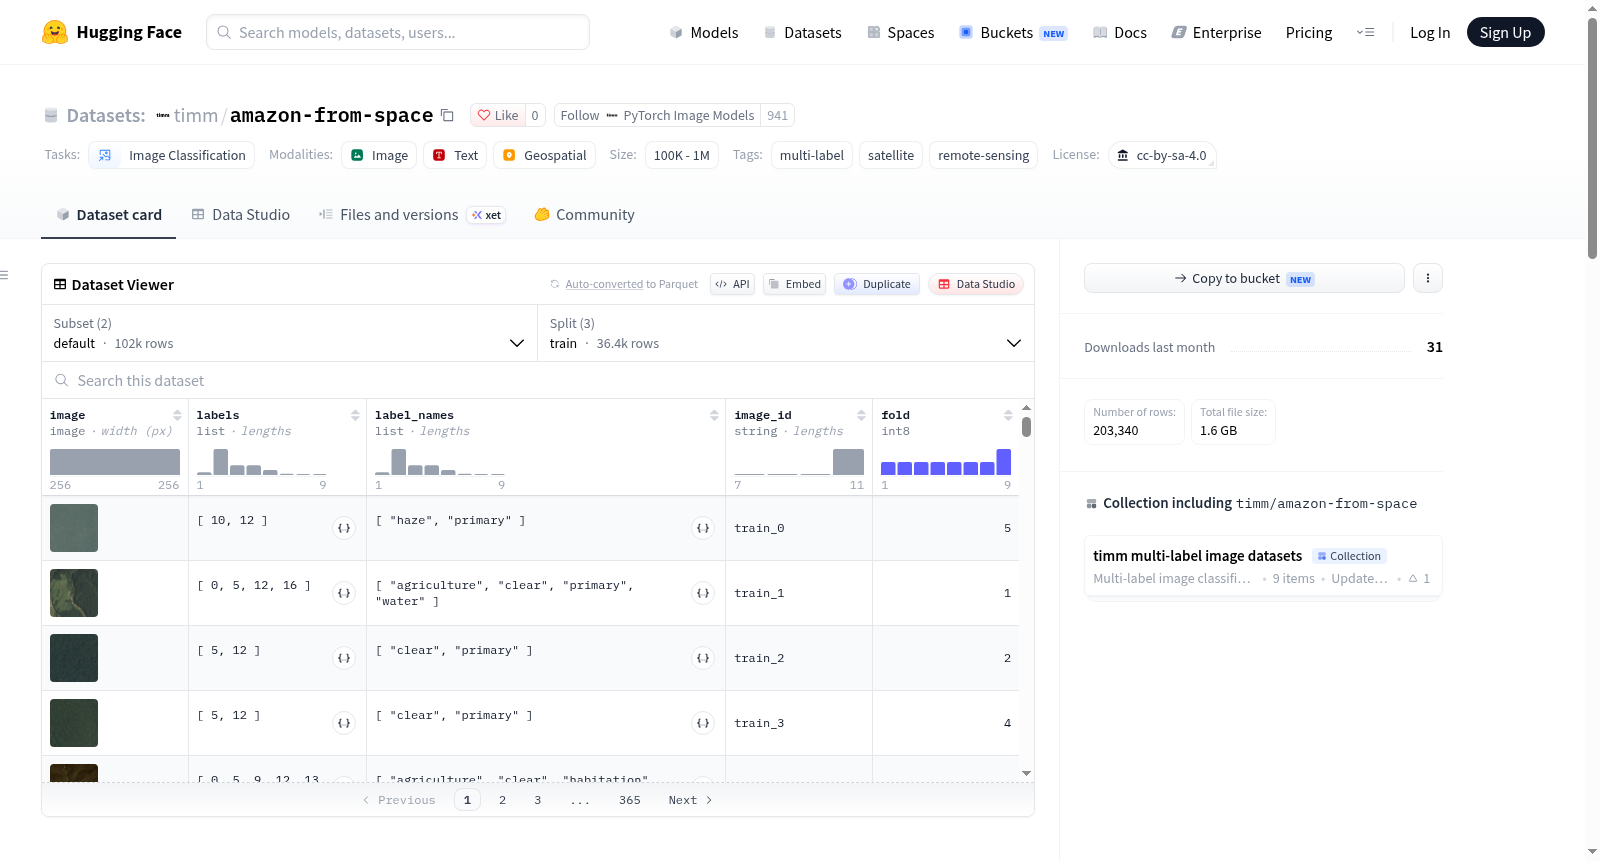
该数据集来源于Kaggle 2017年竞赛“Planet: Understanding the Amazon from Space”,提供JPG格式的卫星图像。图像为256×256像素的裁剪图,来自Planet公司的PlanetScope卫星对亚马逊流域的观测,地面采样距离约3米。每个图像被分配一个大气条件标签(clear、partly_cloudy、cloudy、haze),以及零个或多个土地覆盖/土地利用标签(共13类,包括常见类别如primary、water、agriculture、road、habitation、cultivation、bare_ground,以及稀有类别如slash_burn、selective_logging、blooming、conventional_mine、artisinal_mine、blow_down)。标注为cloudy的图像没有其他标签。数据集包含40,479张带标签的训练图像和61,191张未标记的测试图像。作者将训练图像采用多标签迭代分层方法划分为10折用于交叉验证。提供两种配置:default(训练、验证、测试分割)和folds(所有训练图像作为训练集,测试集独立)。特征字段包括:image(JPEG图像,注意原始文件为4通道CMYK,需转换为RGB)、labels(正标签的ClassLabel索引序列)、label_names(正标签名称列表)、image_id(原始文件名前缀)、fold(折索引,测试图像为null)。该数据集适用于多标签图像分类任务,竞赛评价指标为样本平均F2分数。

This dataset is from the 2017 Kaggle competition Planet: Understanding the Amazon from Space, providing satellite images in JPG (visual RGB) format. The images are 256×256 pixel crops from the PlanetScope satellite observations of the Amazon basin, with a ground sampling distance of about 3 meters. Each image is assigned an atmospheric condition label (clear, partly_cloudy, cloudy, haze) and zero or more land cover/land use labels (13 classes in total, including common ones like primary, water, agriculture, road, habitation, cultivation, bare_ground, and rare ones like slash_burn, selective_logging, blooming, conventional_mine, artisinal_mine, blow_down). Images labeled cloudy have no other labels. The dataset contains 40,479 labeled training images and 61,191 unlabeled test images. The authors split the training images into 10 folds using a multi-label iterative stratification method for cross-validation. Two configurations are provided: default (train, validation, test splits) and folds (all training images as train set, test set independent). Feature fields include: image (JPEG image; note that original files are 4-channel CMYK, need to be converted to RGB), labels (sequence of ClassLabel indices for positive labels), label_names (list of positive label names), image_id (original file name prefix), fold (fold index, null for test images). This dataset is suitable for multi-label image classification tasks, and the competition evaluation metric is sample-averaged F2 score.
提供机构:
PyTorch Image Models
创建时间:
2026-09-25
搜集汇总
数据集介绍
amazon-from-space 数据集图片
构建方式
该数据集源自2017年Kaggle竞赛“Planet: Understanding the Amazon from Space”,基于PlanetScope卫星星座获取的亚马逊流域多光谱影像构建。原始影像经预处理裁剪为256×256像素的切片,地面采样距离约3米,并以JPEG格式存储。每幅切片由专家标注一个大气标签(clear、partly_cloudy、cloudy或haze)及零个或多个土地覆盖/土地利用标签,共计17类。为支持模型稳健评估,40,479张有标注训练影像采用多标签迭代分层策略(Sechidis等,2011)划分为10个折,确保稀有类别在折间均匀分布。无标注测试集包含61,191张影像,其标签在竞赛后未公开,为半监督及迁移学习提供了大规模无监督样本。
特点
数据集的核心特性在于其多标签遥感场景分类任务属性,涵盖大气条件与土地覆盖的双重语义维度。标签体系设计精细,既包含clear、partly_cloudy等大气状态标签,又囊括primary、water、agriculture等常见地物类别,以及slash_burn、selective_logging等稀有事件类别,凸显了类别不平衡的挑战。影像源自真实卫星观测,保留了原始CMYK色彩空间,需经色彩空间转换方能正确显示,这一特性对数据加载流程提出了特定要求。此外,数据集提供标准化的10折交叉验证划分,每一折均保持多标签分布的近似均衡,为模型泛化性能的可靠评估奠定了坚实基础。
使用方法
该数据集借助HuggingFace datasets库加载,提供default与folds两种配置以适配不同实验需求。default配置将数据划分为训练集(折1-9,36,431张)、验证集(折0,4,048张)及测试集(61,191张无标签影像);folds配置则整合全部有标签影像,用户可通过过滤fold列实现k折交叉验证。数据字段包括图像、标签索引序列、标签名称、影像标识符及折索引。使用方法上,该数据集遵循timm库的多标签分类格式,用户可直接调用train.py与validate.py脚本,指定任务为multilabel、目标键为labels、类别数为17,并选择ResNet等骨干网络进行训练与验证。竞赛官方评估指标为样本平均F2分数,用户在模型评估时需采用相同指标以保持可比性。
背景与挑战
背景概述
亚马逊雨林作为地球之肺,其动态监测对全球生态平衡与碳循环研究具有不可替代的价值。2017年,Planet Labs与Kaggle联合发起“Planet: Understanding the Amazon from Space”竞赛,发布了基于PlanetScope卫星星座的amazon-from-space数据集。该数据集涵盖约3米地面采样距离的256×256像素影像切片,覆盖亚马逊流域多样地表覆盖类型,旨在通过多标签分类技术自动识别大气条件与土地利用状况。竞赛吸引了全球众多研究者参与,推动了遥感影像多标签分类与弱监督学习的发展,为森林砍伐预警、资源管理及生态保护提供了数据驱动的决策支持,在遥感与计算机视觉交叉领域产生了深远影响。
当前挑战
该数据集所应对的领域问题为遥感影像的多标签分类,具体挑战包括:大气条件(如云、雾)与地表覆盖类别之间的复杂耦合关系,导致标签关联性建模困难;稀有类别(如手工采矿、选择性采伐)样本极度稀缺,引发严重类别不平衡;影像中多标签共存且部分标签语义重叠,要求模型具备精细的语义区分能力。在构建过程中,原始JPG文件以CMYK色彩空间存储,需正确转换为RGB以避免颜色失真;竞赛测试集标签未公开,迫使研究者在有限标注数据下进行模型泛化;多标签迭代分层划分需确保稀有标签在折间均匀分布,以维持评估的可靠性。这些挑战共同构成了该数据集在遥感多标签分类研究中的核心难点。
常用场景
经典使用场景
在遥感图像解译领域,亚马逊雨林卫星图像数据集构成了多标签分类任务的经典基准,其核心使用场景在于训练深度学习模型对256×256像素的PlanetScope影像进行同时预测大气条件与地表覆盖类型。每幅影像被标注单一大气标签及零至多个土地覆盖标签,模型需在17个类别中精准识别,典型流程涉及卷积神经网络提取空间特征,并采用sigmoid激活函数处理多标签输出。该数据集独特的类别不平衡与标签共现特性,使其成为评估多标签遥感分类算法鲁棒性的标准平台,尤其适合研究稀有类别识别与大气干扰下的地物解析。
衍生相关工作
自2017年Kaggle竞赛发布以来,该数据集催生了大量经典工作,包括基于ResNet、DenseNet与SE-ResNeXt的多标签分类架构,以及结合注意力机制与类别平衡损失的改进方案。诸多研究探索了F2分数优化、迭代分层交叉验证与测试时增强策略。后续工作将预训练模型迁移至其他遥感数据集,如Plant Pathology 2021,并推动了timm库对多标签任务的标准接口支持。该数据集亦成为半监督与自监督学习在遥感领域的重要试验场,衍生出伪标签与对比学习等前沿方法。
数据集最近研究
最新研究方向
亚马逊雨林遥感监测作为全球碳循环与生物多样性保护的核心议题,近年来因实时森林砍伐预警和可持续土地治理需求而备受关注。amazon-from-space数据集依托PlanetScope约3米分辨率影像,涵盖17类大气与土地覆盖标签,成为多标签遥感分类与弱监督学习的重要基准。当前前沿研究聚焦于多标签迭代分层策略优化长尾分布下的稀有类别识别,以及结合时序卫星影像与深度学习模型提升热带雨林退化与采矿活动的检测精度。该数据集在Kaggle竞赛后持续推动遥感语义理解、跨模态对齐与模型鲁棒性评估,对全球森林监测政策与生态保护实践具有深远影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

