
遇见数据集

YuvrajSingh9886/bonsai-jetson-benchmark-15w

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

该数据集是一个基准测试结果数据集,用于评估Bonsai系列模型(包括Bonsai-1.7B、Bonsai-4B、Bonsai-8B、Ternary-Bonsai-1.7B、Ternary-Bonsai-4B和Ternary-Bonsai-8B)在NVIDIA Jetson Orin Nano Super 8GB平台上的推理性能。测试在15W功率模式下进行,使用llama.cpp后端和CUDA加速,通过不同提示词长度(256、512、1024、2048个词元)和生成词数(128、256、512个词元)的组合进行性能扫描。数据集包含多项性能指标,如平均首次词元时间(TTFT)、词元间延迟(ITL)、词元每秒(Tok/s)、功耗(Power)、每焦耳词元数(Tok/J)以及温度数据。数据集旨在为边缘AI设备上的模型推理效率和能耗提供详细基准测试结果。

This dataset is a benchmarking results dataset that evaluates the inference performance of the Bonsai model series (including Bonsai-1.7B, Bonsai-4B, Bonsai-8B, Ternary-Bonsai-1.7B, Ternary-Bonsai-4B, and Ternary-Bonsai-8B) on the NVIDIA Jetson Orin Nano Super 8GB platform. The tests were conducted in a 15W power mode using the llama.cpp backend with CUDA acceleration, sweeping through combinations of different prompt token lengths (256, 512, 1024, 2048 tokens) and generation token counts (128, 256, 512 tokens). The dataset includes various performance metrics such as average Time to First Token (TTFT), Inter-Token Latency (ITL), tokens per second (Tok/s), power consumption (Power), tokens per joule (Tok/J), and thermal data. The dataset aims to provide detailed benchmarking results for model inference efficiency and energy consumption on edge AI devices.
提供机构:
YuvrajSingh9886
搜集汇总
数据集介绍
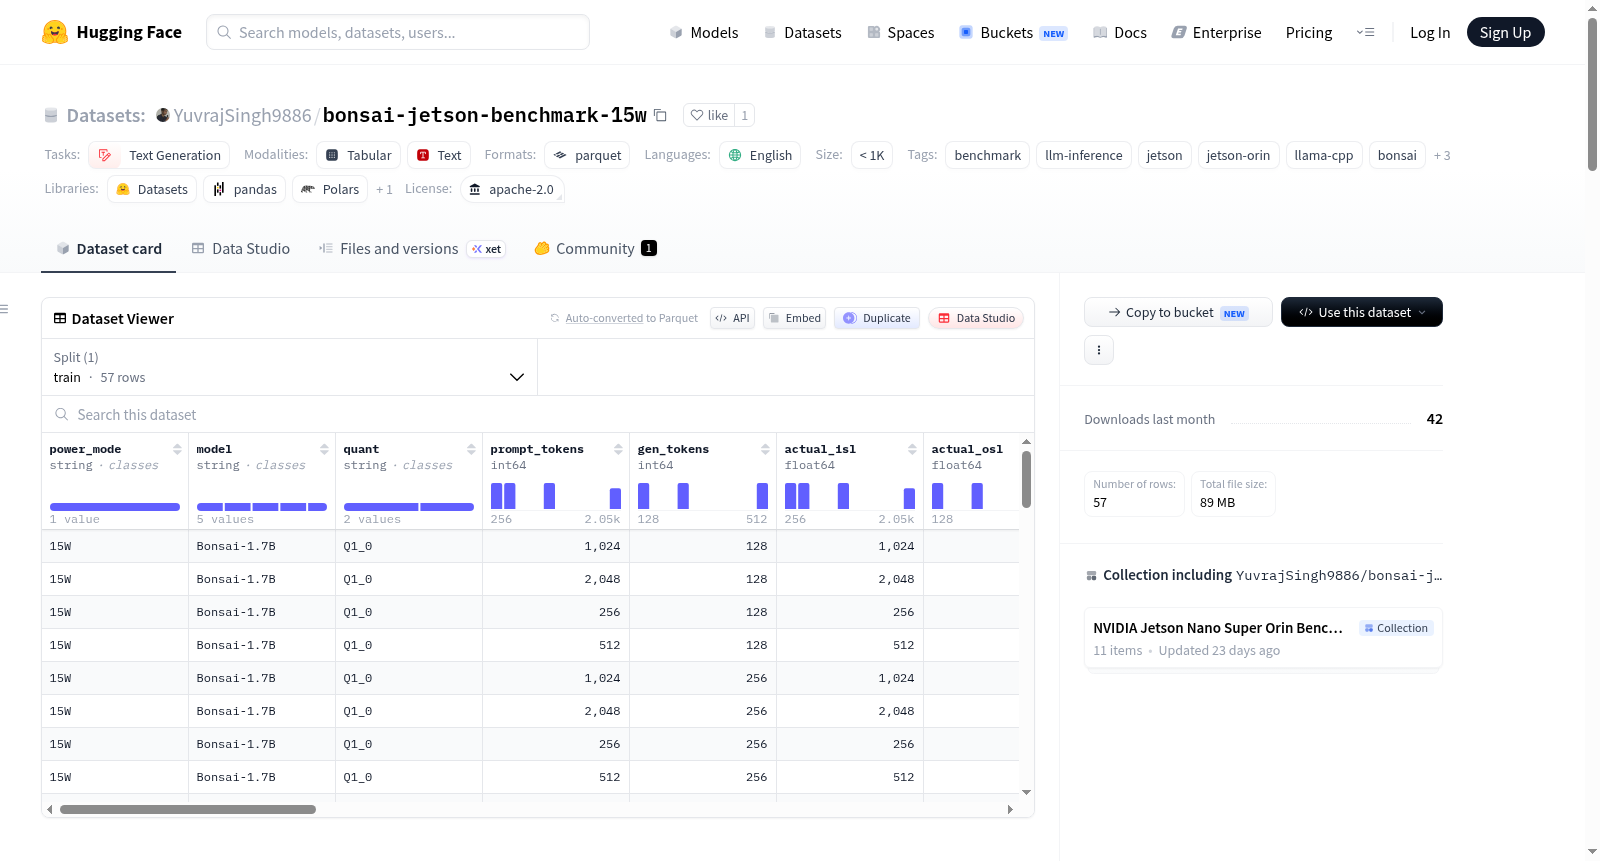
YuvrajSingh9886/bonsai-jetson-benchmark-15w 数据集图片
构建方式
该数据集专为评估极限压缩大语言模型在边缘设备上的推理能效而构建,聚焦于NVIDIA Jetson Orin Nano Super 8GB平台在15W功耗模式下的性能表现。测评以llama.cpp为后端,启用CUDA加速并加载全部层至GPU,针对Bonsai系列1.7B、4B、8B及三元Bonsai系列共五款模型,分别施加1比特Q1_0与2比特Q2_0量化。实验设计了256至2048 token的提示长度与128至512 token的生成长度组合矩阵,每种组合执行20次请求以降低随机波动,共完成57种配置的全面扫描。核心能效指标tok/J由输出吞吐率除以VDD_CPU_GPU_CV功耗获取,所有结果收录于Parquet格式文件中。
使用方法
研究者可通过Hugging Face数据集加载器直接读取Parquet格式的多列数据,涵盖model、quant、prompt_tokens、gen_tokens、ttft_avg_ms、itl_avg_ms、tok_s、power_w、tok_j及avg_temp_c等关键字段。适用于横向对比不同模型在相同功耗约束下的性价比、纵向分析提示长度对延迟与能效的影响趋势,或作为边缘端大模型部署时量化方案选择的参考依据。数据集还附带Per-Model Best Tok/J与热力摘要表,便于快速定位最优配置;用户亦可基于原始请求记录复现实验或扩展至其他Jetson平台及功耗模式。
背景与挑战
背景概述
在边缘智能计算领域,如何在不牺牲推理性能的前提下实现大语言模型在功耗受限设备上的高效部署,已成为一个亟待突破的核心瓶颈。Bonsai Jetson Benchmark — 15W 数据集由研究团队于2025年创建,依托NVIDIA Jetson Orin Nano Super 8GB平台,系统评估了Bonsai系列与Ternary-Bonsai系列量化模型在15W功耗模式下的推理效率。其核心研究问题聚焦于探索极端量化精度(1-bit及1.58-bit三元量化)对模型能效比(tok/J)的影响,为低功耗边缘AI部署提供了宝贵的量化参考。该数据集通过标准化测试协议(涵盖多种提示与生成长度组合),首次揭示了在紧凑型边缘设备上,1.58-bit三元量化模型可实现高达11.5 tok/J的能效表现,远超传统方案,对推动实时、高能效的本地化语言模型应用具有重要示范意义。
当前挑战
该数据集所应对的领域挑战在于,边缘设备面临严格的功耗与散热约束,常规大语言模型因内存带宽与计算密度需求过高,难以在15W级平台上实现流畅推理。数据集的构建过程亦充满技术挑战:首先,模型兼容性存在显著差异,如Bonsai-8B与Ternary-Bonsai-4B/8B在实验因服务器启动失败而被跳过,表明极端量化与硬件驱动栈(JetPack R36.4.7)之间的适配远非鲁棒;其次,热管理与功耗测量需精确同步,实验记录了GPU与CPU温度曲线(峰值达69.2°C)并确认无降频(Throttled: No),但维持热平衡的散热策略仍需针对不同模型动态调整;此外,多维度参数空间(5种模型×4种提示长度×3种生成长度×20次请求)的遍历测试对自动化框架的可靠性与重复性提出了极高标准,数据采集过程中的任何偶然遗漏都可能影响基准结果的普适性。
常用场景
经典使用场景
该数据集专为在边缘设备上评估大语言模型的推理效率与能效而设计,尤其聚焦于NVIDIA Jetson Orin Nano Super 8GB平台在15W功耗模式下的表现。通过系统测量不同模型(如Bonsai系列与Ternary-Bonsai系列)在多种提示与生成长度组合下的首令牌延迟、令牌间延迟、吞吐量、功耗及能效指标(tok/J),该数据集为研究极低比特量化模型(1-bit与1.58-bit)在资源受限硬件上的部署可行性提供了详实基准。经典使用场景涵盖对比不同量化策略对推理速度与能耗的影响,以及分析提示长度与生成长度对端到端延迟和能效的交互效应。
解决学术问题
该数据集有效解决了边缘AI领域中模型压缩与硬件适配之间的量化评估难题。传统研究常依赖理论计算或理想化模拟来评估低比特模型,而该数据集通过真实硬件实测,揭示了1-bit与1.58-bit量化模型在功耗、温度与推理性能之间的复杂权衡。它帮助学术界明确了如Ternary-Bonsai-1.7B在15W功耗下可达到11.5 tok/J的惊人能效,而较大模型(如8B)则因内存不足而无法运行。这一实证数据为探索边缘设备上大语言模型的高效部署阈值、量化位宽对推理效率的影响规律,以及热管理对持续推理能力的限制提供了关键依据,推动了边缘AI从理论走向工程实践。
实际应用
实际应用中,该数据集直接服务于在低功耗边缘设备上部署大语言模型的产品设计与优化工作。例如,智能机器人、无人机巡检、车载语音助手等场景,往往需要在有限电池和散热条件下实现实时文本生成。开发团队可借助该数据集的能效基准,选择在Jetson Orin Nano平台上以15W模式运行的理想模型与量化格式,如选择Ternary-Bonsai-1.7B以在低延迟和高能效间取得平衡。此外,该数据集还可用于指导边缘AI设备的功耗规划,例如基于负载调整推理批处理大小以避免过热降频,从而保障服务稳定性。
数据集最近研究
最新研究方向
该数据集聚焦于极端量化生成模型在边缘设备上的能效前沿,通过测量每焦耳生成token数(tok/J)这一核心指标,揭示了1.58比特三元网络(Ternary-Bonsai-1.7B)在15瓦功耗墙下可达11.5 tok/J的惊人效率,相较传统1比特模型提升约2倍。这一发现与当前大模型部署向低功耗、高能效边缘端迁移的热点趋势紧密呼应,尤其是在机器人、无人机和物联网场景中,突破性的能量效率意味着在有限热设计功耗内实现实时推理成为可能。数据集系统性地覆盖了不同提示-生成长度组合与量化策略,为未来极低比特神经网络架构设计和对功耗敏感的预训练模型选型提供了基准参考,对推动绿色AI普惠落地具有重要指导意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

