
遇见数据集

YuvrajSingh9886/bonsai-jetson-benchmark-maxn

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

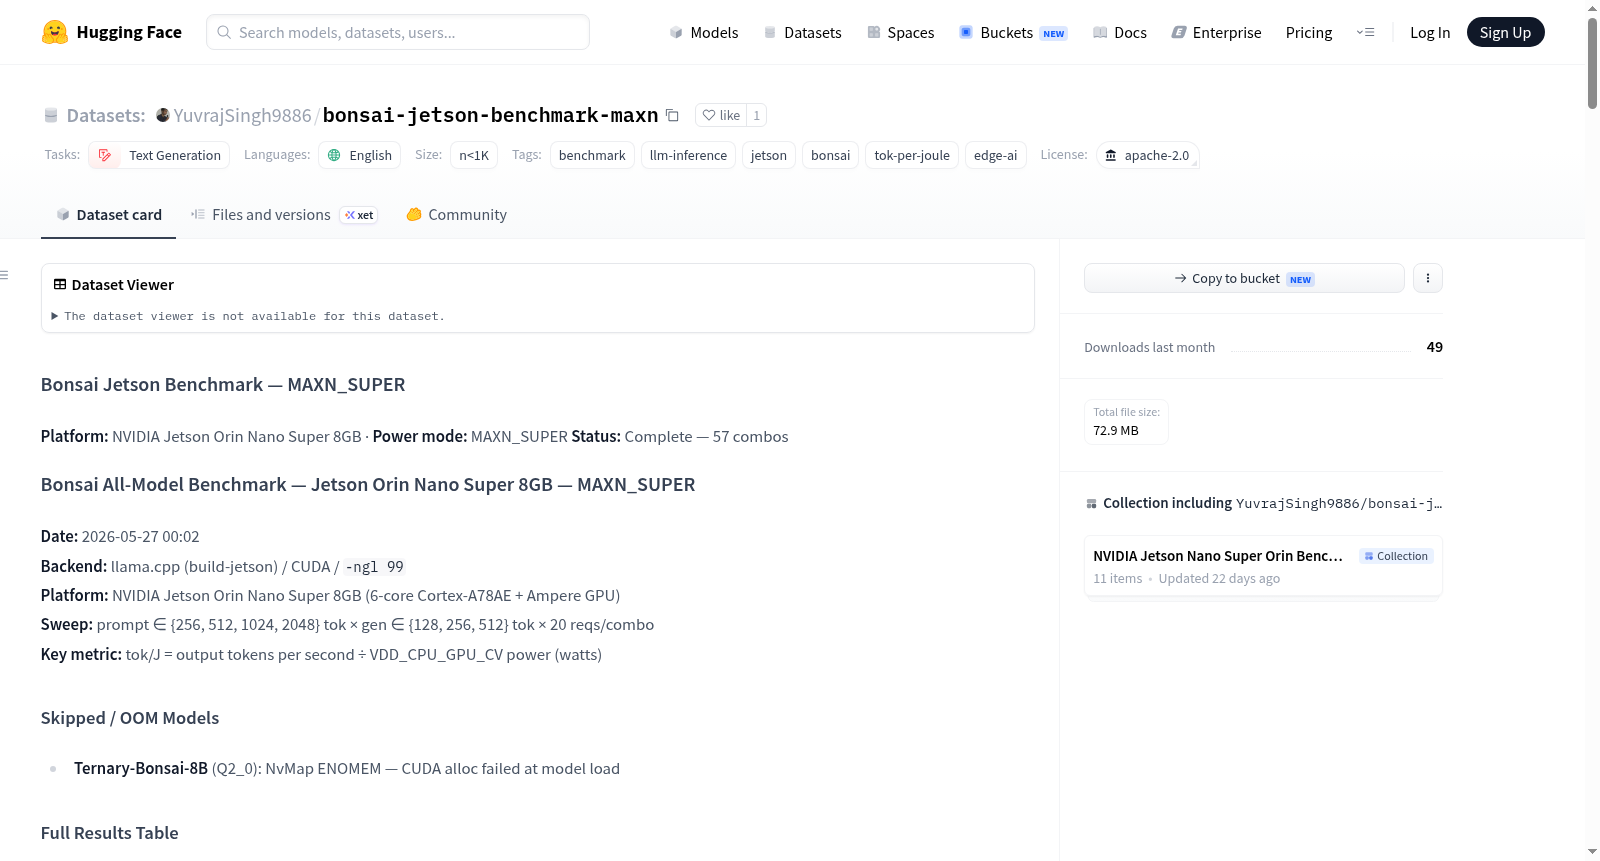
Bonsai Jetson Benchmark数据集是一个性能基准测试数据集,专注于在NVIDIA Jetson Orin Nano Super 8GB边缘AI平台上评估Bonsai系列语言模型(包括1.7B、4B、8B参数版本及其Ternary变体)的推理效率。测试在MAXN_SUPER电源模式下进行,使用llama.cpp后端和CUDA加速,覆盖多种量化配置(如Q1_0、Q2_0)、输入token长度(256、512、1024、2048)和输出token长度(128、256、512)。数据集的核心指标是每焦耳输出token数(Tok/J),用于衡量能效,同时记录时间到首个token(TTFT)、token到token延迟(T2T)、吞吐量(Tok/s)、请求延迟和功率消耗等详细性能数据。数据以表格形式呈现,包括完整结果表和每个模型的最佳配置摘要,旨在为边缘设备上的LLM推理优化提供参考。

The Bonsai Jetson Benchmark dataset is a performance benchmarking dataset focused on evaluating the inference efficiency of the Bonsai series language models (including 1.7B, 4B, 8B parameter versions and their Ternary variants) on the NVIDIA Jetson Orin Nano Super 8GB edge AI platform. Tests are conducted in MAXN_SUPER power mode using the llama.cpp backend with CUDA acceleration, covering various quantization configurations (e.g., Q1_0, Q2_0), input token lengths (256, 512, 1024, 2048), and output token lengths (128, 256, 512). The core metric of the dataset is tokens per joule (Tok/J) to measure energy efficiency, along with detailed performance data such as time to first token (TTFT), token-to-token latency (T2T), throughput (Tok/s), request latency, and power consumption. The data is presented in tabular form, including a full results table and a summary of optimal configurations per model, aiming to provide references for LLM inference optimization on edge devices.
提供机构:
YuvrajSingh9886
搜集汇总
数据集介绍
YuvrajSingh9886/bonsai-jetson-benchmark-maxn 数据集图片
构建方式
该数据集源自对NVIDIA Jetson Orin Nano Super 8GB开发板在MAXN_SUPER功耗模式下的大规模推理性能基准测试。测试工作围绕llama.cpp推理后端与CUDA加速环境展开,覆盖了Bonsai与Ternary-Bonsai系列模型(含1.7B、4B及8B参数量级)在不同量化策略(Q1_0与Q2_0)下的表现。实验设计了分层扫描方案:提示长度(prompt)遍历256、512、1024、2048 tokens,生成长度(gen)横跨128、256、512 tokens,每种组合重复20次请求以保障统计稳健性,最终形成57组有效测试数据,并以Parquet格式高效存储。
使用方法
用户可直接从HuggingFace数据集仓库加载`data/results.parquet`文件,利用Pandas或DuckDB等工具读取表结构,按`Model`、`Quant`、`ISL`(提示长度)和`OSL`(生成长度)字段过滤所需子集。推荐聚焦`Tok/J`列进行能效比较,结合`Power (W)`与`Tok/s`开展功耗—性能联合分析。对于OOM标记的条目,建议在解读时排除或单独标注。数据集的API与拆分设计简单明了,仅含`train`单一拆分,便于快速集成至边缘AI推理的选型或调优流程。
背景与挑战
背景概述
该数据集由Bonsai团队于2026年创建,聚焦于NVIDIA Jetson Orin Nano Super 8GB边缘计算平台上的大语言模型推理性能评估。核心研究问题在于量化不同规模模型(从1.7B到8B参数)在极端量化(Q1_0、Q2_0)条件下的能量效率与实时性权衡,尤其以tok/J(每焦耳输出令牌数)作为关键能效度量指标。该工作填补了边缘设备上LLM部署基准测试的空白,为低功耗、高吞吐场景下的模型选型提供了系统化的实测依据,对边缘AI领域的硬件优化与算法设计具有显著推动作用。
当前挑战
所解决的领域问题包括:1)在资源受限的边缘设备上,如何在模型精度、推理速度与功耗之间取得平衡,例如8B模型在MAXN_SUPER模式下因内存不足(OOM)无法加载,揭示了显存容量对大规模模型的严格约束;2)现有基准测试多聚焦于云端,缺乏针对嵌入式GPU平台的标准化能耗效率评估方法。构建过程中遭遇的挑战:1)需在固定CPU+GPU电压轨下跨256至2048令牌的提示长度与128至512令牌的生成长度进行组合扫掠(共57种配置),确保统计显著性;2)部分极低位宽量化模型(如Ternary-Bonsai-8B Q2_0)在负载阶段触发CUDA内存分配失败,导致完整数据缺失,暴露了异构存储器管理的复杂性。
常用场景
经典使用场景
在边缘人工智能领域,对大型语言模型在资源受限设备上的推理效能进行量化评估是近年来的研究热点。该数据集专为NVIDIA Jetson Orin Nano Super平台设计,系统收集了Bonsai系列模型在不同量化精度(Q1_0、Q2_0)、提示长度(256至2048 token)及生成长度(128至512 token)组合下的推理性能指标。其核心价值在于提供每焦耳能量所产生的输出token数(tok/J)这一综合性效能度量,从而为在边缘设备上部署大语言模型时,模型选择、量化策略制定及功耗优化提供详实的实验依据。
解决学术问题
该数据集有效解决了边缘计算场景下大语言模型推理效率与能效比难以精确量化的学术难题。现有研究多聚焦于云端服务器性能,缺乏对嵌入式平台在多样化负载条件下的系统性基准测试。通过覆盖首次token延迟(TTFT)、token间延迟(ITL)、端到端吞吐量以及CPU+GPU复合功耗等关键指标,本数据集使得研究者能够在固定硬件平台上严谨对比不同模型结构与量化方案的能源效率。这对于推动绿色AI计算、延长电池驱动设备续航、以及实现高精度模型在低功耗场景中的落地具有重要的方法论意义。
实际应用
在实际应用中,此数据集可作为机器人、无人机及工业检测等移动或嵌入式系统中部署大语言模型的参考指南。开发者能够依据数据集中的最佳tok/J配置(例如Bonsai-1.7B在Q1_0量化下获得的5.127 tok/J峰值效能)来选择合适的模型变体与推理参数,从而在有限的功耗预算内最大化处理能力。此外,数据集中的热管理数据(如峰值结温)还可协助工程团队优化散热方案,确保设备在持续推理任务中的热稳定性与长期可靠性。
数据集最近研究
最新研究方向
该数据集聚焦于NVIDIA Jetson Orin Nano Super 8GB这一边缘计算平台上的大语言模型推理能效基准测试,通过全面评估不同规模(1.7B至8B参数)和量化策略(Q1_0、Q2_0)的Bonsai及Ternary-Bonsai系列模型在多种提示与生成长度组合下的性能表现,揭示了边缘AI硬件上推理吞吐量与能耗之间的微妙平衡。研究发现,以tokens per joule为核心指标的能效优势在小模型与短生成任务中尤为显著,而大规模模型在极致量化下仍面临内存溢出挑战。这一工作直接回应了当前边缘AI部署中模型小型化、高效量化与实时性需求的紧迫矛盾,为在资源受限设备上实现本地化智能推理提供了实证依据,推动了AI从云端向终端迁移的实用化进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

