遇见数据集

dev_set_v2_a1_stackexchange_tezos_20260815_025223

收藏
Hugging Face2026-08-16 更新2026-08-17 收录
官方服务:

资源简介:

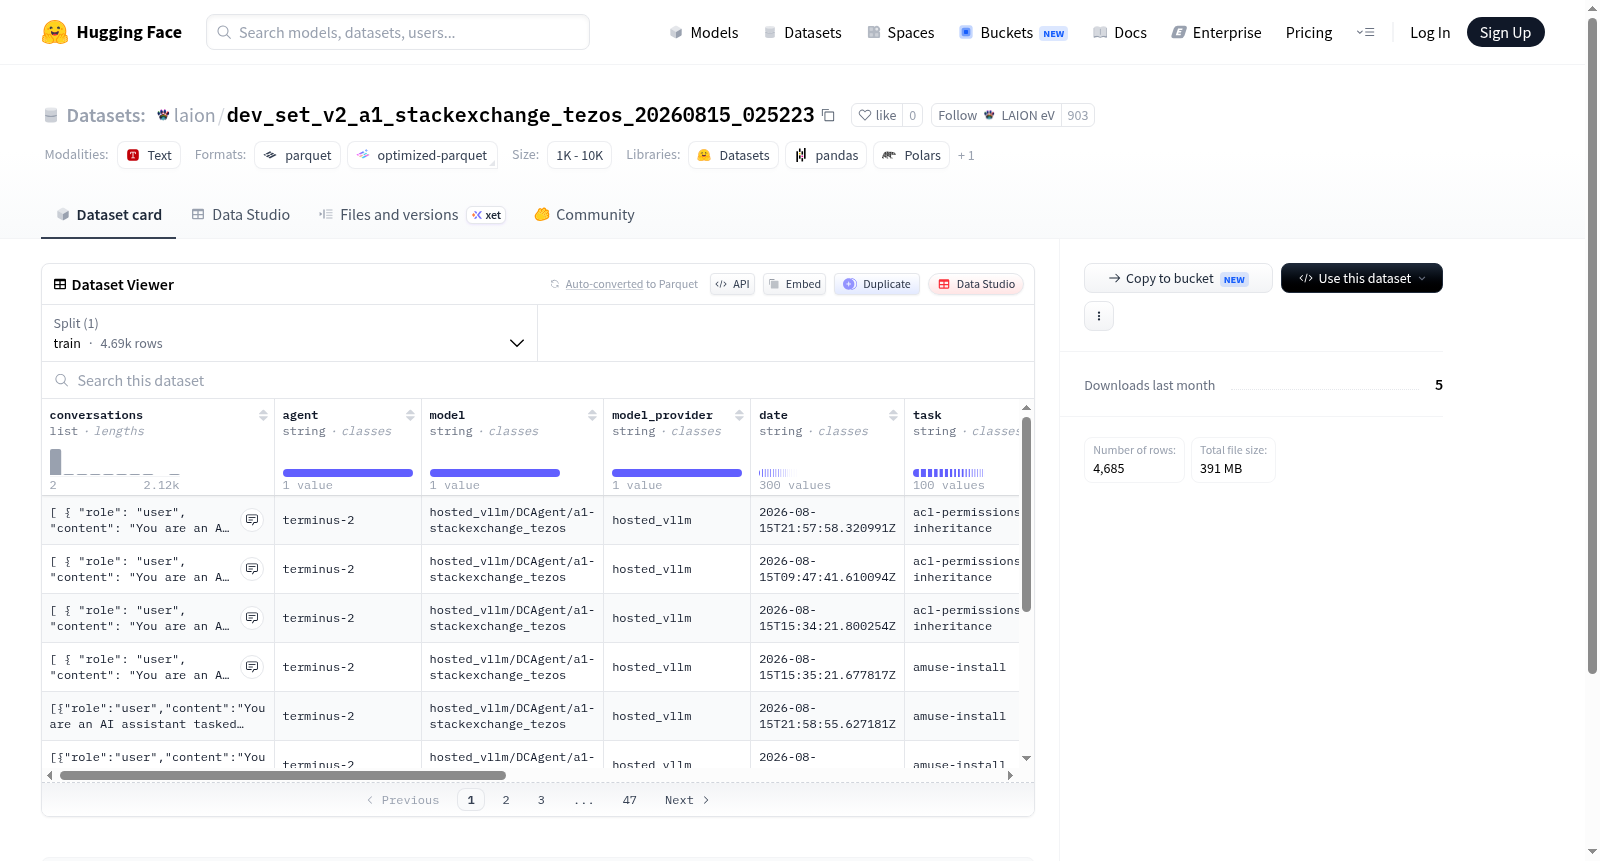
该数据集包含4685个样本,每个样本记录了一次智能体或模型参与的对话交互过程。数据字段包括:多轮对话内容(conversations,含角色和文本)、智能体名称(agent)、使用的模型(model)及其提供商(model_provider)、日期(date)、任务类型(task)、轮次(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及跟踪来源(trace_source)。数据集可用于研究对话系统、智能体行为分析、任务执行跟踪等场景。

This dataset contains 4685 samples, each recording a conversation interaction process involving an agent or model. The data fields include: multi-turn conversation content (conversations, containing roles and text), agent name (agent), model used (model) and its provider (model_provider), date (date), task type (task), episode (episode), run ID (run_id), trial name (trial_name), result (result), verifier output (verifier_output), and trace source (trace_source). The dataset can be used for research in dialogue systems, agent behavior analysis, task execution tracking, etc.

提供机构:
LAION eV
创建时间:
2026-08-16
原始信息汇总

数据集概述:dev_set_v2_a1_stackexchange_tezos_20260815_025223

该数据集由LAION提供,来源于StackExchange平台,内容聚焦于Tezos相关话题,创建时间为2026年8月15日。以下为数据集的详细结构说明。

数据集基本信息

  • 数据集名称:dev_set_v2_a1_stackexchange_tezos_20260815_025223
  • 提供方:LAION
  • 数据来源:StackExchange(Tezos相关讨论)
  • 数据集大小:约440 MB(下载大小约390 MB)
  • 数据划分:仅包含训练集(train)

数据规模

划分 样本数量 数据字节数
训练集 4,685 条 440,377,972 字节

数据字段说明

该数据集包含以下15个字段:

字段名 类型 说明
conversations 列表 对话记录,包含两个子字段:<br>- role(string):角色标识<br>- content(string):对话内容
agent 字符串 智能体标识
model 字符串 使用的模型名称
model_provider 字符串 模型提供方
date 字符串 日期信息
task 字符串 任务类型
episode 字符串 会话轮次/集数
run_id 字符串 运行标识
trial_name 字符串 试验名称
result 字符串 结果信息
verifier_output 字符串 验证器输出
trace_source 字符串 追踪来源

数据特点

  • 对话结构:每条数据包含多轮对话(conversations列表),每轮对话明确了角色和内容。
  • 元信息丰富:额外记录了模型、任务、运行参数、验证输出、追踪来源等元数据,便于复现分析与质量评估。
  • 单一划分:数据仅提供训练集,未划分验证集或测试集。
搜集汇总
数据集介绍
dev_set_v2_a1_stackexchange_tezos_20260815_025223 数据集图片
构建方式
该数据集名为dev_set_v2_a1_stackexchange_tezos_20260815_025223,是基于Stack Exchange平台中Tezos专题板块的对话数据构建而成。数据集的构建过程融合了多轮对话的采集与多维度信息的标注,每条样本包含完整的conversations对话序列,并辅以agent、model、model_provider等元数据,以及date、task、episode、run_id、trial_name等实验追踪信息。此外,还集成了result、verifier_output和trace_source等验证与溯源字段,确保了数据在生成、评估和追溯方面的完整性。数据集划分为训练集,包含4685个样本,总大小约为440MB,体现了其在规模上的充实性与实用性。
特点
该数据集的核心特点在于其丰富的结构化信息与多维度标注体系。对话内容以角色交替的形式呈现,清晰记录了用户与助手的交互过程,适合于对话生成与理解任务。数据集不仅包含基本的对话文本,还整合了模型来源(model与model_provider)、实验配置(task、episode、run_id、trial_name)以及结果验证(result、verifier_output)等关键属性,为研究模型性能、提升对话质量以及进行可复现实验提供了坚实的数据基础。此外,数据来源于Stack Exchange这一真实社区,内容涉及Tezos区块链技术,兼具专业性与真实性,有助于领域相关的模型微调与评估。
使用方法
该数据集的使用方法灵活多样,适用于监督微调、对话系统训练与评估等场景。用户可通过HuggingFace datasets库加载数据,使用默认配置中的train划分进行训练。由于数据包含完整的conversations字段,可直接用于构建输入-输出对的序列到序列模型训练。同时,元数据中的task和episode字段可支持多任务学习或分集训练,而run_id和trial_name则便于进行实验比较与结果追溯。对于对话质量的自动化评估,可利用verifier_output字段作为参考信号。因此,该数据集既适合学术研究中的模型迭代,也适用于工业界的实际应用开发。
背景与挑战
背景概述
该数据集(dev_set_v2_a1_stackexchange_tezos_20260815_025223)由专注于区块链技术生态的研究团队于2026年8月创建,旨在构建一个面向Tezos区块链社区的高质量对话数据集。它基于Stack Exchange平台的真实用户交互,整合了多轮对话、任务类型、模型输出及验证结果等丰富元数据,为评估和优化对话系统在特定领域(如智能合约、共识机制)的表现提供了基准。该数据集的发布填补了区块链垂直领域对话数据稀缺的空白,对推动领域自适应语言模型的研究具有重要价值,尤其在提升技术问答系统的准确性与鲁棒性方面。
当前挑战
该数据集所解决的领域挑战在于技术社区问答的复杂性与专业性,包括处理多义术语、长尾技术问题及跨学科知识融合,同时需确保对话逻辑的连贯性和事实准确性。在构建过程中,挑战主要来自数据清洗与去重以保留高质量交互、平衡不同话题分布以减少偏差,以及设计有效的验证机制(如verifier_output)来标注响应质量。此外,多轮对话的上下文管理、不同模型输出的一致性问题,以及时间跨度的动态性(如协议更新)也为数据集的构建与后续维护增添了难度。
常用场景
经典使用场景
该数据集汇聚了Stack Exchange平台上关于Tezos区块链的丰富问答对话,起源于真实开发者与用户的交互历史。其经典使用场景聚焦于训练和评估对话式AI系统,尤其是针对区块链技术领域的智能问答与技术支持助手。研究人员利用其高保真的多轮对话结构,微调大语言模型以精准理解Tezos相关的技术细节,诸如智能合约编写、共识机制、链上治理等复杂议题。数据集中每条样本均包含角色标注及完整上下文,为构建具有领域适应性的对话系统提供了理想的语料基础,在学术探索中常作为基准测试集,检验模型在特定垂直领域内的知识覆盖与推理能力。
衍生相关工作
此数据集的推出衍生了一系列脍炙人口的学术与工业成果,在模型层面,研究者基于其开发了专用版本的Tezos大语言模型(如TezosLLM),通过领域适配训练在代码生成与问答任务上取得卓越性能。在方法论层面,该数据集激发了关于‘可验证对话生成’的研究,催生了集成外部验证器(如形式化验证工具)的混合对话系统。国际上,多个区块链技术研讨会将其纳入挑战赛任务,推动了面向加密货币生态的上下文感知应答模型演进。此外,数据集中的多轮对话轨迹也启发了强化学习研究工作,用于训练具备自我修正能力的智能体,使AI系统在处理模糊技术查询时能主动确认需求并迭代优化回复质量,从而树立了垂直领域数据集的示范范式。
数据集最近研究
最新研究方向
该数据集聚焦于区块链公链Tezos生态中的对话式任务求解,其最新研究方向在于利用大规模多轮交互数据(包含agent、模型、验证者输出等元信息)推动大语言模型在特定领域(如智能合约开发、链上治理)的指令微调与对齐优化。通过引入带验证反馈的轨迹(trace_source)和结果标注(result),研究正探索如何结合强化学习与可验证奖励信号,提升模型在复杂技术问答中的鲁棒性与事实一致性。这一方向与当前AI对齐和可验证推理的热点紧密相连,为构建专业领域可信赖的智能助手提供了高质量基准,对促进区块链技术的大众化应用具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务