
遇见数据集

zayn-burrito/countdown-cas-control

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

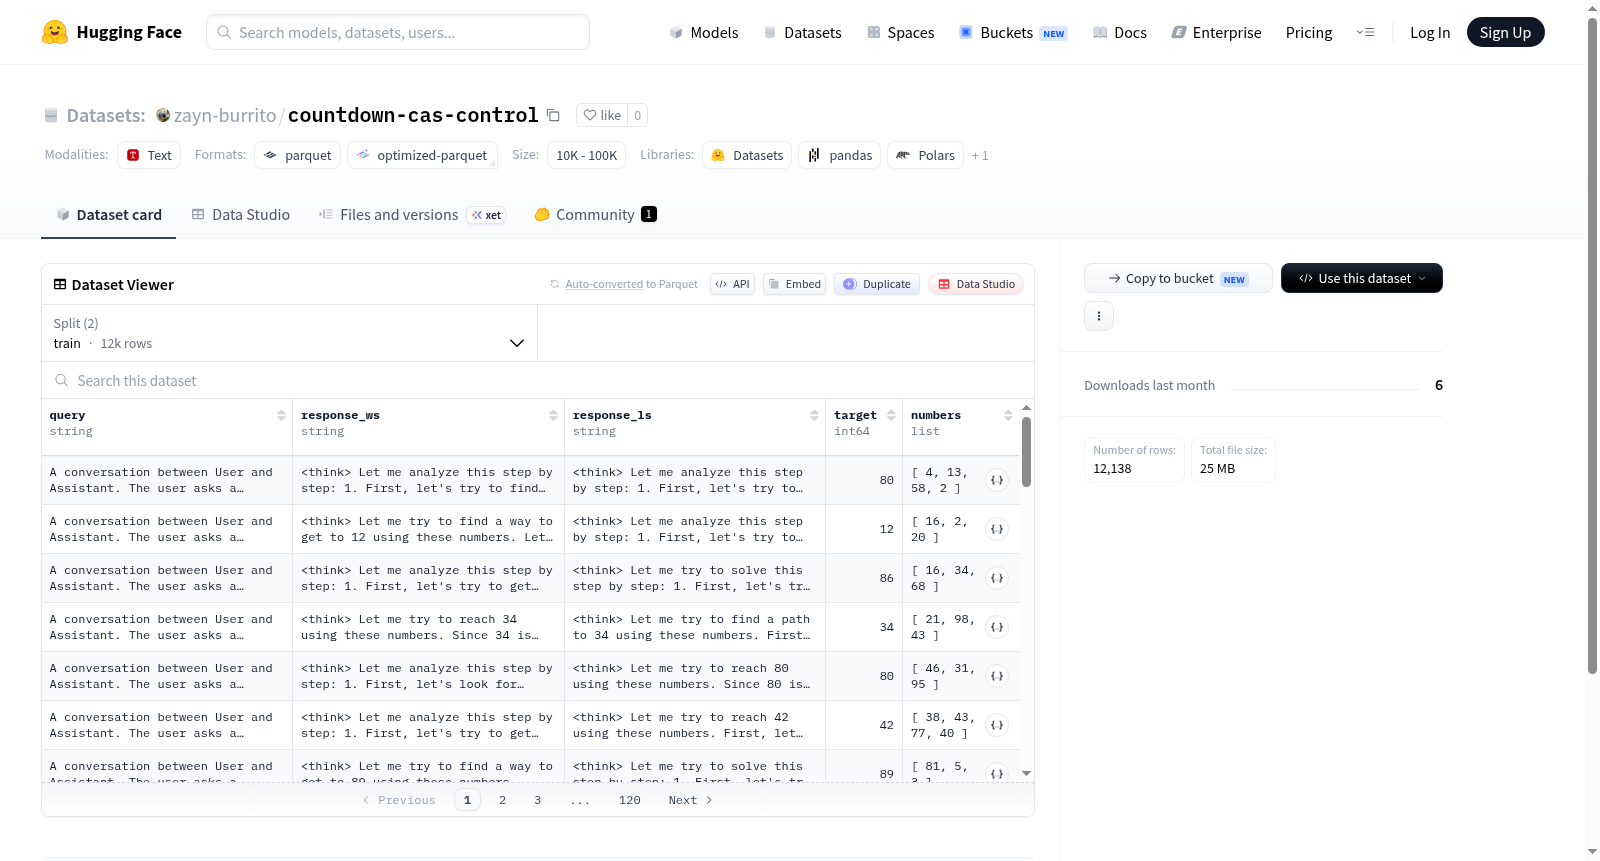
该数据集包含查询和响应对比数据,用于可能涉及排名、比较或偏好学习任务。每个示例包含一个查询(query)、两个响应(response_ws和response_ls,可能分别代表胜者和失败者响应)、一个目标整数(target)和一个整数列表(numbers)。数据集分为训练集(12,000个示例)和测试集(138个示例),适用于机器学习模型训练和评估,但具体应用领域(如对话系统、推荐系统或自然语言处理任务)未在README中明确说明。

This dataset contains query and response comparison data, potentially for tasks involving ranking, comparison, or preference learning. Each example includes a query, two responses (response_ws and response_ls, possibly representing winner and loser responses), a target integer, and a list of integers. The dataset is split into a training set (12,000 examples) and a test set (138 examples), suitable for machine learning model training and evaluation, but the specific application domain (such as dialogue systems, recommendation systems, or natural language processing tasks) is not explicitly stated in the README.
提供机构:
zayn-burrito
搜集汇总
数据集介绍
zayn-burrito/countdown-cas-control 数据集图片
构建方式
Countdown-CAS-Control数据集旨在为大型语言模型的推理能力评估提供基准。其构建基于倒计时游戏规则,通过给定一组数字,要求模型利用四则运算组合得到目标值。数据集中每条样本包含查询(query)、两种不同推理策略的回应(response_ws与response_ls)、目标数值(target)以及参与运算的数字序列(numbers)。训练集与测试集分别包含12000条和138条样本,确保了模型学习的充分性与评估的泛化性。
特点
该数据集的显著特点在于其双回应设计,同时提供工作空间(response_ws)与潜在空间(response_ls)两种推理路径,便于研究者对比分析不同推理机制下的模型表现。目标值与数字序列的明确标注,使得数据集不仅适用于监督学习,还可用于强化学习中的奖励建模。此外,紧凑的测试集规模(138例)保证了评估的高效性,同时避免了数据泄露风险。
使用方法
使用Countdown-CAS-Control数据集时,研究者可直接加载训练与测试划分。典型流程包括:以query字段作为输入,引导模型生成符合游戏规则的推理步骤;通过对比response_ws与response_ls,评估模型在显式与隐式推理范式下的准确性。目标值(target)可作为评判依据,数字序列(numbers)则用于验证运算合理性。该数据集特别适合用于探索链式思考(Chain-of-Thought)与内部推理表征的关联性实验。
背景与挑战
背景概述
countdown-cas-control数据集由某研究团队创建,旨在支持语言模型在数学推理任务中的评估与训练。该数据集以数字推理为核心研究问题,要求模型基于给定的数字集合通过特定运算达到目标值,类似于经典的‘Countdown’游戏。数据集包含约12000条训练样本和138条测试样本,每条记录包含查询语句、两种不同推理步骤(response_ws与response_ls)以及目标值。该数据集为评估语言模型的符号推理能力提供了标准化基准,对推动神经符号系统、强化学习与推理可解释性等方向的研究具有重要意义。
当前挑战
当前数据集面临的核心挑战包括:其一,数学推理任务本身对模型的分步逻辑与计算精度要求极高,现有语言模型在处理复杂数值运算时仍易产生符号错误或违反约束的推理路径。其二,数据构建过程中需确保推理步骤的多样性与正确性,但人工标注大规模链式推理示例成本高昂,且不同标注策略(如response_ws与response_ls两种格式)之间的语义一致性难以完全保证。此外,如何设计评估指标以公平衡量模型在有限样本上的泛化能力,仍是领域内待解决的关键问题。
常用场景
经典使用场景
在数理逻辑与认知科学交错的疆域中,countdown-cas-control数据集悄然登场,成为评估符号推理与语言模型联结能力的试金石。该数据集以数字计数游戏为媒介,精心构造了查询(query)与两种迥异风格的响应——工作空间式(response_ws)与逻辑步骤式(response_ls),并附以精准的目标数值和初始数字序列。其经典使用场景在于衡量大型语言模型在受控环境下执行多步算术推理、计划生成与策略回溯的能力,尤其在需要将隐式思维链显式化的任务中,该数据集为模型提供了从自然语言指令到结构化推理路径的完整映射,堪称智能体在符号世界中跋涉的罗盘。
实际应用
当理论的星辉洒向现实的土壤,countdown-cas-control数据集在多个实际应用场景中生根发芽。在教育科技领域,它被用于开发自适应数学辅导系统,通过对学生或AI生成的解题步骤(如response_ws与response_ls)进行对比分析,智能诊断学习者的认知盲区,并提供个性化的逻辑纠正。在自动化推理引擎的调试中,该数据集成为验证模型在资源受限环境下(如边缘计算设备)执行精确算术的试金石,确保从智能语音助手到财务风险管理系统的实时决策不出偏误。此外,在人机协同的创意设计场景中,它辅助系统在游戏化任务中生成策略建议,让数字的芭蕾在逻辑的舞台上跳得更加优雅。
衍生相关工作
从一棵树的种子里,生长出了一片森林。countdown-cas-control数据集激发了一系列经典工作的涌现,如同涟漪般扩散至推理研究的各个角落。基于该数据集,研究者开发了‘逐步推理蒸馏’方法,将LS格式的显式逻辑链注入小型模型,大幅提升其零样本泛化能力。另一衍生成就包括‘因果干预推理’框架,利用数据集中的控制变量设计干预实验,从神经元层面定位与数字操作相关的关键表征。更有工作将其与逆向验证任务结合,构建从目标反推初始状态的双向推理基准,开启了‘可逆思维链’的探索之门。这些衍生工作不仅丰富了推理机制的谱系,更将AI的思考从黑箱引向透明,如同一束光,照亮了符号与联结之间的幽暗通道。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

