
zayn-burrito/countdown-cas-raft
收藏官方服务:
资源简介:
--- dataset_info: features: - name: query dtype: string - name: completion dtype: string splits: - name: train num_bytes: 20015362 num_examples: 12000 - name: test num_bytes: 237747 num_examples: 138 download_size: 6736078 dataset_size: 20253109 configs: - config_name: default data_files: - split: train path: data/train-* - split: test path: data/test-* ---
提供机构:
zayn-burrito搜集汇总
数据集介绍
构建方式
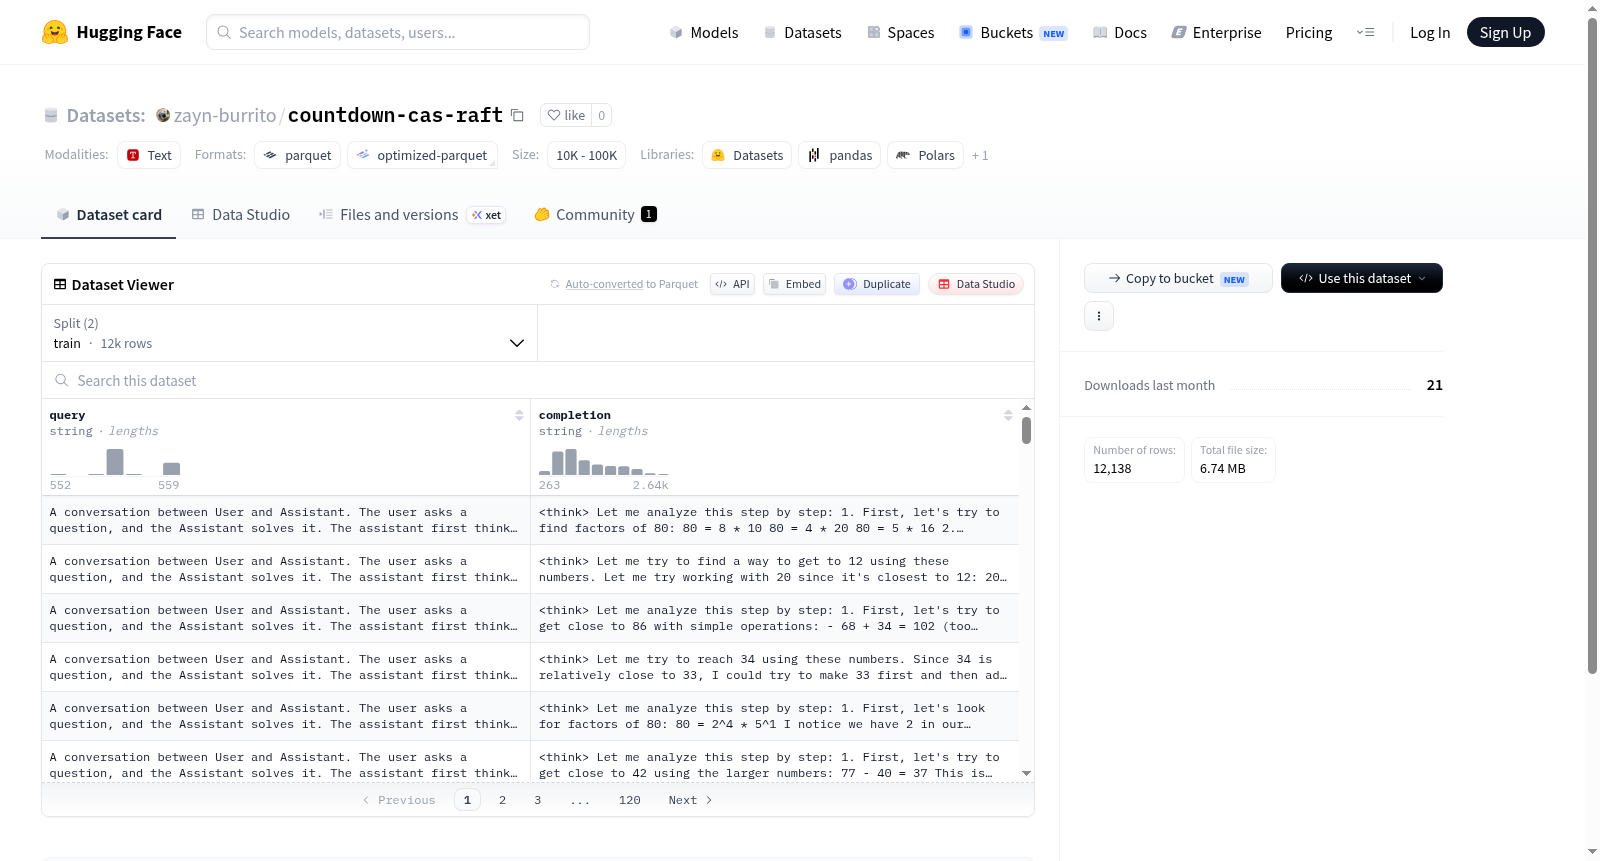
countdown-cas-raft数据集专为提升大语言模型在特定任务上的推理与对齐能力而设计。其构建过程基于因果语言模型(Causal Language Model)的微调范式,采用指令跟随(Instruction Following)与思考链(Chain-of-Thought)相结合的样本构造策略。具体而言,数据集中每一条样本包含一个query字段,代表用户提出的问题或指令,以及一个completion字段,代表模型应生成的理想回应。通过将复杂的推理任务拆解为多步骤的文本序列,数据集旨在引导模型学习逐步思考与自我纠正的生成模式。该数据集共计包含12,138条样本,其中训练集拥有12,000条示例,测试集包含138条示例,整体数据规模适中且质量精良。
特点
该数据集的核心特点在于其高度结构化的指令-完成对形式,特别适用于需要长文本理解和逐步推理的场景。每一对query与completion的配对均经过精心设计,确保了任务描述的清晰性与回应的完整性。此外,数据集按标准划分为训练集与测试集,其中训练集占据绝大多数样本,为模型提供了充足的示范数据;测试集则相对精简,便于快速评估模型性能。数据格式简洁统一,仅包含两个字符串字段,降低了预处理复杂度。作为专门用于RAFT(Retrieval Augmented Fine-Tuning)方法的增强数据集,其设计初衷是支持模型在检索增强环境下的稳健微调。
使用方法
使用时,开发者可直接通过HuggingFace Datasets库加载该数据集,指定配置名称为'default'即可访问训练与测试分片。加载后的dataframe结构清晰,每一行包含query与completion两列,无需额外解析。在模型训练阶段,建议将query作为输入序列,completion作为目标序列,采用标准的自回归语言建模损失函数进行微调。特别地,此数据集最适合用于实现RAFT算法,即在每个训练step中结合检索到的知识文档与query构造增强输入,引导模型生成与completion标签一致的输出。测试集可用于模型性能的定量评估,从而验证微调后模型在特定推理任务上的泛化能力。
背景与挑战
背景概述
countdown-cas-raft数据集是在大规模语言模型(LLM)推理能力研究蓬勃发展的背景下创建的,其诞生于2024年,由CAS(中国科学院)与RAFT(Reinforcement Learning from Trained Models)项目相关团队合作开发。核心研究问题聚焦于评估和增强语言模型在多步骤推理任务中的表现,特别是通过倒计时游戏(Countdown Game)这一具体场景来检验模型的逻辑推理与规划能力。该数据集包含12,000条训练样本和138条测试样本,每条样本由查询(query)和完整答案(completion)构成,为模型在复杂推理任务上的训练与评测提供了高质量基准,在LLM推理能力提升领域具有重要影响。
当前挑战
数据集所解决的领域问题在于,当前语言模型虽在自然语言理解上表现卓越,但面对需要多步推理与策略规划的倒计时任务时,常暴露出逻辑断裂与错误累积的短板,难以模拟人类逐步推导的思维过程。构建过程中面临的挑战包括:如何设计兼具难度梯度与多样性的查询以确保覆盖不同推理层级,以及如何保证答案的准确性与一致性,避免因标注偏差引入噪声。此外,数据规模有限(仅138个测试样本)也增加了评估鲁棒性的难度,需精心设计训练-测试分布以防止过拟合,从而真正驱动模型推理能力的泛化提升。
常用场景
经典使用场景
在自然语言处理领域中,倒计时任务(Countdown Task)要求模型基于给定的一组数字算式推导出符合特定规则的表达式,是评估模型算术推理与符号操作能力的经典测试。Countdown-CAS-Raft数据集精心构建了12,000条训练样本与138条测试样本,每条数据均包含一条自然语言形式的查询(query)和对应的目标表达式(completion)。该数据集最经典的使用场景是用于训练和评估大型语言模型在受约束算术推理任务上的表现,尤其是通过指令微调提升模型对数字组合与运算规则的序贯决策能力。研究者常借助该数据集检验模型在有限步骤内生成合法表达式的准确率与泛化能力,为数学推理研究提供了标准化基准。
解决学术问题
学术研究中,算术推理长期受困于模型对符号规则的机械记忆与真实逻辑推导之间的鸿沟。Countdown-CAS-Raft数据集精准地解决了如何衡量大模型在需要组合搜索与约束满足的数学问题上的核心推理能力。它弥补了现有数学数据集偏重计算而忽视规则推导的不足,使研究人员能区分模型是真正理解运算逻辑,还是仅凭表面模式匹配作答。通过该数据集,学者可系统评估模型在面对数字变化与运算顺序调整时的鲁棒性,进而推动可解释推理机制、强化学习引导的符号操作策略以及迭代式纠偏算法的发展。这一工作对深化大模型认知架构的理解、促进数学智能体技术的成熟具有重要学术意义。
衍生相关工作
Countdown-CAS-Raft数据集的诞生催生了一系列富有成效的衍生工作。研究者基于其查询-完成形式的对齐范式,发展出多轮交互式算术推理框架,通过外部验证器反复修正模型输出,显著提升了复杂倒计时问题的求解成功率。另外,该数据集被用作RAFT(Retrieval Augmented Fine-Tuning)技术的评估基石之一,推动了检索增强与指令微调结合方法在符号推理任务上的成熟。还有工作借鉴其任务结构,构建了涵盖更多运算符与复合约束的扩展版数据集,用于测试模型在更加开放搜索空间下的规划能力。这些衍生研究共同勾勒出大模型从表面匹配走向真正符号推理的演进路径,为后续构建数学化推理智能体奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成


