
遇见数据集

David-beakr/long-term-memory-seed

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

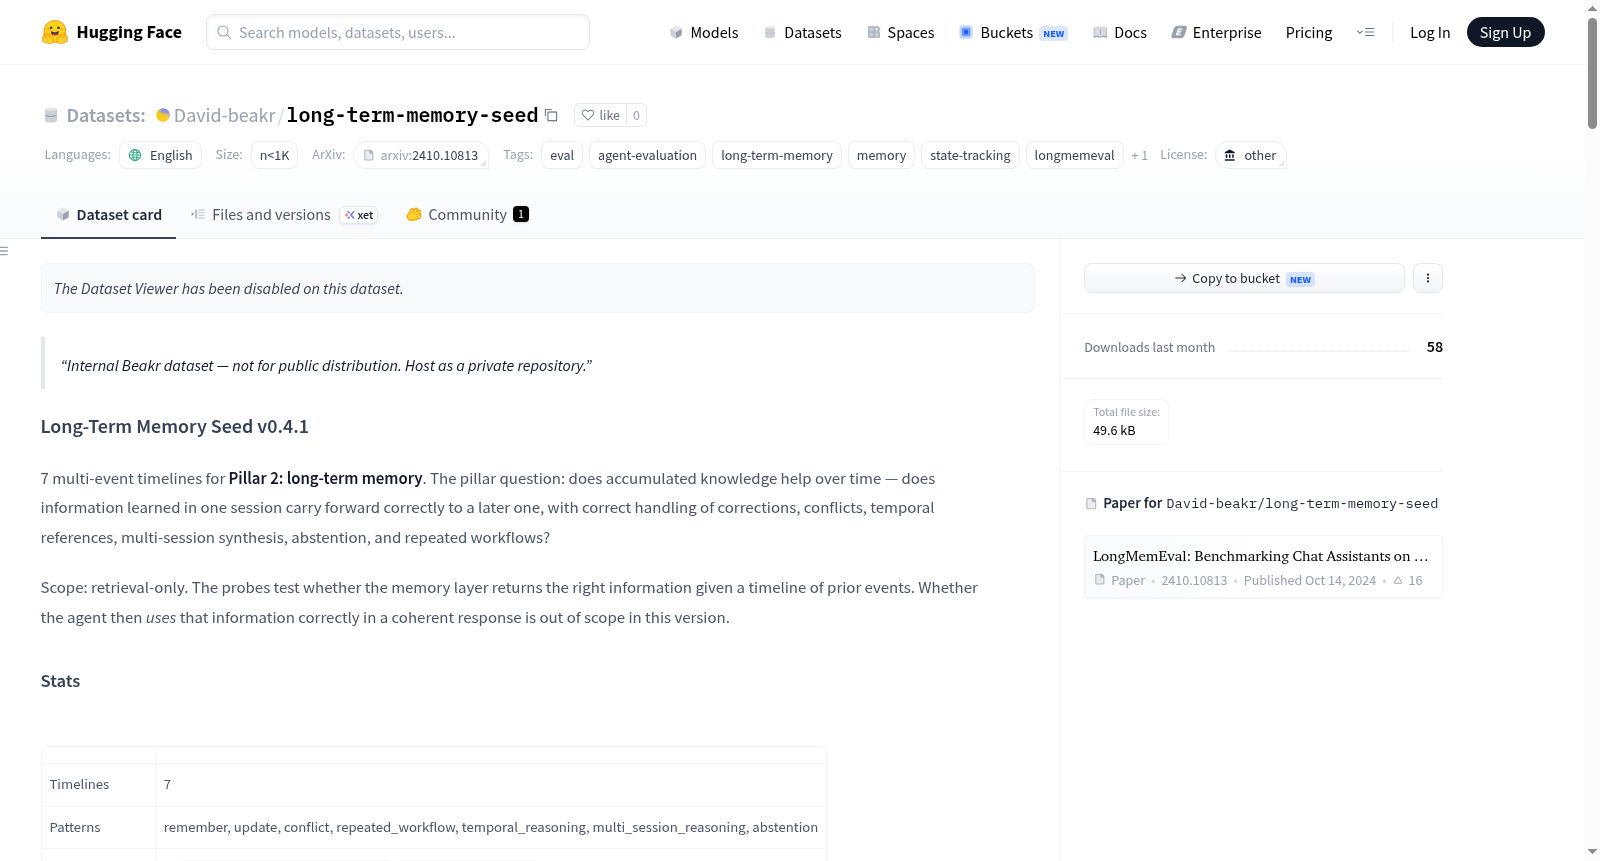
这是一个用于评估AI助手(特别是Beakr系统)长期记忆能力的内部数据集,版本为v0.2。数据集包含7个时间线,每个时间线由一系列事件和一个探针问题组成,旨在测试长期记忆的五个核心能力:信息提取(IE)、多会话推理(MR)、知识更新(KU)、时间推理(TR)和弃权(ABS)。数据集基于LongMemEval(ICLR 2025)基准进行设计,但规模较小,适用于内部迭代和评估。它采用混合评分方法,结合确定性检查(如子字符串匹配)和LLM法官评分,以确保准确性和效率。数据集主要用于测试记忆层在实时学习事件序列时的表现,包括处理更正、冲突、时间引用、多会话合成和重复工作流等场景。数据集不包含固定文档检索测试,而是自包含的事件序列。

This is an internal dataset for evaluating the long-term memory capabilities of AI assistants (specifically the Beakr system), version v0.2. The dataset contains 7 timelines, each consisting of a sequence of events and a probe question, designed to test five core memory abilities: Information Extraction (IE), Multi-Session Reasoning (MR), Knowledge Updates (KU), Temporal Reasoning (TR), and Abstention (ABS). It is grounded in the LongMemEval (ICLR 2025) benchmark but is smaller in scale (7 timelines), suitable for internal iteration and evaluation. The dataset uses a hybrid scoring approach, combining deterministic checks (e.g., substring matching) with LLM judge scoring to ensure accuracy and efficiency. It focuses on testing how the memory layer learns from event sequences in real-time, including scenarios like corrections, conflicts, temporal references, multi-session synthesis, and repeated workflows. The dataset does not test retrieval over fixed documents; each timeline is self-contained.
提供机构:
David-beakr
搜集汇总
数据集介绍
David-beakr/long-term-memory-seed 数据集图片
构建方式
该数据集以LongMemEval框架为理论基石,聚焦于长期记忆能力的量化评估。构建过程中,研究者精心设计了7条独立的时间线,每条时间线包含多个按时间顺序排列的事件以及一个探针问题。这些事件模拟了记忆层在真实场景中随时间逐步学习的信息流,而探针则用于测试记忆层在特定时间点能否正确检索相关信息。数据集的构建遵循结构化人工审查流程,确保每个时间线的设计能精准覆盖特定的记忆能力模式,如信息提取、知识更新、冲突解决等。相较于大规模基准,此种子数据集更注重对关键记忆维度的深度剖析与信号有效性验证。
特点
此数据集的核心特色在于其精巧的探针设计与双轨评分机制。每个探针问题的构建都基于对特定记忆失败模式的深入洞察,例如时间线TL-05专门考察时间戳感知能力,要求系统在多个时间点的事件中准确筛选出截止到询问日期的状态。评分体系采用确定性检查与大语言模型评判相结合的方式,对于封闭式答案(如日期、具体数值)使用子串匹配进行严格判定,而对于开放式或语义性答案则借助大模型依据细粒度评分准则进行灵活评估,有效兼顾了评估的精确性与语义覆盖面。
使用方法
使用该数据集时,评估者需首先通过HuggingFace Hub下载gold.json文件。对于每条时间线,需按顺序将input中的events逐一输入至待评估的记忆层或智能体系统中,模拟信息在会话间的积累与演进。随后向系统提出input.probe中的探针问题,并收集其响应。最终,根据reference.checks中定义的检查项对响应进行评分,其中requirement为hard的检查项是判定通过与否的必要条件,而bonus项则用于衡量系统的额外能力。此外,时间线之间的记忆状态必须重置,以确保每条时间线测试场景的独立性。
背景与挑战
背景概述
Long-Term Memory Seed v0.4.1是由Beakr团队于2025年构建的内部数据集,旨在评估智能体长期记忆能力中的核心支柱——第二支柱(长期记忆)。该数据集基于LongMemEval(Wu et al., ICLR 2025)的理论框架,聚焦于记忆层能否跨会话正确累积、更新及合成信息,从而检验智能体在复杂时间线中的知识保持与推理能力。数据集包含7条多事件时间线,覆盖记忆、更新、冲突、重复工作流、时间推理、多会话推理及弃权等关键模式,为长期记忆评估提供了精细化的测试基准。尽管规模较小,但其设计严谨,对智能体记忆系统的鲁棒性研究具有重要参考价值,推动了对话式AI在会话一致性方面的评估方法发展。
当前挑战
该数据集主要面临两大挑战。领域问题方面,智能体长期记忆需解决信息随时间推移的保持与更新难题,特别是处理修正、冲突、时间引用及多会话合成时的状态跟踪,例如TL-02检验用户明确修正后系统能否正确覆盖陈旧知识,TL-05则要求按时间戳过滤而非依赖近因偏差。构建过程中,团队需在有限的时间线内设计出具有诊断精度的病例,同时平衡封闭式检查与LLM评判混合评分策略的可靠性;TL-07的弃权测试尤为棘手,需避免因词法匹配而误判正确响应,从而确保评估既经济又准确。
常用场景
经典使用场景
在长程记忆评估领域,该数据集作为智能体长期记忆能力的标准化测试基准,广泛应用于对话系统和自主代理的记忆模块性能评测。其核心设计围绕七条精心编排的事件时间线,每条时间线模拟了智能体在连续会话中积累知识、处理更新、应对冲突、进行时序推理等多维度记忆任务。研究者可通过回放事件序列并探针提问的方式,系统性地检验记忆层是否准确存储、更新和检索跨会话信息,从而为长程记忆机制的有效性提供量化评估依据。
解决学术问题
该数据集直面当前大语言模型在长程记忆维持方面的核心挑战,解决了传统评估方法无法捕捉知识随时间演变、跨会话综合推理以及主动拒答等复杂记忆行为的痛点。通过构建包含信息提取、知识更新、时序推理、多会话综合和主动拒答等七种认知模式的时间线,它填补了评估体系中对工作流级记忆和知识冲突处理能力缺失的空白。其严谨的混合评分策略——结合确定性校验与基于规则的大模型裁判——提升了评估的鲁棒性与成本效率,为长程记忆理论研究提供了可靠的数据支撑与方法论启示。
衍生相关工作
该数据集深深植根于LongMemEval(Wu et al., ICLR 2025)所确立的五大核心记忆能力体系,并创新性地扩展了重复工作流记忆维度,弥补了现有基准对代理专用记忆场景覆盖的不足。其混合评分策略借鉴了SQuAD精确匹配与F1评分、Bulian等人(2022)的答案等价性框架、Kamalloo等人(2023)的否定感知评估以及Liu等人(2023)的G-Eval准则化分级方法。此外,该数据集设计的开放域评分策略启发自Zheng等人(2023)关于位置、冗长与自我增强偏见的研究,为后续开发更智能的记忆评估工具链奠定了方法论基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

