
Shaer-AI/shaer-eval-raw-gpt2-small-arabic-poetry
收藏官方服务:
资源简介:
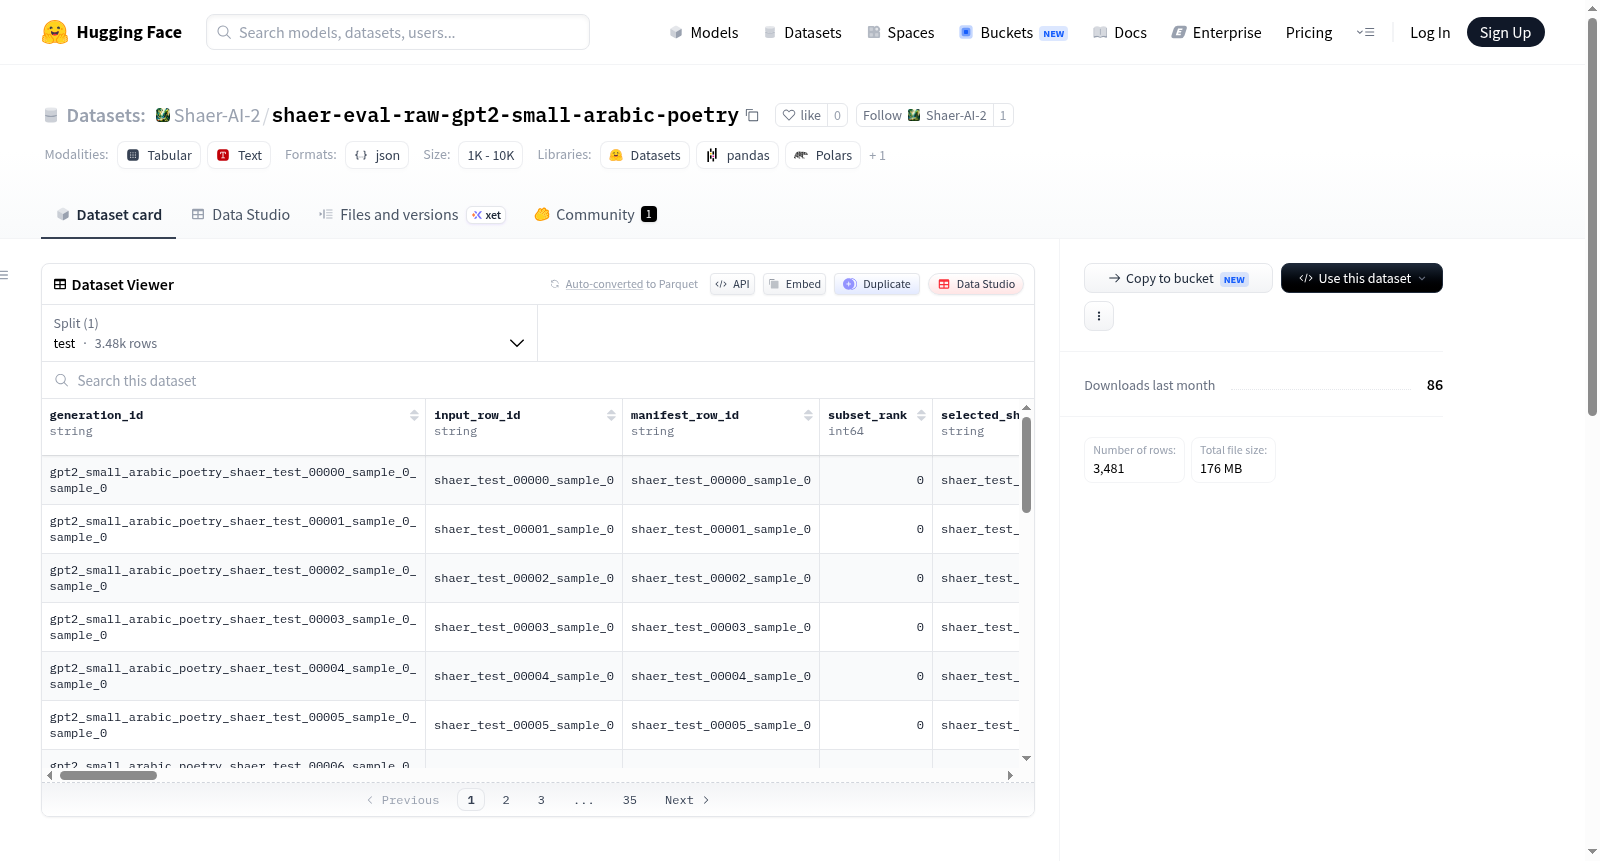
该数据集包含经过评分预处理的GPT-2 small阿拉伯诗歌续写生成内容。主要文件为data/test.jsonl,包括源/提示/参考字段、原始生成文本、处理后的以换行符分隔的生成文本、预处理元数据以及韵律/计数奖励列。预处理方法为split_dash_separated_hemistichs_truncate_to_requested_lines,总行数为3481。验证、聚合指标和原始处理的JSONL等文件存储在artifacts/目录下。
This dataset contains GPT-2 small Arabic poetry continuation generations after scoring preprocessing. The main table is data/test.jsonl; it includes source/prompt/reference fields, raw_generated_text, processed newline-separated generated_text, preprocessing metadata, and meter/count reward columns. Preprocessing method: split_dash_separated_hemistichs_truncate_to_requested_lines. Rows: 3481. Artifacts such as validation, aggregate metrics, and raw processed JSONL are stored under artifacts/.
提供机构:
Shaer-AI搜集汇总
数据集介绍
构建方式
该数据集名为Shaer GPT-2 Small Processed Scored Continuation Generations,其构建基于阿拉伯诗歌的生成任务。研究人员首先从Shaer-AI/shaer-sft-test-generations-k5源数据集中提取了3481条测试样本,利用预训练的gpt2_small_arabic_poetry模型进行续写生成,得到原始的generations.jsonl文件。随后对这些生成结果进行系统评估,通过meter/count评价指标对每一行的韵律和字数进行评分,生成包含评估得分的generations_scored.jsonl文件。此外,还提供了validation.json作为验证摘要,以及aggregate.json汇总了整体指标,如平均韵律得分0.068402、平均字数符合率0.833212和精确字数匹配率0.823039,确保了数据集的全面性和专业性。
使用方法
该数据集主要面向阿拉伯诗歌生成模型的评估与改进研究。用户可以直接加载test.jsonl文件(位于data目录下),利用Python的jsonlines库或Pandas读取每一条生成文本及其相关元数据。若需进行细致的韵律和字数分析,可优先使用generations_scored.jsonl或generations_scored.csv,其中包含了每一条生成结果的meter和count评分字段。对于快速对比实验,aggregate.json提供了整体静态统计指标,适合作为性能基线。此外,validation.json涵盖了验证流程的详细摘要,帮助用户理解数据筛选和评分逻辑。建议结合源数据集Shaer-AI/shaer-sft-test-generations-k5进行更深入的消融分析,以全面评估模型在不同设置下的生成质量。
背景与挑战
背景概述
阿拉伯诗歌作为阿拉伯文学的核心载体,其创作与评估长期依赖人工判断,缺乏自动化的质量评估标准。Shaer评估数据集由Shaer-AI团队于2024年左右创建,旨在为阿拉伯诗歌生成模型提供系统化的评估基准。该数据集基于GPT-2 Small Arabic Poetry模型生成的3481条诗歌续写样本,通过韵律匹配度(Meter mean)和音节数一致性(Count adherence mean)等指标,量化评估模型在古典诗歌形式规范上的表现。其发布填补了阿拉伯诗歌自然语言生成评估领域的空白,为后续研究者提供了可复现的标准化评测流程,推动了低资源语言诗歌生成技术从定性分析向定量评估的转型。
当前挑战
该数据集面临的核心挑战包括:1) 阿拉伯诗歌严格的格律规则(如长音与短音交替的韵律模式)对模型生成的准确性构成极大考验,数据集显示韵律准确度均值仅0.068,表明模型在捕捉微妙韵律特征上存在显著不足;2) 音节数控制(Count adherence mean为0.833)虽相对较高,但精确匹配率(Exact count rate)为0.823,说明模型在严格遵循古典诗歌音节数约束时仍存在偏差,需改进生成过程中的长度控制机制;3) 数据集构建中需处理阿拉伯语形态复杂性与诗歌文本稀缺性的双重挑战,有限的训练数据可能无法覆盖多样化的诗歌风格与主题,导致评估结果的泛化性受限。
常用场景
经典使用场景
在阿拉伯诗歌与自然语言处理的交叉研究中,Shaer GPT-2 Small Processed Scored Continuation Generations数据集扮演着至关重要的角色。其最经典的使用场景在于评估和基准测试面向阿拉伯诗歌的预训练语言模型——特别是GPT-2小型模型——在诗歌续写任务上的生成质量。研究者利用该数据集中的评价指标,如格律均值、计数依从性均值和精确计数率,来衡量模型在保持阿拉伯诗歌韵律和音节规则方面的能力。这一应用为评估生成诗歌是否符合传统诗学规范提供了量化标准。
解决学术问题
该数据集有效解决了阿拉伯诗歌自动生成领域中缺乏标准化评估框架的学术困境。通过提供包含格律与计数评价的生成结果,它使研究者能够系统性地分析模型在处理复杂诗歌结构时的表现。这有助于探索如何将古典诗歌的形式约束——如巴赫尔(Bahr)格律和固定音节计数——融入现代神经语言模型。其意义在于推动了计算诗学的发展,为后续研究提供了可靠的对比基准,促进了对阿拉伯语在艺术创作中语言模型能力边界理解的深化。
实际应用
在实际应用中,该数据集可服务于多类场景。对于阿拉伯语教学,它可用于开发辅助学生掌握传统格律创作规则的智能工具。在数字人文领域,它能为大型阿拉伯语诗歌语料库的自动标注和风格分析提供支持。此外,文化机构和出版方能够利用基于该数据集评估的模型,辅助创作符合古典韵律的诗歌内容,用于文学赏析或互动展示。其评分机制还为诗歌生成系统的迭代优化提供了可直接引用的性能指标。
数据集最近研究
最新研究方向
在当前阿拉伯语诗歌生成的研究前沿,Shaer评估数据集为细粒度评估生成诗歌的韵律与音节合规性提供了关键基准。该数据集基于GPT-2小模型对阿拉伯诗歌的续写生成结果,引入韵律忠实度(Meter mean)与音节计数遵循度(Count adherence mean)两项核心指标,精确量化模型在古典诗歌形式约束下的表现。其中0.068的韵律均值与0.823的音节精确匹配率,揭示了生成诗歌在形式一致性上仍有显著提升空间,推动了可控文本生成与韵律约束建模的交叉探索。这一工作与近期阿拉伯语自然语言处理的热点——低资源语言的诗意生成与文化遗产数字化保护紧密关联,为后续融合韵律模板的生成策略及多尺度评估体系的构建奠定了基础。
以上内容由遇见数据集搜集并总结生成


