
enem-2023-d2-multimodal
收藏官方服务:
资源简介:
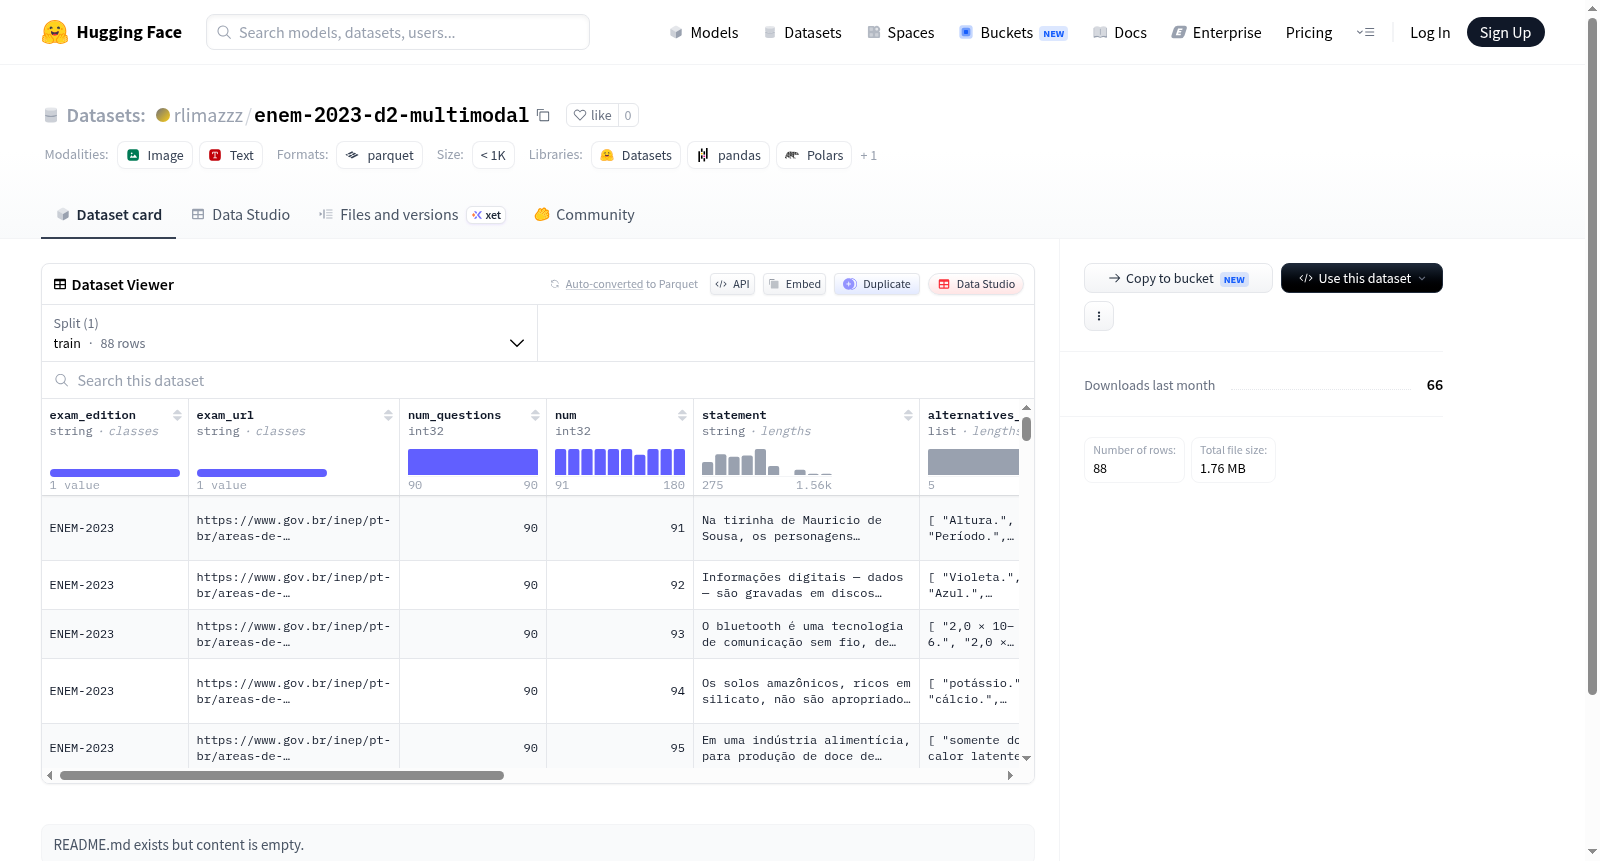
该数据集是一个小规模的多选题考试数据集,包含88个训练样本。每个样本涵盖考试版本、题目陈述、选项文本与标签、正确答案、题目来源URL、科目分类、题目图片以及选项图片等信息。适用于多选题问答、阅读理解、教育评估等任务。
This dataset is a small-scale multiple-choice exam dataset containing 88 training samples. Each sample includes exam version, question statement, option text and labels, correct answer, question source URL, subject category, question image, and option image. It is suitable for tasks such as multiple-choice question answering, reading comprehension, and educational assessment.
创建时间:
2026-08-17
原始信息汇总
ENEM-2023-D2-Multimodal 数据集概述
基本信息
- 数据集名称:ENEM-2023-D2-Multimodal
- 来源地址:https://huggingface.co/datasets/rlimazzz/enem-2023-d2-multimodal
数据规模
- 总数据量:88 条样本
- 数据分割:仅包含训练集(train)
- 数据集大小:约 1.93 MB
- 下载大小:约 1.90 MB
数据特征(字段结构)
该数据集共包含 12 个特征字段,涵盖文本与图像两种数据类型:
文本类字段
exam_edition:考试版本(字符串)exam_url:考试链接(字符串)num_questions:试题数量(整数)num:题号(整数)statement:题目陈述内容(字符串)alternatives_text:选项文本(字符串列表)alternatives_label:选项标签(字符串列表)answer:正确答案(字符串)url:题目链接(字符串)subject:学科类别(字符串)
图像类字段
statement_image:题目配图(图像)alternatives_images:选项配图(图像列表)
数据集配置
- 配置名称:default
- 数据文件路径:
data/train-*
数据集用途
该数据集源自巴西国家高中考试(ENEM)2023年第二天考试的多模态题目,适用于教育领域中的多模态问答、视觉推理、题目解析等研究任务,尤其适合需要结合文本与图像信息进行理解与推理的场景。
搜集汇总
数据集介绍
构建方式
本数据集源自2023年巴西国家中等教育考试(ENEM)第二天考试,收录了88道多模态试题。每道题目均包含题干、选项文本及标签、正确答案、所属学科及考试版本等结构化信息,并辅以题干图片和选项图片作为视觉模态数据。数据以表格形式存储,确保了文本与图像之间的关联性,为多模态学习研究提供了完整的原始资料。
使用方法
使用本数据集时,研究者可借助HuggingFace的datasets库直接加载,并利用其内置的图像处理功能实现多模态输入。典型应用包括构建试题自动问答系统、训练视觉问答模型或进行教育领域的迁移学习。由于数据已按train split划分,可直接用于模型训练与测试,亦可根据学科字段进行子集筛选,以应对针对性的研究需求。
背景与挑战
背景概述
enem-2023-d2-multimodal数据集源自巴西国家高中教育考试(ENEM)2023年第二天考试,由相关教育研究机构整理发布。该数据集聚焦于多模态学习,融合文本陈述、图像及备选答案图片,旨在推动中文(或葡萄牙语)教育场景下的视觉问答与多模态推理研究。其核心问题在于评估模型对复杂现实考题的理解与作答能力,涵盖了数学、自然科学等领域。发布后为多模态大模型在低资源语言教育评估中的表现提供了基准,促进了跨学科内容理解与可解释性分析的发展。
当前挑战
该数据集面临多重挑战。领域层面,ENEM题目涉及数学公式、图表、图像语义及跨学科推理,模型需整合文本与视觉信息进行精准作答,对多模态对齐和常识推理要求极高,同时需处理葡萄牙语的复杂句法与专业术语。构建过程中,数据需从原始考试资料中精准提取和结构化,包括分割文本、图片与选项,并确保图像质量与文本一致性。此外,样本规模仅88道题,可能引入统计偏差,影响模型泛化,且需人工校验标注的准确性,成本较高。
常用场景
经典使用场景
该数据集源自巴西国家高中教育考试(ENEM)2023年第二天的试题,聚焦于多模态信息融合的智能问答场景。在自然语言处理与计算机视觉的交汇领域,它承载了88道包含文本、图像及混合选项的复杂题目,为研究者提供了一个真实且高难度的benchmark,用以评测模型对跨模态语义的捕捉、推理与应答能力。常见的使用方式包括直接训练端到端的视觉问答(VQA)系统,或作为预训练模型的微调数据,检验其在教育测评场景下的泛化性能。
解决学术问题
该数据集有效缓解了现有学术基准中多模态问答样本稀缺且脱离真实教育背景的困境。它直面了如何在同一框架内统一处理文本叙述、图表信息和图像语境的复杂挑战,为探索跨注意力机制、多模态编码器融合策略以及答案推理的可解释性提供了标准化测试平台。通过该数据集,研究人员能够系统评估模型在解析混合选项、处理图像与文本矛盾信息时的鲁棒性,推动从单模态感知向多模态协同认知的转变,深化对视觉-语言联合表征的理解。
实际应用
在实际教育领域,该数据集可助力开发智能辅导系统、自动答题评估平台及个性化学习工具。其能够训练AI系统辅助学生解答涉及示意图、地图或化学实验图的高中课程难题,为在线教育提供即时反馈和解析。此外,它还能应用于考试命题质量分析,通过模型试做来预测题目的难度和区分度,或用于构建面向多学科(如物理、地理、生物)的语音助手,在互动教学中解释图文结合的复杂概念,提升教育资源的可及性与有效性。
数据集最近研究
最新研究方向
该数据集聚焦于巴西国家高中教育考试(ENEM)2023年第二天的多模态试题,涵盖文本与图像交织的复杂问题,为人工智能领域中的视觉问答与多模态推理研究提供了极具挑战性的基准。当前前沿方向集中于构建能够协同处理非结构化文本与图像信息的统一模型,例如融合视觉-语言预训练技术,以应对实际教育场景中语义理解与跨模态关联的难题。该数据集的发布不仅推动了智能教育评估系统的迭代,也为探讨多模态大模型在低资源语言环境下的泛化能力提供了重要实验场,其影响延伸至个性化学习、自动答题及教育公平性等热点议题。
以上内容由遇见数据集搜集并总结生成


