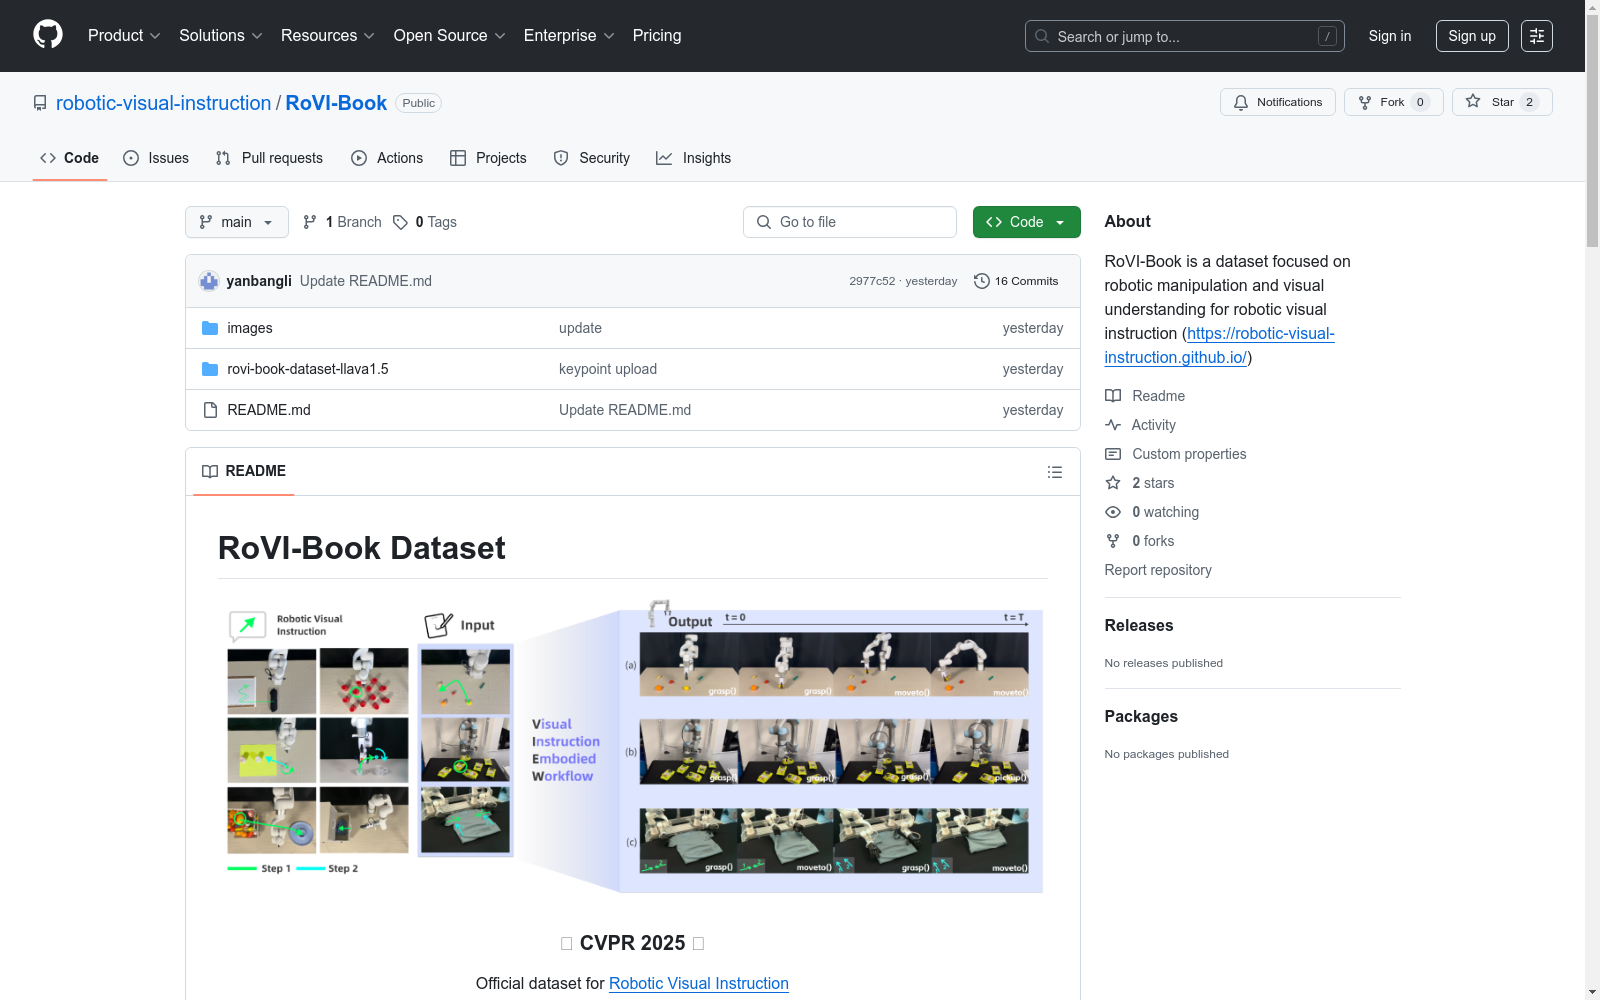
RoVI-Book Dataset
收藏资源简介:
RoVI-Book是一个专注于机器人操作和视觉理解的数据集,用于机器人视觉指令。该数据集包含大量记录机器人操作的序列图像,涵盖单步和多步操作场景。
RoVI-Book is a dataset focused on robot manipulation and visual understanding, developed for robot vision instruction tasks. This dataset contains a large number of sequential images recording robot manipulation operations, covering single-step and multi-step manipulation scenarios.
RoVI-Book数据集概述
基本信息
- 数据集名称:RoVI-Book Dataset
- 相关会议:CVPR 2025
- 官方用途:Robotic Visual Instruction项目的官方数据集
数据集简介
- 专注于机器人操作和视觉理解
- 包含大量连续图像,记录机器人操作过程
- 涵盖单步和多步操作场景
数据集结构
dataset/ ├── dataset_llava.json # LLaVA格式的数据集文件 └── obs/ # 观测数据 ├── pics_multi_step/ # 多步操作图像 │ ├── circle/ # 带圆形标注的图像 │ └── no_circle/ # 无标注图像 ├── pics_one_step/ # 单步操作图像 │ ├── circle/ # 带圆形标注的图像 │ └── no_circle/ # 无标注图像 └── rotation/ # 旋转相关图像 ├── multi_step/ # 多步旋转操作 └── one_step/ # 单步旋转操作
图像类别
- 多步操作图像:记录完整操作序列
- 单步操作图像:捕捉单个动作
- 旋转操作图像:专注于物体翻转和旋转动作
标注信息
- circle/:包含带圆形标注的图像
- no_circle/:包含无标注图像
数据格式
- 采用LLaVA格式,存储在dataset_llava.json中
- 包含以下字段:
- id:唯一标识符
- image:图像路径
- conversations:对话内容(包含人类指令和预期响应)
关键点数据集
- 提供关键点标注
- 专为YOLOv8训练设计
- 用于提取箭头或圆形的关键点
数据集访问
- 关键点数据集位置:https://huggingface.co/datasets/yanbang/rovibook/tree/main
训练信息
- 设计用于训练视觉语言模型
- 实验中使用LLaVA-1.5进行微调
- 训练方法遵循LLaVA的视觉指令调优方法