
遇见数据集

MARIANNE-INRIA/PoliticalDebatesCorpus-EN

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

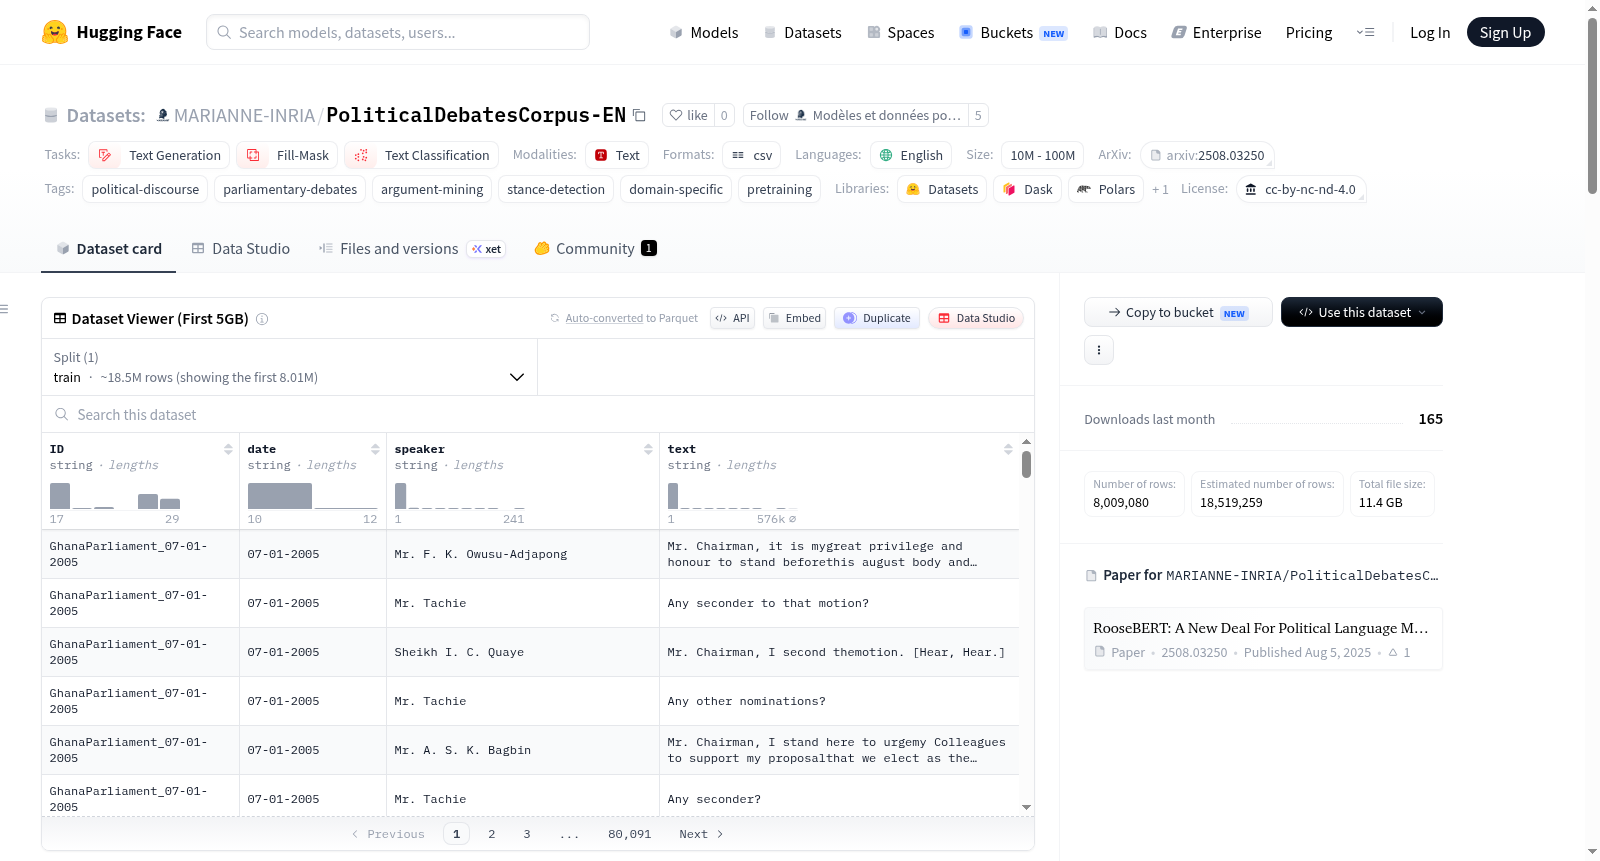
PoliticalDebatesCorpus-EN(也称为RooseDebates)是一个大规模英语政治辩论和演讲转录本语料库,专为领域特定语言模型预训练而构建。它是专为政治辩论的对话和论证性质定制的语言模型RooseBERT的训练语料库。该语料库汇集了来自多个国家和国际机构的电视总统辩论和议会辩论,总计约11 GB的文本,时间跨度为1946年至2025年。数据来源包括非洲议会辩论(加纳和南非)、澳大利亚议会辩论、加拿大议会辩论、欧洲议会辩论、爱尔兰议会辩论、新西兰议会辩论、苏格兰议会辩论、英国议会辩论、联合国大会辩论、联合国安理会辩论和美国辩论等权威政治设置。语料库经过预处理,移除了超链接和标记标签,并合并了多个空格。预期用途包括政治话语分析的语言模型预训练和微调,支持下游任务如立场检测、情感分析、论证挖掘和政策分类。但语料库仅限英语,地理和语言覆盖不均,且可能包含偏见或攻击性语言。

PoliticalDebatesCorpus-EN is a large-scale English corpus of political debate and speech transcripts, assembled for domain-specific language model pre-training. It is the training corpus behind RooseBERT, a language model tailored to the dialogic and argumentative nature of political debates. The corpus brings together televised presidential debates and parliamentary debates from multiple countries and international bodies, totalling ~11 GB of text and spanning the period 1946–2025. Data sources include African Parliamentary Debates (Ghana & South Africa), Australian Parliamentary Debates, Canadian Parliamentary Debates, European Parliamentary Debates, Irish Parliamentary Debates, New Zealand Parliamentary Debates, Scottish Parliamentary Debates, UK Parliamentary Debates, UN General Debate Corpus, UN Security Council Debates, and United States Debates, all from authoritative political settings. The corpus was pre-processed to remove hyperlinks and markup tags and to collapse multiple spaces. Intended uses include pre-training and fine-tuning of language models for political discourse analysis, supporting downstream tasks such as stance detection, sentiment analysis, argument mining, and policy classification. However, the corpus is English-only with uneven geographic and linguistic coverage, and may contain biased or offensive language.
提供机构:
MARIANNE-INRIA
搜集汇总
数据集介绍
MARIANNE-INRIA/PoliticalDebatesCorpus-EN 数据集图片
构建方式
PoliticalDebatesCorpus-EN是一个大规模英文政治辩论与演讲语料库,专为领域自适应语言模型预训练而构建。该数据集整合了多个现有精选语料库与从官方辩论网站爬取的转录文本,涵盖电视总统辩论、多国议会辩论及联合国辩论等多元化来源,如非洲议会辩论、澳大利亚、加拿大、爱尔兰、新西兰、苏格兰、英国议会辩论以及欧洲议会、联合国大会与安理会辩论,时间跨度从1946年至2025年。所有原始数据经过统一预处理流水线,包括移除超链接与标记标签、压缩多余空白字符,并将各来源的分割合并为平衡的代表性语料,最终形成约11GB的纯净英文文本。
特点
该数据集的核心特点在于其规模宏大、来源权威且时间跨度长,总计约11GB文本,覆盖近80年的政治话语。其多样性体现在融合了电视辩论与议会辩论两种主要辩论形式,并广泛收录多个英联邦国家、美国及国际机构的政治对话,凸显了跨文化、跨制度的语料优势。数据集专为政治话语分析设计,支持立场检测、情感分析、论点成分识别与关系分类、动议政策分类及命名实体识别等下游任务。尽管语料均衡整合了各来源,但需注意其仅包含英文,且地理与时间覆盖不均,可能蕴含特定时期的框架效应与演讲者的主观立场。
使用方法
该数据集主要用于领域自适应预训练或继续预训练基于编码器的语言模型,以增强其处理政治辩论与对话文本的能力。用户可基于该语料训练如RooseBERT等专注政治话语的模型,并针对立场检测、情感分析、论点挖掘及政策分类等任务进行微调。使用时需注意,数据集仅限英文,且来源于官方政治场合,可能含有偏见或攻击性语言;模型输出不应被视为事实性政治主张的权威依据。此外,本数据集整合了多个独立许可的底层语料库,用户须遵守各来源的原始许可条款,聚合版本以CC-BY-NC-ND-4.0发布,但不可覆盖各底层数据的许可约束。
背景与挑战
背景概述
政治辩论与议会演说是自然语言处理领域中极具挑战性的研究场域,其语言兼具高度结构化与即兴性,充满了复杂的论证逻辑、立场表达以及策略性修辞。PoliticalDebatesCorpus-EN数据集由Deborah Dore、Elena Cabrio与Serena Villata于2025年创建,整合了来自美国、英国、加拿大、澳大利亚、爱尔兰等十余个国家和国际机构的电视辩论与议会记录,总规模约11GB,时间跨度从1946年至2025年。该数据集的核心研究问题在于为政治话语分析构建专用的语言模型预训练语料,并在此基础上推动了立场检测、论证挖掘、情感分析及政策分类等下游任务的发展。作为RooseBERT模型的基础训练数据,该语料库填补了通用英语语料库在政治对话领域适应性不足的空白,对政治传播学与计算社会科学交叉领域的研究具有深远影响。
当前挑战
该数据集所解决的领域问题在于,通用语言模型在面对争论性、多声部的政治话语时,往往难以捕捉精妙的立场转换与论证结构,亟需领域适配的预训练数据以提升模型对论证逻辑和策略性语言的敏感度。在构建过程中,数据集面临多重挑战:首先,跨来源数据质量的统一性难以保证,需要设计一套标准化的预处理流程来剔除超链接与标记代码并合并多源分裂;其次,时间跨度近八十年,各源头的覆盖时段参差不齐,易引入特定历史时期的框架效应;最后,语料库的地理与语言分布严重不均,集中于英美与英联邦国家,导致全球政治视角的呈现存在系统性偏倚,且部分原始转录内容带有明显的倾向性或攻击性言辞,使得模型在训练时面临偏见放大的风险。
常用场景
经典使用场景
在政治话语分析与自然语言处理交叉领域,PoliticalDebatesCorpus-EN凭借其横跨1946至2025年、涵盖多国议会辩论与总统竞选辩论的庞大规模,成为领域自适应预训练的基石性语料。研究者通常利用该数据集对通用语言模型进行持续预训练,使其掌握政治辩论特有的修辞结构、论证策略与术语体系,进而为立场检测、情感分析等下游任务奠定坚实基础。
实际应用
在实际应用中,依托该数据集预训练的模型可服务于议会议事录的自动摘要与政策倾向分析,辅助立法机构提升信息处理效率。媒体与智库可借其监测公共人物的立场演变与辩论焦点迁移,公众亦可透过立场检测工具洞察政治话语中的支持与反对力度,从而增强政治传播的透明度和公民参与的科学性。
衍生相关工作
该数据集直接孕育了领域专用语言模型RooseBERT,该模型在论证挖掘与立场检测任务上显著超越通用基线。此外,数据集催生了一系列细粒度研究,包括针对议会辩论的动议政策分类框架、跨国会辩论的论元关系标注体系,以及融合时间维度的政治立场演化分析模型,这些工作共同构筑了从语料到理论与应用的完整学术生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

