
遇见数据集

CooperBench/team-coop

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

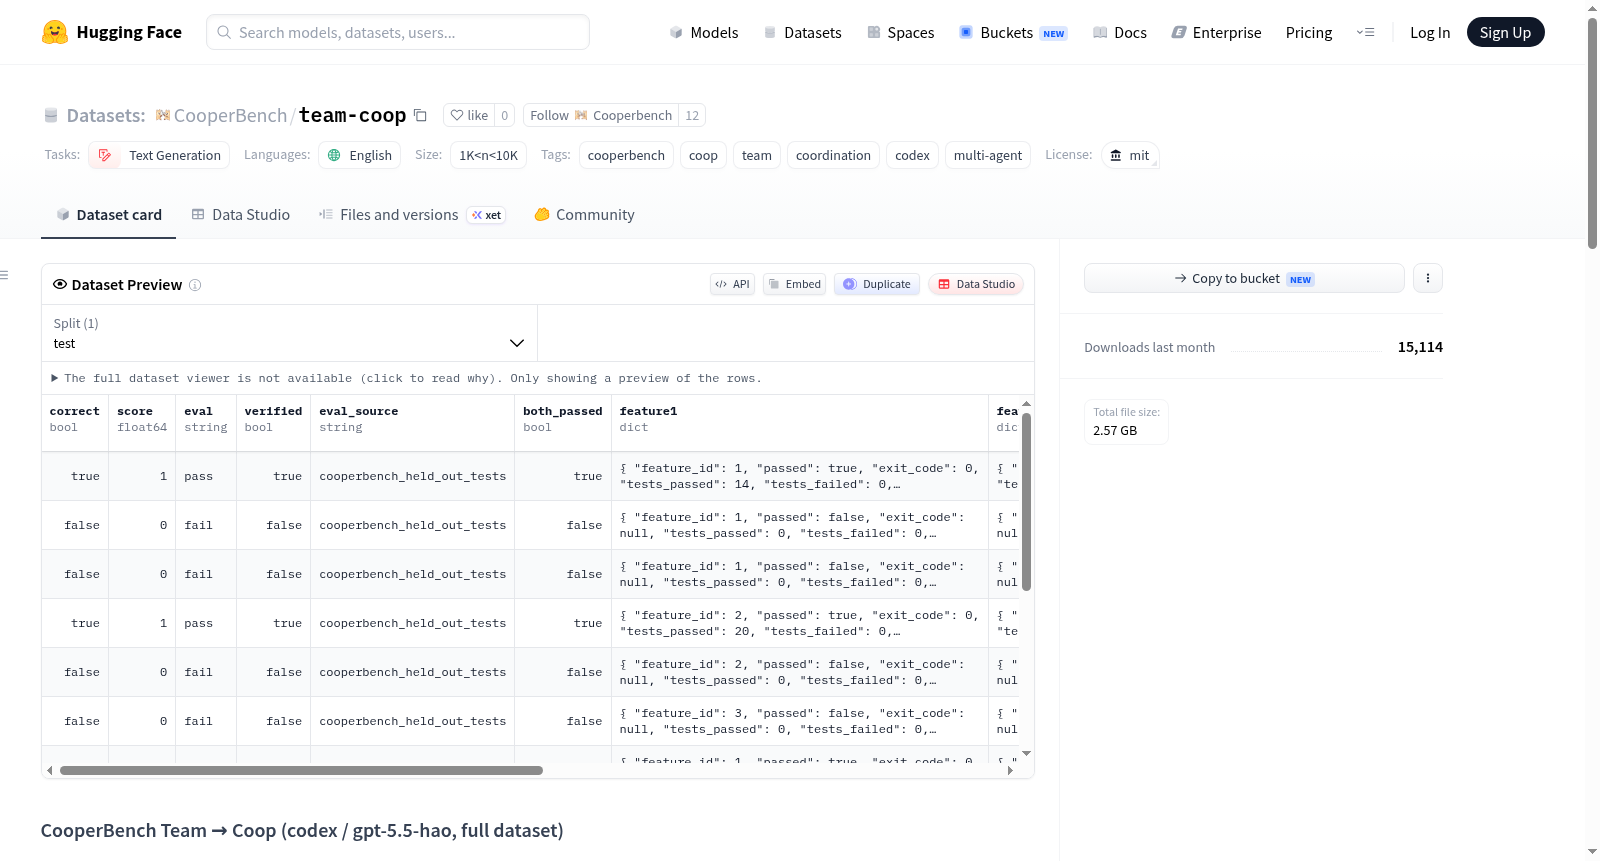
该数据集包含两个完整的CooperBench团队运行(lead和member共享Redis支持的任务列表、草稿卷和MCP),这些运行被重塑为2代理合作布局,定义在cooperbench/CooperData PR #98中。数据集源自CooperBench的team-trajectories数据集,使用codex代理框架(Azure提供者,非JSON线)和gpt-5.5-hao模型(Azure部署)。总共有1,304个轨迹,全部来自CooperBench的652对完整数据集(每个任务的12个仓库特征对的笛卡尔积),包括通过率信息:一个运行(无协议动词)的通过率为61.8%(403/652),另一个运行(完整团队功能集)的通过率为59.8%(390/652)。数据布局包括代理轨迹、对话、结果和评估文件,映射决策将lead映射为agent1,member映射为agent2,并包含团队特定的额外信息块。

Two complete cooperbench team-harness runs (lead + member sharing a Redis-backed task list, scratchpad volume, and MCP) reshaped into the 2-agent coop layout defined in cooperbench/CooperData PR #98. The dataset is derived from CooperBenchs team-trajectories dataset, using the codex agent framework (Azure provider, non-JSON wire) and model gpt-5.5-hao (Azure deployment). Total of 1,304 trajectories, all from the cooperbench 652-pair full dataset (the 12-repo cartesian product of feature pairs per task), with pass rates: one run (without protocol verbs) at 61.8% (403/652) and another run (full team feature set) at 59.8% (390/652). The layout includes agent trajectories, conversation, result, and evaluation files, with mapping decisions assigning lead to agent1 and member to agent2, and includes a team-specific provenance block.
提供机构:
CooperBench
搜集汇总
数据集介绍
CooperBench/team-coop 数据集图片
构建方式
该数据集源自CooperBench框架下的两次完整团队调度(team-harness)实验,基于12个仓库中每项任务的652对特征组合的笛卡尔积,共生成1,304条轨迹。原始数据由采用Azure部署的codex代理框架与gpt-5.5-hao模型协作产生,经由CooperData仓库PR #101定义的转换工具,将原始双智能体团队结构重塑为2智能体协作(coop)布局。转换过程保留了团队运行中的任务列表、暂存空间、MCP协议及自动刷新等设置,并区分了包含与不包含协议动词的两种配置,分别达到61.8%与59.8%的通过率。
特点
该数据集以非对称角色映射为核心特征:团队负责人(lead)映射为协作槽位agent1,承担整合责任;团队成员(member)映射为agent2。目录结构按运行、仓库、任务与源特征ID组织,避免特征对冲突。conversation.json从团队的task_log.json中重建,结合codex的发送日志条目,将通信目标重写为协作槽位ID。评估结果通过verified字段标识阳性结果,仅当correct为true时方标记为true,便于下游筛选高质量成功子集。团队专有属性如负责人、团队特征与度量指标被归入team溯源块。
使用方法
用户可通过huggingface-cli下载源轨迹压缩包至本地目录,并解压。随后运行CooperData仓库中的convert_team模块,指定解压后的团队运行路径和输出目录,即可完成数据转换。生成的目录结构以run/coop/repo/task_id/feature_pair/格式组织,每个特征对子目录下包含智能体轨迹JSON、补丁文件、对话记录、结果与评估元数据等文件,便于进行多智能体协作研究中的轨迹分析、策略评估与效果验证等下游任务。
背景与挑战
背景概述
CooperBench Team→Coop数据集于2026年5月由CooperBench研究团队创建,聚焦于多智能体协作场景下的代码生成任务。该数据集源自完整的team-harness运行记录,将领导者和成员通过Redis支持的任务列表、暂存卷及MCP协议进行交互的轨迹,重塑为双智能体协作布局。其核心研究问题在于探究不同协作协议(如协议动词的有无)对多智能体系统代码生成成功率的影响。数据集包含1304条轨迹,覆盖12个代码仓库中652对特征组合,并采用codex框架与gpt-5.5-hao模型生成,为多智能体协作研究提供了标准化基准,推动了该领域从单智能体向复杂协作范式的迁移。
当前挑战
该数据集主要挑战体现在两个方面:首先,在领域问题层面,多智能体协作代码生成面临任务分解与通信效率的平衡难题,领导者与成员之间的不对称角色分配(如领导者承担整合责任)增加了协调复杂度,不同协议设置下60%左右的通过率表明现有协作机制仍存在显著优化空间。其次,在构建过程中,数据采集需要精确追踪agent间的事件日志(如创建、认领、更新事件),并将团队特定字段(如lead_agent、team_features)与协作布局无缝映射,同时确保验证结果的可靠性(仅verified为true的轨迹作为成功子集),这对数据清洗和一致性维护提出了严苛要求。
常用场景
经典使用场景
在多智能体协作研究领域,team-coop数据集为探究双智能体系统协同完成复杂软件工程任务提供了标准化的评估基准。该数据集包含1304条轨迹,源自两个完整的团队运行配置,每个配置涵盖652组智能体对在12个代码仓库上的协作过程。研究者可以系统地分析在不同团队设置下(如是否启用协议动词),智能体作为领导者和成员在共享任务列表、工作记忆和模型上下文协议环境中的交互模式,从而探索协作协议对整体任务完成率的影响。
解决学术问题
该数据集解决了多智能体系统研究中缺乏标准化、可复现的协作评估基准这一核心问题。通过记录带有验证标签的完整对话轨迹和代码补丁,研究者能够深入分析智能体间通信效率、任务分配策略及冲突解决机制对协作成功率的因果影响。数据集中61.8%和59.8%的通过率对比,为量化协议设计在协作中的作用提供了直接证据,推动了多智能体协同机制的理论建模与实证研究。
衍生相关工作
基于该数据集,研究者已发展出多项衍生工作,包括对团队特征(如自动刷新机制)与协议动词组合效果的消融分析,以及从对话日志中提取协作策略的元学习方法。CooperBench框架本身依托该数据定义了标准化的评估流程,后续工作如异构智能体协作研究、基于强化学习的通信策略优化等,均以该数据集作为基础验证平台。此外,数据集中的轨迹数据被用于训练能够模拟领导-成员交互的协作推理模型,推动了多智能体系统从规则驱动向数据驱动范式的转变。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

