VLA_Benchmark_Prompted_1200
收藏资源简介:
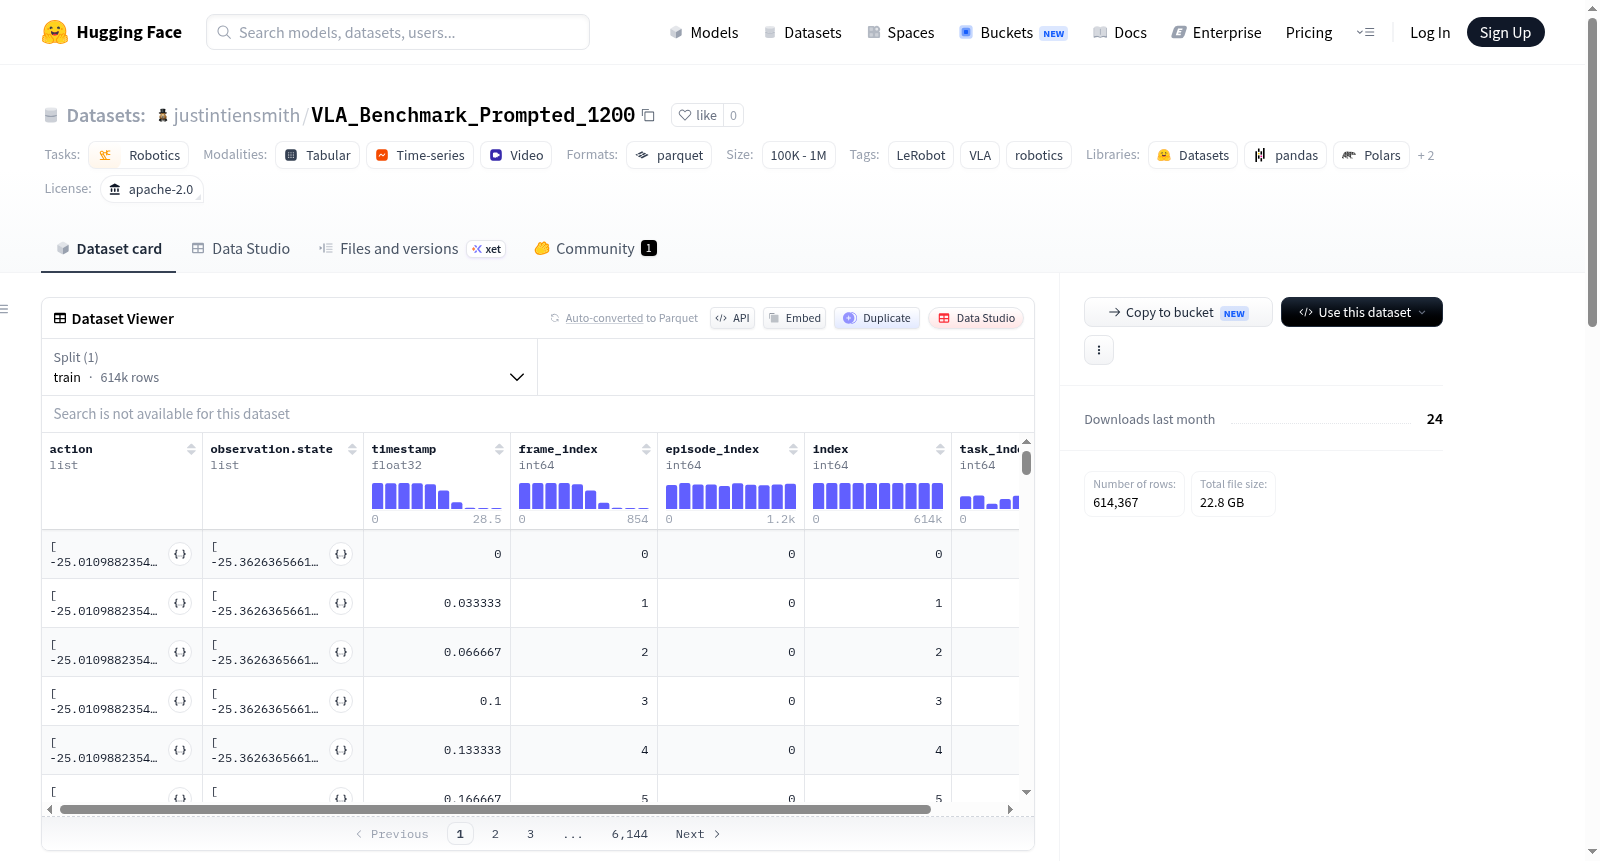
VLA Benchmark Prompted 1200 数据集是一个非破坏性的 LeRobot v3.0 版本,由六个各包含 200 个 episodes 的基准数据集合并而成。该数据集总计包含 1,200 个训练 episodes 和 614,367 帧数据。每个 episode 的任务字符串均来源于 `meta/benchmark/prompt_manifest_v2.csv` 文件中指定的提示。数据集中,可乐和百事可乐对象被规范地标注为压扁的可乐罐和压扁的百事可乐罐。所有数据行均属于训练集分割。在提示设计方面,提示清单 v2 版本仅更改了 200 个状态识别任务字符串:在微调过程中明确展示了“打开”和“倒置”状态;而“关闭”和“直立”状态则被保留,不出现在微调语言中。关闭/直立状态的物理演示仍保留在训练集中,但使用诸如“将白色杯子放入碗中”之类的类别专用提示。这些类别专用提示在所有四种物理状态/朝向单元中共享,因此通用措辞并非关闭或直立状态的代称。数据集还包含一个状态识别回忆覆盖层:在 2026-07-29,按照检查表行顺序,用来自 `justintiensmith/MT_State_Recognition_40` 数据集的 episodes 0–39 替换了 40 个经检查表选定的 episode 插槽,同时保留了原有的 episode 提示和任务索引。替换后数据集仍包含 614,367 帧。该数据集整合了六个源数据集,分别专注于不同的子任务:状态识别、关系放置、指代消歧、排序、计数和大小识别。它适用于机器人学和视觉语言动作(VLA)领域的研究与开发,特别是涉及多任务学习、状态理解、物体操作和基于提示的任务执行等场景。
The VLA Benchmark Prompted 1200 dataset is a non-destructive LeRobot v3.0 version, merged from six benchmark datasets each containing 200 episodes. The dataset contains a total of 1,200 training episodes and 614,367 frames. Each episodes task string is derived from the prompts specified in the `meta/benchmark/prompt_manifest_v2.csv` file. In the dataset, Coke and Pepsi objects are consistently labeled as crushed Coke can and crushed Pepsi can. All data rows belong to the training set split. In terms of prompt design, the prompt manifest v2 only changed 200 state recognition task strings: during fine-tuning, the "open" and "inverted" states are explicitly demonstrated; while the "closed" and "upright" states are retained and not present in the fine-tuning language. Physical demonstrations of closed/upright states are still preserved in the training set, but use category-specific prompts such as "place the white cup in the bowl". These category-specific prompts are shared across all four physical state/orientation units, so the generic wording is not a substitute for closed or upright states. The dataset also includes a state recognition recall overlay: on 2026-07-29, 40 episode slots selected by a checklist were replaced with episodes 0–39 from the `justintiensmith/MT_State_Recognition_40` dataset, preserving the original episode prompts and task indices. The dataset still contains 614,367 frames after replacement. This dataset integrates six source datasets, each focusing on different sub-tasks: state recognition, relational placement, reference disambiguation, sorting, counting, and size recognition. It is suitable for research and development in robotics and visual language action (VLA), especially for scenarios involving multi-task learning, state understanding, object manipulation, and prompt-based task execution.
数据集概述:VLA Benchmark Prompted 1200
- 数据集地址:https://huggingface.co/datasets/justintiensmith/VLA_Benchmark_Prompted_1200
- 许可证:Apache-2.0
- 任务类别:机器人学(robotics)
- 标签:LeRobot、VLA、机器人学
数据集构成
- 总集数:1,200 个训练集(episodes)
- 总帧数:614,367 帧
- 数据格式:Parquet 文件,位于
data/*/*.parquet - 数据分割:所有数据均为训练集(training split)
数据来源
该数据集是对六个各包含 200 集(episodes)的基准数据集进行的非破坏性 LeRobot v3.0 合并,每个子集的修订版本如下(均锁定到特定提交哈希):
justintiensmith/MT_State_Recognition_200(提交168e12e735da9ad62716dca89cff660b53082cc3)justintiensmith/SP_Relational_Placement_200(提交8eff46af18af7a9a6f763ed975f8b3357c673685)justintiensmith/SP_Referential_Disambiguation_200(提交2642784f74a0c91bc118702b7993895aacd311f5)justintiensmith/SP_Sequencing_200(提交1cda4c4c3c6ae1fa4b5dc6d2cf4c887bb9f1da4e)justintiensmith/SP_Counting_200(提交6591c0f19952e23010b7c6a0630e4d60f8714cbb)justintiensmith/MT_Size_Recognition_200(提交3a6e75d91e8339a87eebd8e545d87b148ae19925)
此外,在 2026-07-29,通过从数据集 justintiensmith/MT_State_Recognition_40(提交 33c4b378b5867aa82ef7fd0b4f6157f0c11f7a05)替换了 40 个选中的集(episodes),替换后总帧数仍为 614,367 帧。
任务与提示设计
- 任务字符串:每个集(episode)的任务字符串由
meta/benchmark/prompt_manifest_v2.csv中的指定提示(prompt)确定 - V2 提示设计:仅对 200 个“状态识别”(State Recognition)任务字符串进行了修改:
open和upside-down在微调时被明确展示closed和upright在微调语言中未被包含(被故意保留)closed和upright的物理演示仍保留在训练中,但仅使用类别提示,例如“Place a white cup in the bowl.”- 类别提示在所有四种物理状态/方向单元格中共享
- 采样权重:推荐采样权重记录在
meta/benchmark/prompt_manifest_v2.xlsx中(该数据集不复制或过采样集) - 原视频与轨迹:与 V1 提示版本相比无变化
- 保留文件:V1 清单和验证文件被保留用于溯源
物体标注
- Coke 和 Pepsi 物体:标准标注为压扁的可口可乐罐和压扁的百事可乐罐
本地标识符
justintiensmith/VLA_Benchmark_Prompted_1200