
遇见数据集

WithinUsAI/The_Web_From_WithIn_10k

收藏
Hugging Face2026-06-07 更新2026-06-14 收录
官方服务:

资源简介:

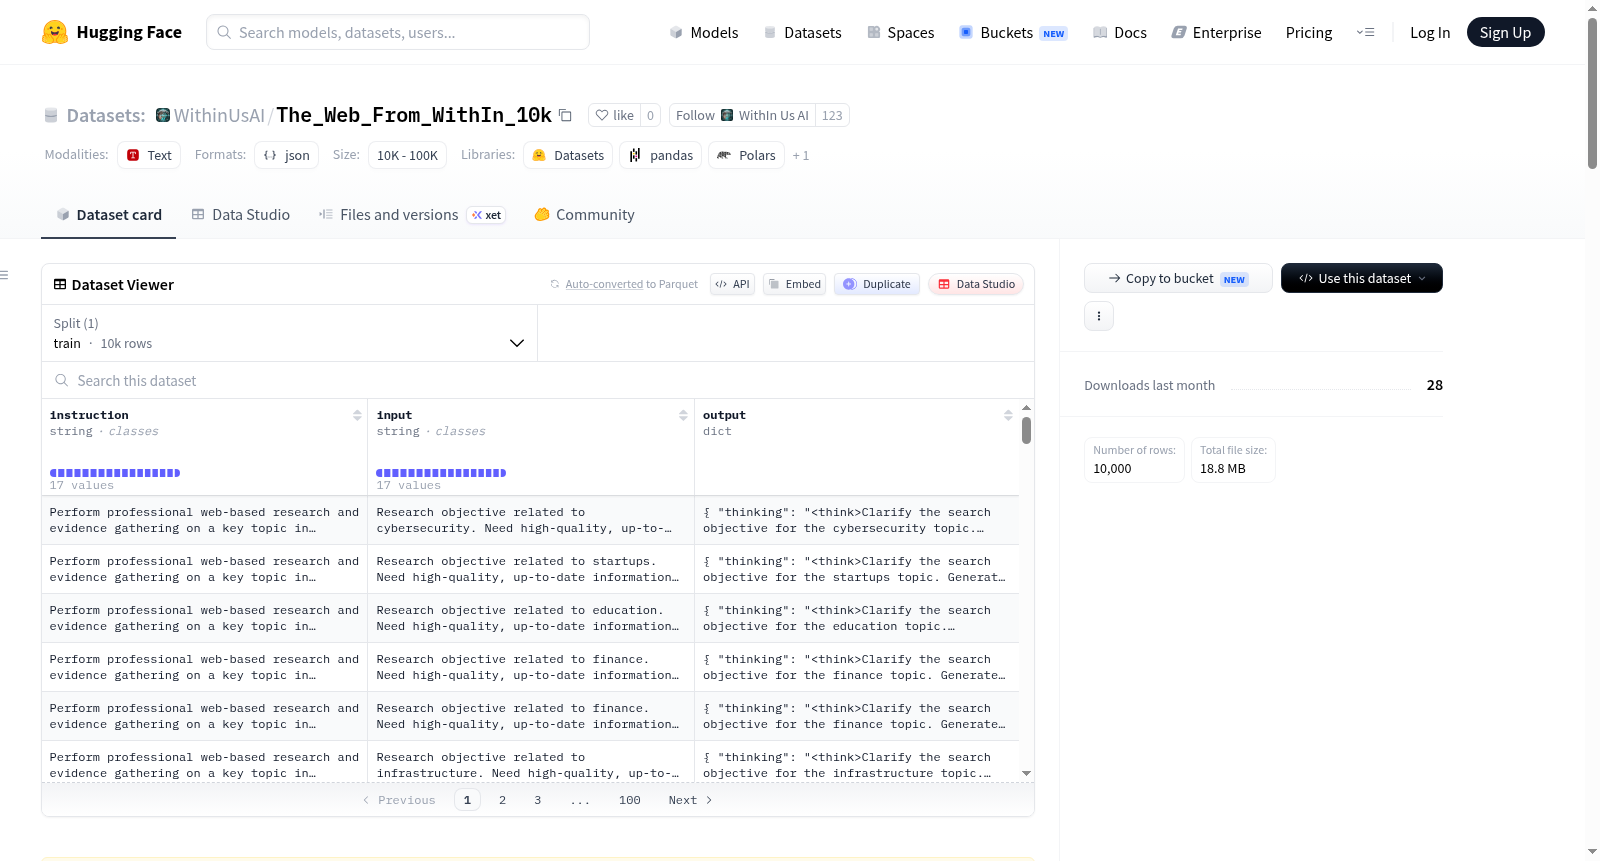
The_Web_From_WithIn_10k是一个前沿质量的数据集,旨在训练先进的基于网络的自主代理语言模型,专注于专业的网络搜索、信息检索、来源发现、搜索优化和网络证据收集。每个示例都展示了专业的搜索推理、查询生成、来源发现、质量评估、信息提取和综合,这些内容都包含在<thinking>标签内。该数据集包含10,000个独特示例,覆盖技术文档、AI研究、机器学习、软件工程、网络安全、医学、科学、金融、商业、创业公司、基础设施、云计算、教育、法律、经济学、制造业和物流等多个领域。数据集采用JSONL格式,每个JSON对象包含指令、输入和输出字段,其中输出字段详细记录了思维过程、搜索目标、搜索查询、候选来源、来源质量分析、发现的信息和最终总结。数据集经过严格的去重和验证过程,确保逻辑一致性、专业语气和来源评估质量,适用于监督微调,以提升网络搜索质量、来源评估和证据收集能力。

The_Web_From_WithIn_10k is a frontier-quality dataset designed to train advanced web-enabled autonomous agentic language models on professional web search, information retrieval, source discovery, search refinement, and evidence gathering from the web. Every example demonstrates professional search reasoning, query generation, source discovery, quality evaluation, information extraction, and synthesis inside <think> tags. The dataset contains 10,000 unique examples covering domains such as technical documentation, AI research, machine learning, software engineering, cybersecurity, medicine, science, finance, business, startups, infrastructure, cloud computing, education, law, economics, manufacturing, and logistics. It is formatted in JSONL, with each JSON object including instruction, input, and output fields, where the output field details thinking processes, search objectives, search queries, candidate sources, source quality analysis, information found, and final summary. The dataset undergoes aggressive deduplication and validation for logical consistency, professional tone, and source evaluation quality, and is recommended for supervised fine-tuning to improve web search quality, source evaluation, and evidence gathering capabilities.
提供机构:
WithinUsAI
搜集汇总
数据集介绍
WithinUsAI/The_Web_From_WithIn_10k 数据集图片
构建方式
该数据集由WithIn Us Ai精心构建,包含一万条独特的专业级示例,以JSONL格式存储。每一条数据均模拟了高级网络智能体在真实场景中的完整信息检索流程:从接收研究请求开始,记录详尽的内在推理过程,包括搜索策略制定、查询生成、候选来源识别、来源质量评估、关键信息提取,直至最终综合摘要的生成。所有示例均经过严格去重与逻辑一致性验证,确保无重复、模板化或低质量内容,从而为训练面向网络的专业自主智能体提供坚实的质量基础。
特点
数据集的显著特点在于其对专业网络研究行为的深度建模与丰富覆盖。每条示例均包含结构化的推理痕迹与多个字段,完整呈现了从问题分析到证据综合的认知链条。其覆盖领域极为广泛,横跨人工智能、软件工程、网络安全、医学、金融、法律等多个专业学科。尤为突出的是,数据集专注于教授模型如何执行权威性评估、来源可信度判断以及多源信息整合,这使其区别于常规的问答或对话数据集,成为培养前沿网络智能体核心能力的稀缺资源。
使用方法
该数据集主要面向监督微调范式,旨在强化模型在开放网络环境下的研究能力与信息素养。推荐在训练过程中完整保留<think>标签内的链式推理过程,以引导模型学习结构化的决策思维。此数据集可作为构建更高级网络智能体能力的基石,例如网页浏览操作、精确信息抽取以及完全自主的网络交互循环。研究人员可直接加载JSONL文件,利用其中的指令与输出对进行模型训练,从而显著提升模型执行专业网络搜索与证据收集任务的表现。
背景与挑战
背景概述
在大型语言模型(LLM)向自主智能体演进的浪潮中,如何赋予模型专业级的网络搜索与信息溯源能力成为核心瓶颈。由WithIn Us Ai团队于2026年发布的The_Web_From_WithIn_10k数据集,正是为攻克这一难题而生的前沿资源。该数据集包含10,000条高质量的专业网络研究示例,每条样本均细致展示了从查询生成、来源评估到证据综合的完整推理轨迹。其核心研究问题聚焦于如何让LLM掌握人类专家级别的网络调研方法论,从而支撑起可靠、可溯源的自主信息获取行为。作为该领域首批大规模、结构化、经过严格去重与验证的公开数据集之一,它填补了训练语料中缺乏专业化搜索推理链的空白,对推动可信、高效的网络智能体研究具有里程碑意义。
当前挑战
该数据集所应对的核心挑战来源于两大层面。领域层面,现有LLM普遍缺乏对网络信息来源进行权威性评估、多源证据交叉验证、以及动态优化查询策略的能力,导致在开放网络环境下的信息检索常存在不可靠、不完整甚至误导性问题,严重制约了智能体在医疗、金融、法律等高风险场景中的实际应用。构建层面,团队面临如何生成10,000条兼具专业真实性(而非模板化)与多样化覆盖(横跨18个垂直领域)的推理样本,同时必须对语义和结构进行激进去重以确保每条样本提供独立的训练信号,验证逻辑一致性、来源评价质量与领域覆盖度的流程亦构成巨大工程挑战。
常用场景
经典使用场景
在人工智能与信息检索的交叉领域中,The_Web_From_WithIn_10k 数据集为训练具备专业级网络搜索与信息综合能力的自主智能体提供了高质量的监督微调资源。其核心用途在于引导语言模型掌握从查询公式化、源头发现、权威性评估到证据抽取与综合的完整研究流程。每条样本都包含具备逻辑推理深度的<think>思维链,使得模型能够在复杂的开放网络环境中模拟真实的高级研究人员行为,从而显著提升智能体在学术证据收集、技术文献追踪及跨领域知识整合等任务上的表现。
解决学术问题
该数据集直面当前大型语言模型在网络搜索中普遍存在的浅层检索与来源误判等关键局限。通过提供10,000条涵盖18个专业领域的高质量推理示例,系统性地解决了模型在查询精细化、源头质量多维评估、证据权威性判定及多源信息综合归纳方面的能力短板。其意义在于推动了从简单的关键词匹配向具备深度语义理解与批判性思维的智能化研究范式的转变,为构建能在开放域中自主进行严谨学术调研和事实核查的下一代智能体奠定了数据基础。
衍生相关工作
该数据集的诞生为智能体领域的系列创新提供了源头活水。基于其高质量的思维链示范,研究者得以衍生出专门针对网络浏览路径规划与动态网页信息解析的增强型训练策略。此外,数据集中对源头质量的精细评估范式启发了后续关于可验证信息检索与对抗性事实核查模型的研究。同时,其结构化的搜索目标与查询对设计,为构建多轮交互式研究助手及能够自主迭代搜索策略的闭环智能体系统提供了关键的基准数据集与训练蓝图。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

