
遇见数据集

terminal_bench_2_tasktrove_dq_pymethods2test_step75_30b_a3b_20260730_054052

收藏
Hugging Face2026-07-30 更新2026-08-01 收录
官方服务:

资源简介:

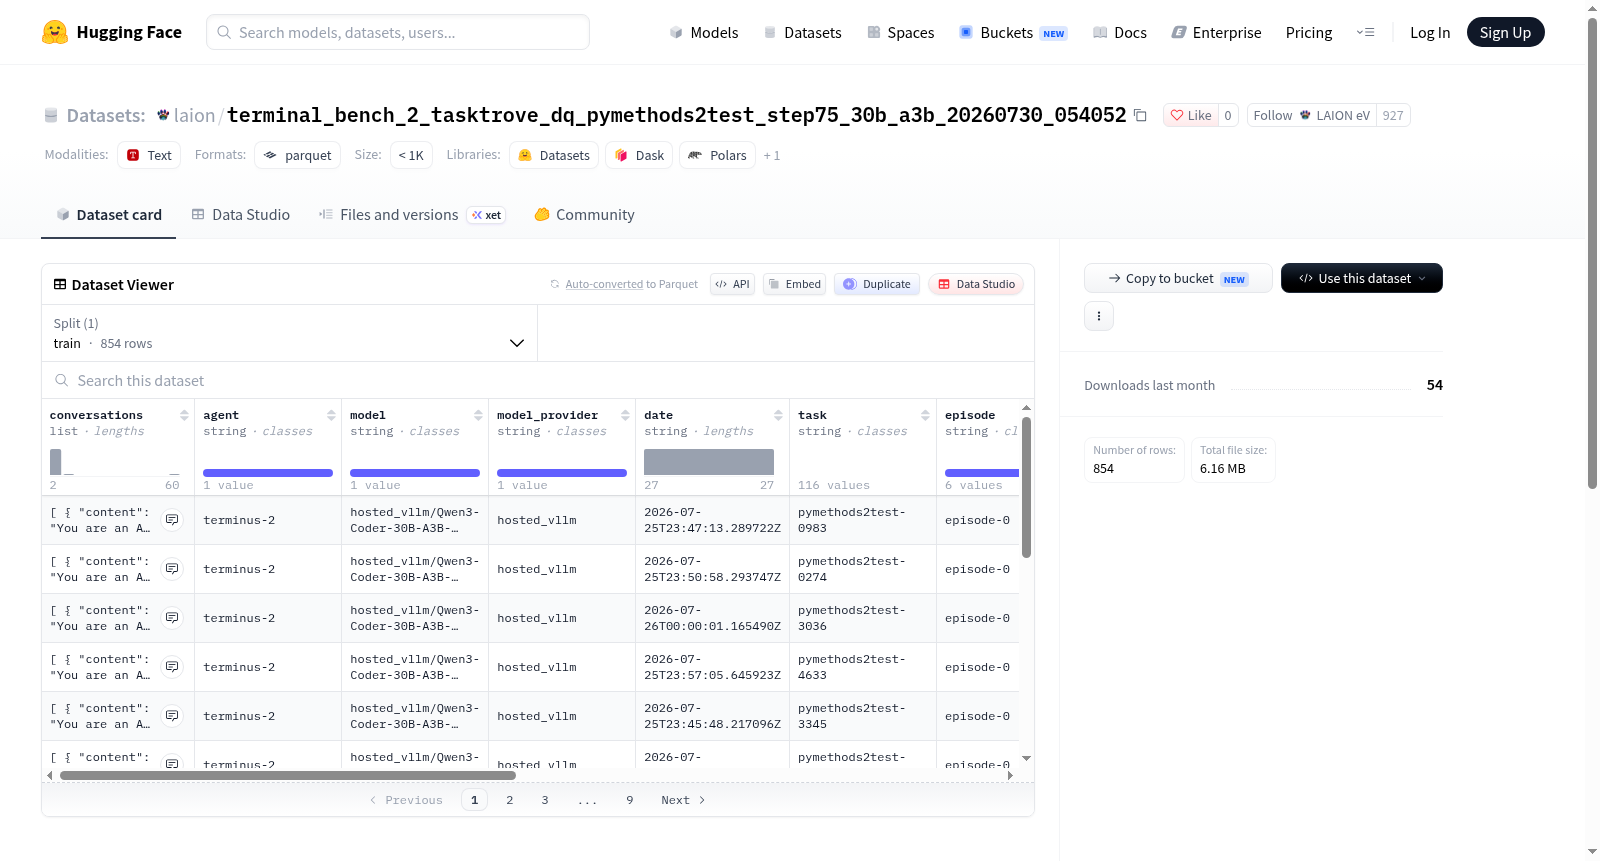
该数据集名为`terminal_bench_2_tasktrove_dq_pymethods2test_step75_30b_a3b`,包含来自Iris强化学习运行(`rl-tasktrove-dq-sweep-30b-terminus2-qwen-20260725-231748-4fe0b4`)的Terminus-2智能体轨迹。数据从该运行的Harbor `trace_jobs` artifacts中导出,每个trial仅保留最后一个episode。数据集覆盖了所有948个trial目录,其中854个成功完成并生成了`result.json`,因此包含854条记录。每条记录包含多轮对话(conversations)、智能体名称(agent)、模型名称(model)、模型提供者(model_provider)、日期(date)、任务(task)、episode编号、运行ID(run_id)、trial名称(trial_name)、结果(result)、指令(instruction)以及验证器输出(verifier_output)等字段。该数据集适用于分析智能体在特定任务上的行为、强化学习训练效果以及模型性能评估。

The dataset named `terminal_bench_2_tasktrove_dq_pymethods2test_step75_30b_a3b` contains Terminus-2 agent trajectories from an Iris reinforcement learning run (`rl-tasktrove-dq-sweep-30b-terminus2-qwen-20260725-231748-4fe0b4`). Data was exported from that runs Harbor `trace_jobs` artifacts, keeping only the last episode per trial. It covers all 948 trial directories, with 854 successful completions producing `result.json`, thus containing 854 records. Each record includes multi-turn conversations, agent name, model name, model provider, date, task, episode number, run ID, trial name, result, instruction, and verifier output fields. This dataset is suitable for analyzing agent behavior on specific tasks, reinforcement learning training effects, and model performance evaluation.

提供机构:
LAION eV
创建时间:
2026-07-30
原始信息汇总

数据集概述

该数据集名为 terminal_bench_2_tasktrove_dq_pymethods2test_step75_30b_a3b,来源于 Terminus-2 agent 在 Iris RL 运行(rl-tasktrove-dq-sweep-30b-terminus2-qwen-20260725-231748-4fe0b4)中产生的追踪数据。数据从该运行的 Harbor trace_jobs 工件中导出,每个试验仅包含最后一个片段(episode)。

数据规模

  • 试验目录总数:948
  • 含有 result.json 的试验数:854(每个试验对应一行数据)
  • 数据行数:854
  • result.json 的试验数:94(这些试验从未完成可计分片段,因此不贡献任何行)

数据划分

  • 训练集(train):854 条样本,占数据总大小约 10,596,509 字节
  • 下载大小:约 6,159,465 字节

字段结构

每条样本包含以下字段:

字段名 类型 说明
conversations 列表 对话记录,每条包含 content(字符串)和 role(字符串)
agent 字符串 智能体名称
model 字符串 模型名称
model_provider 字符串 模型提供方
date 字符串 日期
task 字符串 任务标识
episode 字符串 片段标识
run_id 字符串 运行 ID
trial_name 字符串 试验名称
result 字符串 试验结果
instruction 字符串 指令内容
verifier_output 字符串 验证器输出

版本说明

该数据集早期版本包含 255 行数据,基于追踪树的部分本地镜像构建。当前版本已由完整导出数据替换,覆盖了该运行的全部试验目录。
搜集汇总
数据集介绍
terminal_bench_2_tasktrove_dq_pymethods2test_step75_30b_a3b_20260730_054052 数据集图片
构建方式
该数据集源自Iris强化学习运行中Terminus-2智能体在终端任务基准测试(Terminal-Bench 2)下的完整交互轨迹导出,针对任务集合tasktrove中pymethods2test类别的三十亿参数模型实验。构建过程以该次训练的Harbor追踪任务产物为数据源,对948个试验目录逐一枚举,仅保留成功生成result.json且完成可评分回合的试验,最终以每次试验最后一轮对话为记录单元,形成854条数据行,并完整覆盖该次运行的全部有效试验,取代了此前基于部分本地镜像生成的255条不完整版本。
使用方法
使用者可通过HuggingFace数据集加载接口读取默认配置下的训练集划分,获取以对话序列为核心的样本集合。加载后可按role与content字段还原智能体与环境的交互过程,结合instruction与task字段定位任务上下文,利用result与verifier_output字段评估任务完成情况。由于数据来源于特定强化学习运行,适合用于智能体行为分析、终端任务基准的轨迹级评估以及模型推理过程的可复现研究,使用时应结合run_id与trial_name等标识确保试验级别的对齐与追溯。
背景与挑战
背景概述
随着大语言模型在软件工程自动化领域的深入应用,基于终端交互的智能体评估已成为衡量模型实际编程能力的关键环节。terminal_bench_2_tasktrove_dq_pymethods2test_step75_30b_a3b数据集源于Iris强化学习运行中Terminus-2智能体的完整轨迹导出,聚焦于Python方法到测试代码生成的任务场景。该数据集由相关研究团队于2026年构建,依托Harbor trace_jobs工件系统,完整枚举了948个试验目录,收录了854个产生可评分结果的试验轨迹。其核心研究问题在于探索终端环境下智能体如何通过多轮交互完成代码理解与测试生成任务,为强化学习训练和智能体行为分析提供了细粒度的过程性数据支撑,对自动化软件测试与智能体评估领域具有重要的实证参考价值。
当前挑战
该数据集所应对的领域问题在于终端环境中代码生成任务的复杂性与多样性,智能体需在缺乏显式反馈的条件下完成从方法理解到测试用例编写的完整推理链条。构建过程中面临的挑战主要体现在轨迹数据的完整性与一致性保障方面:原始试验目录中存在94个未产生result.json的试验,这些试验因未能完成可评分回合而无法纳入数据集,导致最终样本量与初始枚举量之间存在缺口。此外,从Harbor trace_jobs工件中提取每个试验的末次回合轨迹,需要处理多轮对话状态、验证器输出与结果标签之间的对齐问题,确保每条数据在任务、模型、提供商等元信息维度上保持准确映射,这对数据清洗与质量控制的规范性提出了较高要求。
常用场景
经典使用场景
在软件工程自动化与智能体评测领域,终端环境下的代码操作任务长期被视为检验自主智能体综合能力的试金石。该数据集立足于Terminal-Bench 2框架下的TaskTrove任务体系,汇聚了Terminus-2智能体在真实终端交互中产生的854条完整轨迹,涵盖从代码方法定义到单元测试生成的端到端流程。其最经典的使用场景在于以多轮对话形式刻画智能体如何解析任务指令、调用终端命令、迭代修复代码并最终通过验证器评估,从而为智能体在复杂命令行环境中的规划、执行与反思能力提供细粒度的行为记录。
解决学术问题
面向智能体可复现性与过程监督评估的学术需求,该数据集回应了以往研究中轨迹数据零散、覆盖不全及验证信号缺失等痼疾。通过完整枚举948个试验目录并保留产生有效评分结果的854条记录,它使得研究者能够在统一的任务语义与验证器输出下,系统考察智能体在长程决策中的失败模式、工具调用偏好及奖励信号对齐程度。其意义在于为强化学习训练动态分析、过程奖励模型构建以及智能体鲁棒性基准测试提供了透明且可审计的数据基础,推动了智能体评测范式从结果导向向过程导向的演进。
实际应用
在工程实践中,该数据集可直接服务于智能体训练与部署的多个环节。研发团队能够借助其轨迹与验证器输出开展离线策略评估,诊断模型在真实终端任务中的执行瓶颈;也可将其作为模仿学习或拒绝采样的语料来源,提升代码生成与测试合成智能体的端到端成功率。此外,任务指令与运行元数据的结构化组织便于构建回归测试集,帮助持续集成流程识别智能体行为漂移,辅助开发者在DevOps自动化、代码审查辅助及缺陷定位等场景中验证模型效能。
数据集最近研究
最新研究方向
在强化学习与软件工程自动化交汇的前沿,基于终端交互的智能体研究正迅速升温。terminal_bench_2_tasktrove_dq_pymethods2test_step75_30b_a3b数据集源自Iris强化学习运行中Terminus-2智能体的完整轨迹导出,涵盖854条可评分任务回合,系统记录了智能体在代码方法转换与测试生成场景中的对话、模型调用、验证器输出及运行结果。该数据集聚焦于以终端为交互界面的复杂任务求解,推动了对智能体长程规划、错误恢复与工具使用能力的量化评估。其完整覆盖948个试验目录并剔除非评分性轨迹,为可复现的强化学习策略分析提供了高质量基准,对自动化软件测试、程序合成及智能体训练等热点领域具有重要的实证支撑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

