
遇见数据集

HuggingFaceBio/malinois-mpra-regression

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

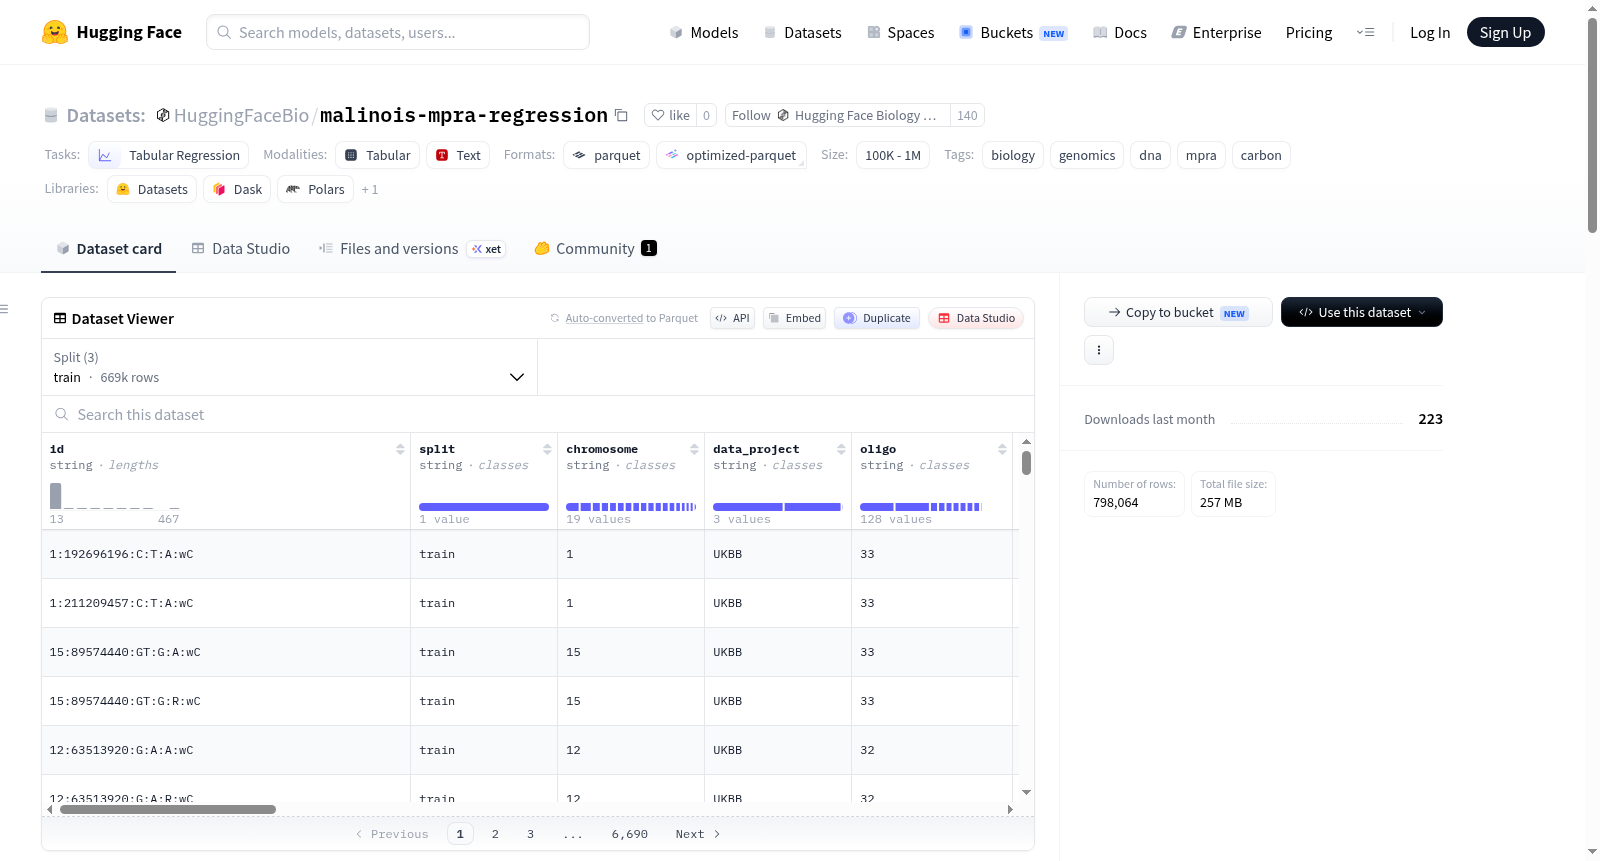
该数据集对Gosai等人2024年发表的Nature论文中的补充MPRA表格进行了预处理,用于Malinois基准中的监督DNA到活性回归任务。每一行包含一个DNA序列和三个细胞类型特异性活性目标:K562_log2FC、HepG2_log2FC和SKNSH_log2FC。数据集规模在10万到100万行之间,适用于表格回归任务,涉及生物学、基因组学、DNA和MPRA领域。数据分割遵循Carbon微调实验和公开的Malinois设置,包括训练集、验证集和测试集,总行数经过过滤后为798,064行。列包括ID、分割标签、染色体信息、元数据、DNA序列、反向互补序列、连接序列、原始回归目标、标准误差、标准化目标以及过滤标志等。使用示例展示了如何加载数据集并提取序列和标签。

This dataset preprocesses the Gosai et al. 2024 supplementary MPRA table used by the Malinois benchmark for supervised DNA-to-activity regression. Each row contains a DNA sequence and three cell-type-specific activity targets: K562_log2FC, HepG2_log2FC, and SKNSH_log2FC. The dataset size is between 100K and 1M rows, categorized under tabular-regression tasks with tags in biology, genomics, dna, and mpra. Splits follow the Carbon fine-tuning experiments and the public Malinois setup, including train, validation, and test sets, with a total of 798,064 rows after filtering. Columns include ID, split, chromosome, metadata, DNA sequence, reverse complement, concatenated sequence, raw regression targets, standard errors, standardized targets, and filtering flags. Usage examples demonstrate loading the dataset and extracting sequences and labels.
提供机构:
HuggingFaceBio
搜集汇总
数据集介绍
HuggingFaceBio/malinois-mpra-regression 数据集图片
构建方式
该数据集源自Gosai等人于2024年发表于Nature的补充材料,经精密预处理后形成,旨在支持监督式DNA序列至活性的回归任务。数据构建遵循染色体划分原则,与Carbon微调实验及Malinois基准的设定保持一致,将数据划分为训练集、验证集和测试集,分别包含668,946、62,406和66,712条记录。每一行记录涵盖DNA序列、反向互补序列及其串联形式,并附带三个细胞类型特异的活性目标值及对应的标准误差。此外,数据集还衍生了标准化目标值和多项过滤标记,如所有标准误小于等于1的指示符,以及任一活性值大于0.5的指示符,为下游分析提供了灵活的筛选维度。
特点
该数据集的核心特点在于其规模宏大且注释详实,总计超过79万条非冗余序列,覆盖K562、HepG2和SKNSH三种细胞系的活性数据,为多任务回归建模提供了丰富的标注。序列信息经过标准化处理,包括正向、反向互补及串联拼接形式,适配不同深度学习架构的输入需求。数据集的划分策略参考染色体边界,确保训练与测试集间的序列独立性,降低了信息泄漏风险。同时,数据集提供了基于训练集计算的z-score标准化值,便于模型收敛,并包含多个质量过滤标记,使用户能够根据研究目的灵活构建子集,兼顾数据的完整性与可靠性。
使用方法
使用者可通过HuggingFace的datasets库便捷加载该数据集,一句命令即可获取划分好的训练、验证及测试集。在模型训练阶段,推荐采用forward_rc_concat序列作为输入,以充分利用正反向链信息,并选用训练集z-score作为回归目标,以提升训练稳定性。验证与测试时,可依据all_se_le_1字段筛选高置信度样本,从而获得更严谨的性能评估。对于需要强调高活性区域的任务,可借助any_log2fc_gt_0_5字段进行上采样策略。此外,数据集的复现脚本公开可用,允许用户自行重建或扩展,确保研究的可重复性与透明性。
背景与挑战
背景概述
该数据集源自Gosai等人于2024年在《Nature》上发表的关于机器引导设计细胞类型靶向顺式调控元件的研究,由Malinois基准测试团队预处理并发布,旨在支持DNA序列到细胞类型特异性活性的回归预测。数据集整合了大规模平行报告基因分析(MPRA)的补充数据,包含约80万条DNA序列及其在K562、HepG2和SKNSH三种细胞系中的活性值,为基因调控的定量建模提供了宝贵资源。其创建时间点为2024年,主要研究人员为Malinois项目组,核心研究问题在于通过监督学习解析顺式调控元件的序列-功能关系,对基因组学与合成生物学领域具有重要推动作用。
当前挑战
在领域问题层面,该数据集直面DNA序列到基因表达活性映射的复杂性,包括序列上下文依赖性、细胞类型特异性调控机制以及非线性相互作用,这对回归模型的泛化能力构成显著挑战。在构建过程中,团队需处理原始补充表中的缺失值、非标准染色体标注及序列空值,并依据染色体划分训练、验证和测试集以确保评估的可靠性。此外,针对测量噪声,数据集引入了标准误差阈值过滤(如all_se_le_1)和z-score标准化策略,以平衡数据质量与规模,同时需兼顾不同细胞系间活性分布的异质性,这些预处理步骤均对数据集的科学严谨性提出了较高要求。
常用场景
经典使用场景
该数据集作为基因组学与深度学习交叉领域的典范资源,其核心应用场景聚焦于顺式调控元件(CREs)的活性定量预测。具体而言,研究者可基于DNA序列直接回归预测三种人类细胞系(K562、HepG2、SKNSH)中的转录活性水平,以log2FC为量化指标。这一任务形式精准契合了大规模平行报告基因分析(MPRA)数据的监督学习范式,为探索非编码基因组的功能编码规律提供了标准化的数据基础。
衍生相关工作
围绕该数据集已衍生出一系列开创性工作,其中最具代表性的是Malinois基准测试框架,它系统性地评估了各类基因组语言模型在DNA-活性回归任务上的性能。此外,该数据作为Carbon模型微调的关键组成部分,推动了基于卷积神经网络和Transformer架构的调控元件预测模型的发展。后续研究还利用该数据训练出的模型,结合可解释性分析,揭示了序列中决定细胞类型特异性的关键调控语法,从而进一步深化了对人类基因表达调控机制的理解。
数据集最近研究
最新研究方向
基于大规模MPRA数据与深度学习模型,该数据集推动了顺式调控元件设计领域的范式革新。研究焦点在于利用基因组序列直接预测细胞类型特异性的转录活性,并探索跨细胞系的调控逻辑。前沿方向包括结合预训练基因组语言模型(如Carbon)进行微调,以捕捉序列上下文与调控语法;同时,通过高置信度过滤和标准化策略提升回归任务的稳健性。该数据集的发布为可编程细胞类型靶向的合成调控元件设计提供了基准,加速了合成生物学与精准医学中基因表达的精细调控研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

