dramabox-edge-top3-voice
收藏资源简介:
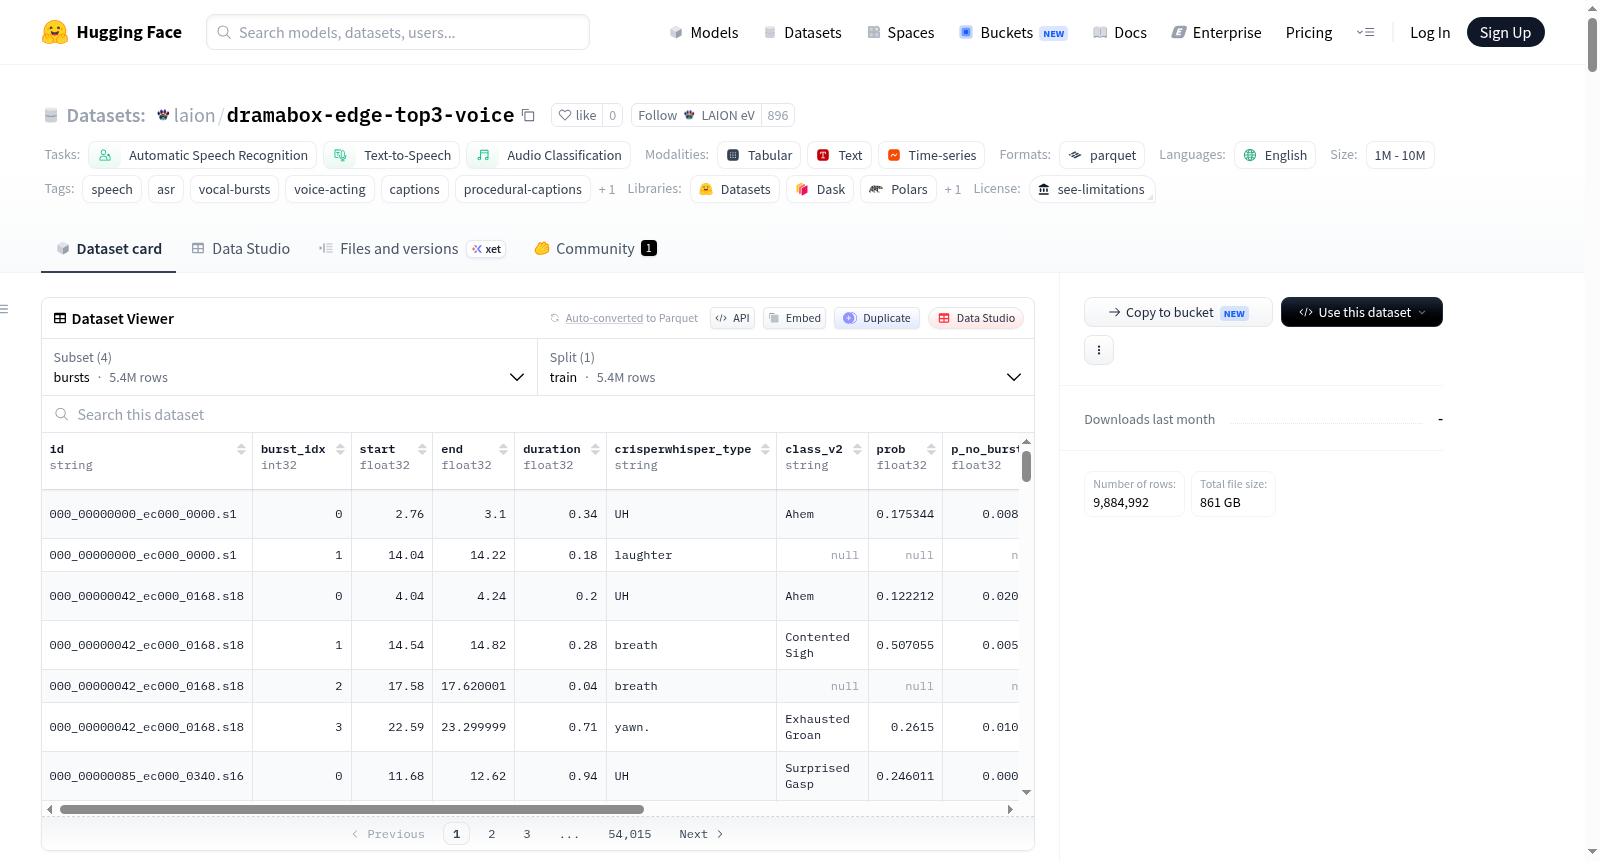
DramaBox edge-case reward-Top-3 语音标注数据集包含 1,494,503 条合成表达性语音话语,源自 DramaBox 边缘案例语料库的奖励模型 Top-3 选择。数据集提供了四类注释:(a)经过修正爆发音的 CrisperWhisper 格式转录文本,其中每个保留的爆发音均带有来自 laion/vocal-burst-detector-v2 的分类名称及其原始时间戳;(b)来自 laion/Empathic-Insight-Voice-Plus 的原始语音评分,包括全话语粒度和每个句子粒度的 40 种情绪、57 个 VoiceNet 维度、真实性、爆发音混合度及 4 个质量评分;(c)基于这些评分生成的程序化字幕,包含 <GENERAL> 和 <SCRIPT> 标签,带有按句子的语调提示(圆括号内)、内联爆发音类别名称(圆括号内)以及停顿时长(方括号内);(d)与元数据对齐的源音频,以 WebDataset tar 分片形式提供,48 kHz 单声道 MP3 编码,160 kbps。数据集总大小约 802 GiB(其中音频约 796 GiB,11,840 小时),分为 128 个分片。所有五个元数据家族(transcripts、scores、bursts、captions、audio)通过 id 字段连接。该数据集适用于自动语音识别(ASR)、文本转语音(TTS)、音频分类、语音情感分析、爆发音检测等任务。需要注意的是,爆发音的时间戳来自 ASR 模型而非人工标注,分类标签准确率有限(argmax 准确率约 58.1%),且类别分布高度集中在少数标签上(前三类占保留爆发音的 72.5%)。字幕可通过仅读取 scores 数据并运行 CPU 脚本重新生成,无需音频或 GPU。
The DramaBox edge-case reward-Top-3 speech annotation dataset contains 1,494,503 synthetic expressive speech utterances derived from the reward model Top-3 selection of the DramaBox edge-case corpus. The dataset provides four types of annotations: (a) CrisperWhisper-formatted transcribed text with corrected vocal bursts, where each retained burst includes a classification name from laion/vocal-burst-detector-v2 and its original timestamp; (b) raw speech scores from laion/Empathic-Insight-Voice-Plus, including 40 emotions, 57 VoiceNet dimensions, authenticity, burst mixture, and 4 quality scores at both utterance and sentence granularity; (c) programmatic captions generated from these scores, containing <GENERAL> and <SCRIPT> tags with per-sentence intonation cues (in parentheses), inline burst category names (in parentheses), and pause durations (in brackets); (d) source audio aligned with metadata, provided as WebDataset tar shards, 48 kHz mono MP3 at 160 kbps. The total dataset size is approximately 802 GiB (audio ~796 GiB, 11,840 hours), divided into 128 shards. All five metadata families (transcripts, scores, bursts, captions, audio) are linked via the id field. The dataset is suitable for tasks such as automatic speech recognition (ASR), text-to-speech (TTS), audio classification, speech emotion analysis, and vocal burst detection. Note that burst timestamps come from an ASR model rather than manual annotation, classification label accuracy is limited (argmax accuracy ~58.1%), and the class distribution is highly concentrated on a few labels (top 3 classes account for 72.5% of retained bursts). Captions can be regenerated by reading only the scores data and running a CPU script, without requiring audio or GPU.
DramaBox edge-case reward-Top-3 — 语音标注数据集
数据集概览
该数据集包含 1,494,503 条合成表现性语音片段(DramaBox edge-case 语料库的 reward-Top-3 筛选结果),并附带四种类型的标注:CrisperWhisper 格式的转写文本(含修正后的声音爆发标注)、两种粒度的原始语音评分、程序化生成的 <GENERAL> + <SCRIPT> 字幕,以及逐字节一致的源音频。
数据规模与格式
- 总大小:802 GB(其中音频 796 GiB)
- 音频:48 kHz 单声道 MP3,160 kbps,总时长 11,840 小时,平均片段长度 28.5 秒
- 分片结构:128 个分片,五个数据家族(audio、transcripts、scores、bursts、captions)通过
id字段("{group_key}.s{seed}")对齐,分片间无需全局索引。
数据家族(Configurations)
1. transcripts(转写)
- 包含修正后的 CrisperWhisper 转写,声音爆发以
[Class Name]形式呈现 - 提供词级时间戳(
words字段包含 token、起止时间、是否为爆发、句子索引) - 爆发标注使用 v2 分类器的类别名称,保留原始时间戳
2. scores(评分)
- 全局评分:57 维 VoiceNet 回归值(0-6)、40 种 Empathic-Insight 情感、4 项质量评分、真实性(0-6)、声音爆发混合度(0-10)、性别门控值
- 句子级评分:每个句子(≥8 词)独立评分,共 6,284,328 个句子中 4,588,699 个(73.0%)被评分
- 评分是一级产物,字幕生成仅依赖此数据,可在 CPU 上几分钟内重新生成
3. bursts(声音爆发)
- 包含所有原始声音爆发片段(包括被丢弃的),共 5,401,483 个
- 字段包括:原始 CrisperWhisper 标签、v2 分类器 top-1 类别及概率、无爆发概率、top-5 结果、保留/丢弃原因、所属句子索引
- 丢弃原因包括:时长不足 200ms(62.0%)、无爆发判定(0.05%)、时间戳异常(0%)
4. captions(字幕)
- 程序化生成的
<GENERAL>+<SCRIPT>双段式字幕 - 句子包含
(圆括号)中的表达提示、声音爆发类别名,以及[方括号]中的停顿标记(阈值 0.35 秒) - 元数据记录字幕生成的可复现信息(基线文件哈希、生成器提交版本等)
构建流程
- 时长筛选:丢弃所有短于 200ms 的爆发片段
- 重新验证:使用
laion/voiceclap-commercial嵌入 +laion/vocal-burst-detector-v2分类,5 个折叠类别在 softmax 前被掩码,p(no_burst) ≥ 0.5的片段被否决 - 重新评分:使用
laion/Empathic-Insight-Voice-Plus对每个话语和 ≥8 词的句子评分 - 字幕生成:使用
LAION-AI/procedural-voice-captions的 in-domain 基线统计和可靠性权重
关键统计
| 指标 | 数值 |
|---|---|
| 保留爆发片段 | 2,053,108(占输入片段的 38.0%) |
| 重新验证片段 | 2,054,127 |
| 被否决片段(p(no_burst) ≥ 0.5) | 1,019(0.05%) |
| 输入片段中位数时长 | 0.16 秒(低于 200ms 筛选阈值) |
保留爆发片段的类别分布(前 3 类占 72.5%):Low Mumble(26.2%)、Ahem(24.9%)、Contented Sigh(21.4%)
模型信息
| 角色 | 模型 |
|---|---|
| 转写、时间戳、爆发检测(上游,未重跑) | CrisperWhisper-large-v2 |
| 爆发分类器 | laion/vocal-burst-detector-v2 |
| 嵌入器 | laion/voiceclap-commercial |
| 57 维语音维度 | laion/voicenet-dimension-predictors-commercial |
| 真实性评分 | laion/voiceclap-commercial-genuineness |
| 爆发混合度 | laion/voiceclap-commercial-vocalburst-blend |
| 40 情感 + 4 质量 + 性别门控 | laion/Empathic-Insight-Voice-Plus |
| 字幕生成器 | LAION-AI/procedural-voice-captions@4064baf10704 |
已知局限性
- 爆发时间戳来自 ASR 模型,未经人工验证,边界误差 100ms 不可见
- 爆发类别标签是分类器的 top-1,该分类器在其自身验证集上 argmax 准确率仅 58.1%,约五分之二的标签在类别级别是错误的
- 类别分布高度集中:82 个类别中仅 56 个被预测到,前三类覆盖 72.5% 的保留爆发
- CrisperWhisper 粗标签与 v2 细类别的一致性较低(可映射标签仅 24.9%),尤其是
yawn(0.2%)、sniff(0.6%)、cough(1.8%)等类别,这种不一致可能源于模型差异而非真实错误
使用建议
- ASR 训练:音频有意制造了理解难度,转写和修正后的爆发标签使其具有训练价值
- 音频加载:需使用
tarfile流式加载(提供了 Python 代码示例),避免使用webdataset库的默认 key 分割逻辑 - 字幕再生成:可仅通过 CPU 运行
derive_captions.py,无需音频和模型下载,支持更换基线和模板 - 文本增强:使用
augment.py进行表面模板、同义词轮换、维度洗牌等增强,实现"评分一次、字幕多次"