
遇见数据集

YuvrajSingh9886/jetson-non-reasoning-benchmark-25w

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

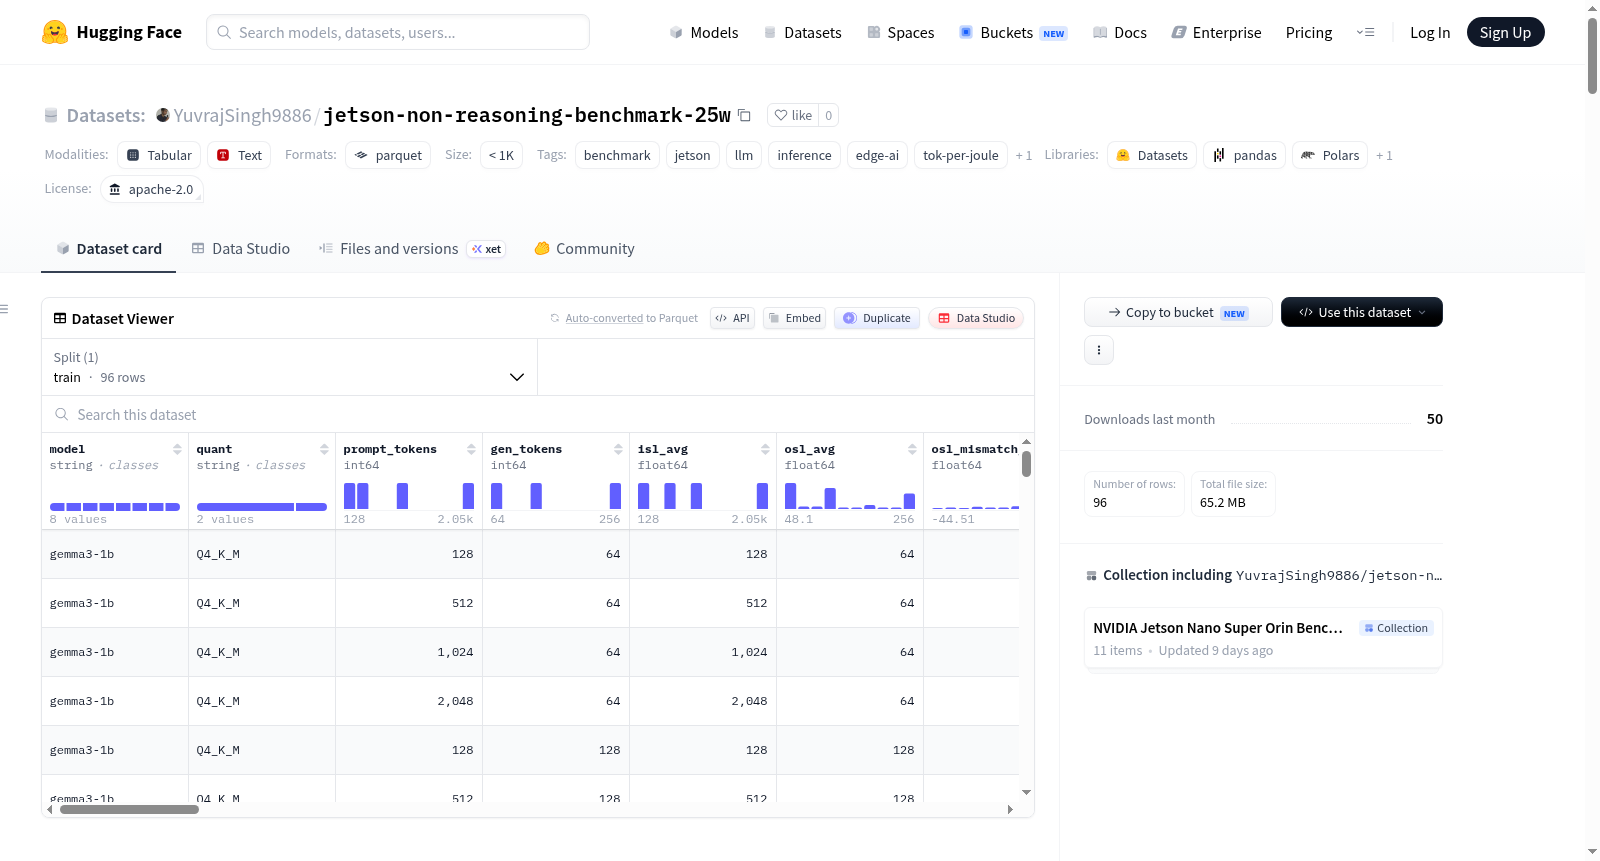
这是一个针对Jetson Orin Nano 8GB设备的Tiny LLM基准测试数据集,用于评估小规模语言模型在边缘AI场景下的推理性能。数据集包含多种模型(如gemma3-1b、lfm2.5-1.2b、qwen2.5-0.5b等)在不同量化配置(如Q4_K_M、Q8_0)下的性能指标,测试参数包括输入token长度(如128、512、1024、2048)和生成token长度(如64、128、256)。性能指标包括时间到首次token(TTFT)、token到token延迟(T2T)、吞吐量(Tok/s)、功率消耗(W)以及能效(Tok/J)。数据集基于llama.cpp CUDA后端运行,旨在为边缘设备上的LLM推理提供基准参考。

This is a Tiny LLM benchmark dataset for Jetson Orin Nano 8GB devices, designed to evaluate the inference performance of small-scale language models in edge AI scenarios. The dataset includes performance metrics for various models (e.g., gemma3-1b, lfm2.5-1.2b, qwen2.5-0.5b) under different quantization configurations (e.g., Q4_K_M, Q8_0), with test parameters covering input token lengths (e.g., 128, 512, 1024, 2048) and generation token lengths (e.g., 64, 128, 256). Performance metrics include time to first token (TTFT), token-to-token latency (T2T), throughput (Tok/s), power consumption (W), and energy efficiency (Tok/J). The dataset is based on the llama.cpp CUDA backend and aims to provide benchmark references for LLM inference on edge devices.
提供机构:
YuvrajSingh9886
搜集汇总
数据集介绍
YuvrajSingh9886/jetson-non-reasoning-benchmark-25w 数据集图片
构建方式
本数据集旨在系统性地评估在25瓦功耗限制下,边缘AI设备上小型语言模型的推理性能。构建过程中,研究人员采用llama.cpp作为后端,并启用CUDA加速(-ngl 99),在NVIDIA Jetson Orin Nano Super设备上,以单一并发请求进行测试。通过系统性地扫描输入提示长度(128、512、1024、2048个token)与生成长度(64、128、256个token)的组合,对包括gemma3-1b、lfm2.5-1.2b、llama3.2-1b、qwen2.5-0.5b及qwen3-0.6b在内的多种模型及其量化版本(如Q4_K_M、Q8_0)进行了详尽的基准测试。每个测试用例均记录了完整的性能指标,如首词延迟、令牌间延迟、端到端吞吐量及功耗,并计算了每焦耳能量所能生成的令牌数(Tok/J),从而构建了一个全面且标准化的边缘AI推理性能评估框架。
特点
该数据集的突出特点在于其聚焦于低功耗边缘设备(25瓦)这一实际应用场景,提供了极具实用价值的性能基准。它不仅涵盖了多种主流的轻量级语言模型及其量化版本,还系统地考虑了不同输入和输出长度对性能的影响。报告中包含了从平均时延到百分位时延(p50、p90、p99)的详尽延迟分布,尤为珍贵的是记录了CPU+GPU+CV轨道的实际平均功耗,并以此计算出能量效率指标(Tok/J),使得不同模型和量化策略的能效对比成为可能。此外,数据集明确标注了因内存溢出(OOM)而失败的模型,保证了数据的完整性和诚实性。
使用方法
本数据集的使用方式极为直观,其核心呈现为一张结构清晰的基准测试结果表格。用户可直接依据模型名称、量化类型、输入或输出长度等字段,筛选并对比不同模型在特定条件下的性能表现。关键在于关注“Tok/J”这一综合性能指标,它直接反映了模型在给定功耗下的能效,是衡量边缘AI部署合适性的首要参考。同时,结合“ITL avg”和“TTFT avg”可评估模型的响应流畅度与首词响应速度,而“E2E tok/s avg”则反映了端到端的文本生成吞吐量。开发者可根据目标应用对时延、吞吐量或能效的侧重,在表格中快速定位最适配的模型与量化方案。
背景与挑战
背景概述
在边缘人工智能的快速发展浪潮中,Jetson平台凭借其低功耗与高性能的融合优势,成为部署端侧大语言模型(LLM)的理想计算载体。该数据集由研究人员YuvrajSingh9886于2026年创建,聚焦于Jetson Orin Nano Super 8GB设备在25瓦功耗模式下的非推理场景性能基准测试。其核心研究问题在于量化小参数规模语言模型在资源受限环境中的实际运行效率,通过记录不同提示长度与生成长度下的延迟、吞吐量及能效比(Tok/J),为边缘AI应用提供关键的硬件-算法协同优化依据。该数据集填补了现有基准测试对功耗受限场景覆盖不足的空白,对推动轻量化模型在嵌入式设备上的部署具有显著的实践指导价值。
当前挑战
该数据集所解决的领域问题主要在于边缘设备上大语言模型推理的能效瓶颈,即如何在有限功耗预算(如25瓦)下最大化模型吞吐量并最小化响应延迟,传统云端基准测试方法无法直接适用于此类资源高度受限的环境。构建过程中面临多重挑战:首先,需协调不同模型(如gemma3-1b、lfm2.5-350m等)在统一量化标准(Q4_K_M)与推理框架(llama.cpp CUDA)下的兼容性,部分模型(如gemma3-4b)因服务器启动失败而被跳过;其次,需精细控制实验变量,包括提示长度(128-2048 token)与生成长度(64-256 token)的全组合扫描,并准确测量功耗数据;此外,需处理因内存溢出(OOM)导致的测试中断,以“—”标记异常,确保基准结果的真实性与完整性。
常用场景
经典使用场景
该数据集为在边缘计算设备NVIDIA Jetson Orin Nano Super上运行的非推理型小型语言模型(如Gemma、Llama、Qwen等)提供了详尽的性能基准测试。经典使用场景涵盖不同提示长度(128至2048 token)与生成长度(64至256 token)组合下的延迟、吞吐量及能效评估,通过记录TTFT、ITL、T2T、Tok/s及关键指标Tok/J(每焦耳生成token数),研究者可系统比较量化策略(如Q4_K_M、Q8_0)对模型在低功耗模式(25W)下推理效率的影响。
衍生相关工作
该数据集衍生了若干经典工作方向:一是基于其细粒度延迟分布特征,研究者开发了自适应提示分块算法以最小化预填充阶段能耗;二是Tok/J排行榜催生了针对边缘设备的能效感知模型剪枝与知识蒸馏技术;三是OSL不匹配率分析启发了动态生成长度控制机制,使模型可在电量警告时主动压缩输出。此外,数据集中的OOM失败模式被用于指导Jetson设备的内存调度策略优化。
数据集最近研究
最新研究方向
面向边缘AI设备的大语言模型推理能效基准评测,聚焦于Jetson Orin Nano等低功耗平台在非推理任务场景下的令牌级性能与能效比(Tok/J)分析,探索llama.cpp后端在不同提示长度和生成长度配置下的延迟、吞吐量与功耗表现,为边缘侧LLM部署提供量化参考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

