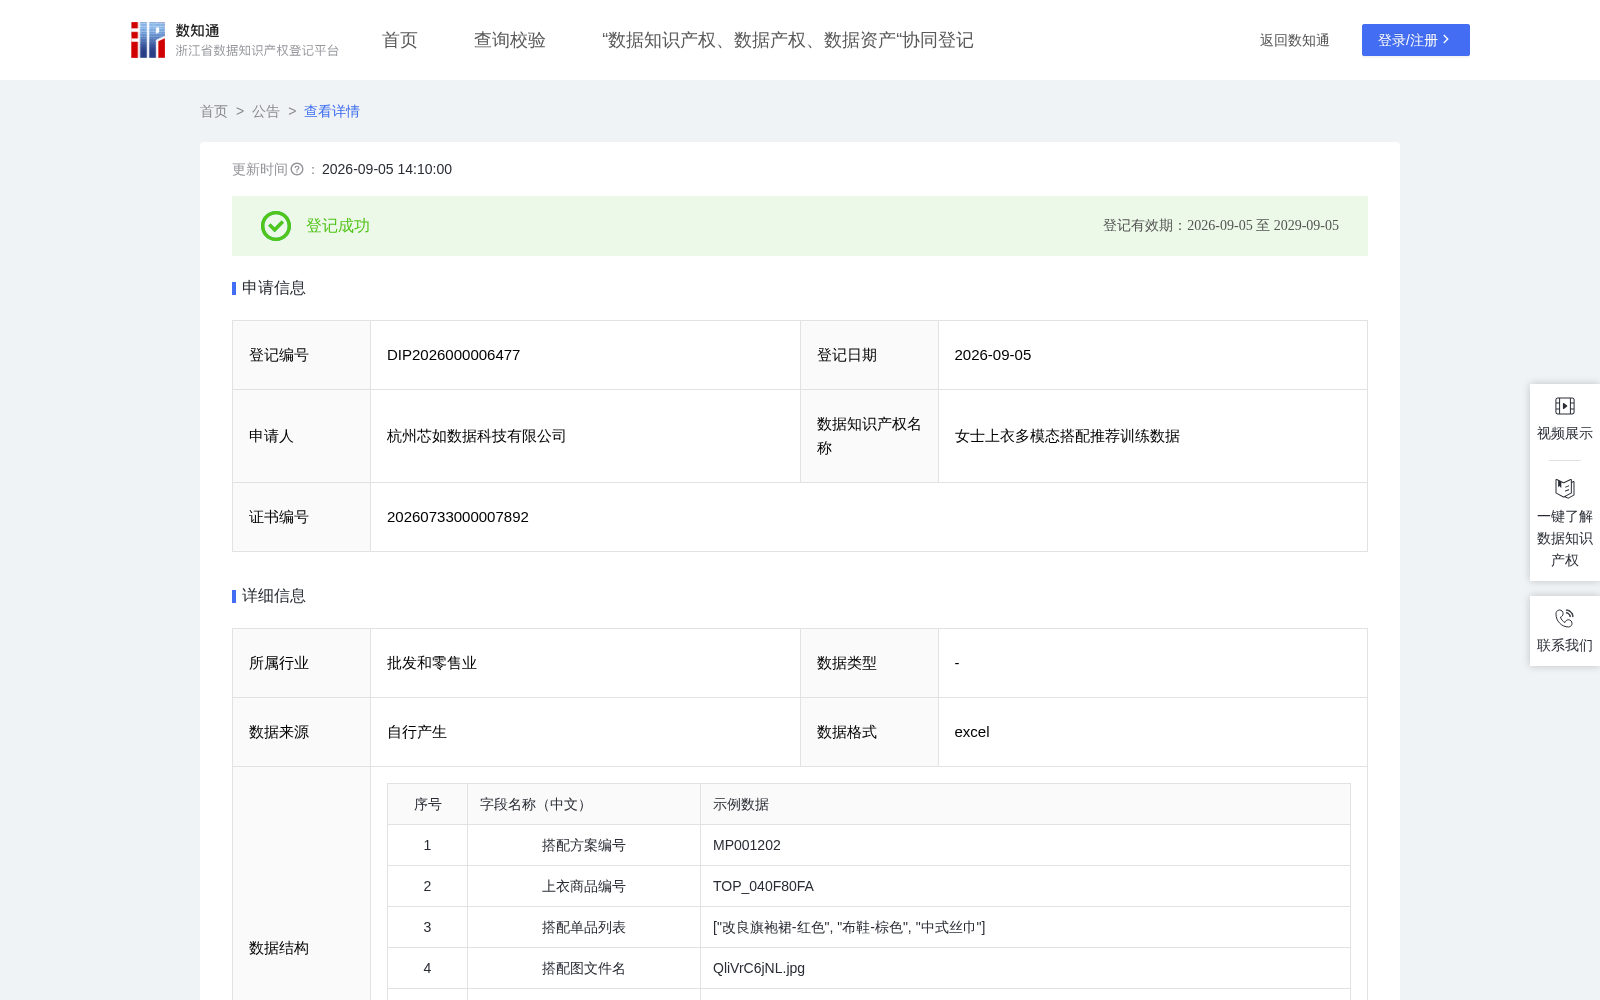
女士上衣多模态搭配推荐训练数据
收藏资源简介:
本数据面向女士上衣电商穿搭搭配方案的智能推荐需求,构建可用于训练多模态搭配推荐模型的标注数据集,将上衣商品与搭配单品列表、搭配展示图片、风格标签等多模态信息关联,使模型能够学习上衣与下装、鞋包等单品之间的搭配关系,覆盖简约通勤都市、法式浪漫优雅、韩系清新学院、甜美少女减龄、国潮新中式传统、复古文艺慵懒、轻熟知性职场、度假休闲海岛、温柔淑女气质、街头潮流酷感共10种风格标签组合,并通过反馈标签(正样本/负样本)标注搭配方案的实际效果,按训练集、测试集、验证集进行数据集划分。可用于穿搭搭配方案智能推荐与搭配效果预测等场景,解决搭配推荐依赖人工经验选品、缺乏基于多模态信息的搭配关系量化建模的问题,为服装行业企业及合作方提供高质量的多模态搭配推荐训练数据支撑。一、加工前的数据说明:原始数据来源于企业自有电商平台的商品搭配方案记录及对应的搭配展示图片,包括上衣商品信息、搭配单品组合、搭配效果图及消费者反馈情况。 二、处理规则: 1.数据采集与清洗:采集企业自有电商平台的商品搭配方案记录及搭配展示图片,进行去重与异常值剔除等清洗处理,剔除信息不完整与重复的搭配方案。 2.商品与图片信息脱敏:对上衣商品信息进行脱敏处理,以无规则编码化的商品编号替代原始商品ID;对搭配展示图片文件名进行无规则编码化处理,保障不可逆向还原原始商品与店铺信息。对每组搭配方案生成唯一搭配方案编号。 3.搭配单品列表结构化:将每组搭配方案中的搭配单品信息整理为JSON数组格式,每件单品以"品类-颜色"结构记录,每组包含2至3件单品。 4.风格标签标注:根据每组搭配方案的整体视觉风格,从预定义风格词库中选取多个关键词组合为风格标签,共10种风格标签组合。 5.反馈标签标注:根据搭配方案的消费者反馈情况,标注反馈标签,分为正样本、负样本共2类。 6.数据集划分:按机器学习标准流程,将数据集划分为训练集、测试集、验证集共3类。 7.记录编码化处理:对每条记录生成无规则编码化的唯一标识,保障数据记录的唯一性与可追溯性。 三、数据内容描述:最终形成结构化的女士上衣多模态搭配推荐训练数据集合,字段如下:1)搭配方案编号:每组搭配方案的唯一顺序编号;2)上衣商品编号:经脱敏处理的上衣商品匿名编码;3)搭配单品列表:以JSON数组格式记录的搭配单品信息,每件单品以"品类-颜色"结构表示,每组包含2至3件单品;4)搭配图文件名:经无规则编码化处理的搭配展示图片匿名标识;5)风格标签:描述搭配方案整体风格特征的多标签组合(以逗号分隔),由多个关键词组合,共10种,分别为简约,通勤,都市;法式,浪漫,优雅;韩系,清新,学院;甜美,少女,减龄;国潮,新中式,传统;复古,文艺,慵懒;轻熟,知性,职场;度假,休闲,海岛;温柔,淑女,气质;街头,潮流,酷感;6)反馈标签:根据消费者实际反馈标注的搭配效果类别,分为正样本、负样本共2类;7)数据集划分:分为训练集、测试集、验证集共3类;8)记录唯一标识:每条数据记录的唯一编码;9)数据生成时间:该条记录的生成日期。该数据集为多维度标注的女士上衣多模态搭配推荐训练数据库,可用于搭配推荐模型的训练与评估。