
mrabhishekkumarray/race
收藏官方服务:
资源简介:
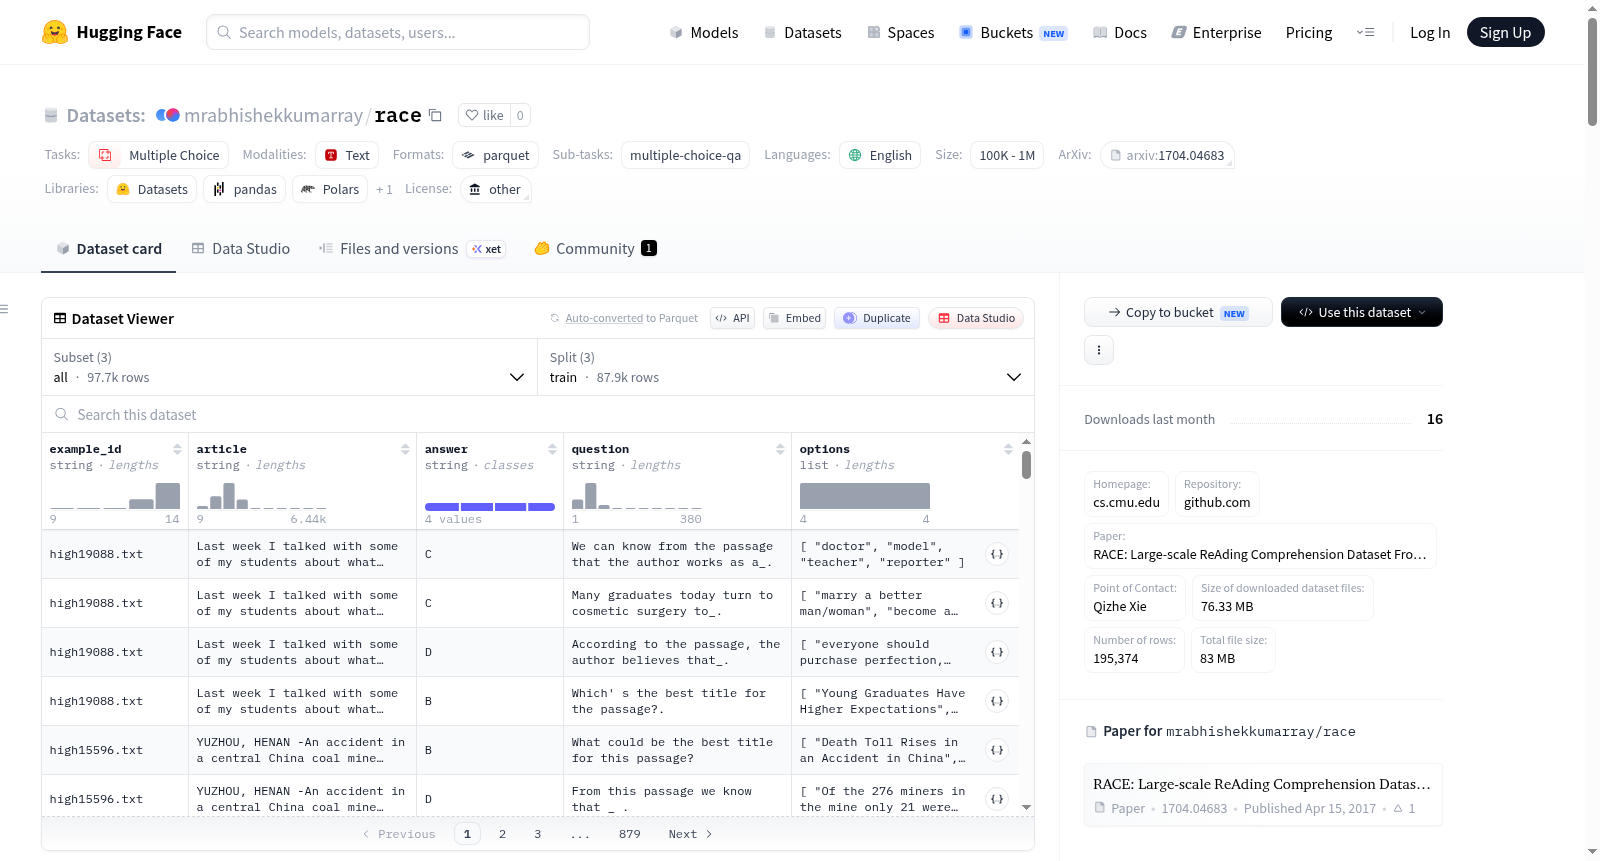
RACE是一个大规模阅读理解数据集,包含超过28,000篇文章和近100,000个问题。该数据集收集自中国的英语考试,专为初中和高中学生设计,可用于机器理解任务的训练和测试。
RACE is a large-scale reading comprehension dataset with more than 28,000 passages and nearly 100,000 questions. The dataset is collected from English examinations in China, which are designed for middle school and high school students. The dataset can be served as the training and test sets for machine comprehension.
提供机构:
mrabhishekkumarray搜集汇总
数据集介绍
构建方式
RACE数据集源自中国中学与高中英语考试的阅读理解题目,由专家精心编制而成。其构建过程从海量真实考试文本中筛选出涵盖多元主题的篇章,并针对每篇文章设计多项选择题,确保问题与选项的逻辑严密性。数据经由专业教育工作者审核,以保障与考试标准的一致性,最终形成包含近10万道题目的庞大规模语料库。
特点
该数据集的核心特色在于其难度层次与真实场景的紧密关联。按教育阶段划分为‘middle’(初中)与‘high’(高中)两个子集,同时提供整合版‘all’,充分体现从基础到进阶的认知梯度。每项样本包含文章、问题、四个候选选项及标准答案,结构简洁统一。数据规模上,训练集达87,866例,验证与测试集分别约4,887与4,934例,为模型评估提供了充足且均衡的样本空间。
使用方法
使用RACE数据集时,可通过HuggingFace的datasets库直接加载,支持按配置名(如‘all’、‘high’或‘middle’)选择子集。数据以字典形式呈现,字段包括‘example_id’(唯一标识)、‘article’(文本)、‘question’(问题)、‘options’(选项列表)及‘answer’(正确答案)。适用于微调预训练语言模型以完成多项选择阅读理解任务,典型应用包括在BERT、RoBERTa等架构上进行训练与测试。
背景与挑战
背景概述
RACE数据集由卡内基梅隆大学的Guokun Lai、Qizhe Xie等人于2017年创建,旨在推进机器阅读理解能力的研究。该数据集源自中国中学生英语考试,包含超过2.8万篇阅读文章与近10万道选择题,覆盖初中与高中两个难度级别。作为大规模、高质量的机器阅读理解基准,RACE在自然语言处理领域产生了深远影响,促使研究者探索模型在复杂推理、细节捕捉与篇章理解方面的表现。相比先前数据集,RACE的问题设计更具挑战性,要求模型不仅提取事实信息,还需进行多步推理与逻辑判断,从而有效推动了问答系统与文本理解技术的发展。
当前挑战
RACE数据集所针对的核心领域挑战在于提升机器在复杂阅读理解中的推理能力。传统数据集多基于简单事实查询,而RACE的问题涉及代词指代、因果推断、情感分析等多维认知任务,对模型的语言理解与常识推理提出更高要求。构建过程中,团队面临自动收集公开考试材料的合法性与质量筛选难题,需确保文本多样性、问题自然性及选项干扰强度均衡。此外,标注数据需依托专家审核以避免歧义,在庞大规模下维持一致性亦构成挑战。这些困难共同塑造了RACE作为高难度基准的独特定位。
常用场景
经典使用场景
RACE数据集作为大规模机器阅读理解领域的标杆性资源,其核心使用场景聚焦于评估和训练模型在复杂推理任务上的表现。该数据集从中国中学生英语考试中采集,涵盖超过28000篇文本和近10万道选择题,每道题目围绕一篇短文设置四个选项,要求模型在理解全文语境的基础上精准选择正确答案。这种设计不仅考察了模型对表面信息的检索能力,更强调深层语义理解、逻辑推断以及跨句信息整合等高级认知技能,为自然语言处理领域提供了一个兼具挑战性与代表性的多选阅读理解基准。
解决学术问题
在RACE数据集问世之前,现有阅读理解基准如SQuAD和CNN/Daily Mail多依赖片段抽取或填空形式,难以全面反映模型在复杂推理和细节辨析上的真实能力。RACE通过引入大量需要多层次推理的问题——涵盖推断、归纳、对比及主旨把握等类型——有效弥补了这一缺憾,揭示了当时顶尖模型(如BiDAF、GA Reader)在应对此类任务时的显著局限性。这一数据集的发布不仅催生了对阅读推理机制的深入探讨,还推动了预训练语言模型(如BERT、RoBERTa)在结构化理解与长文本建模上的革新,其影响力深远地重塑了机器阅读能力的评估范式。
衍生相关工作
RACE数据集的诞生衍生了一系列具有里程碑意义的经典研究工作。其中,BERT模型在其论文中首次将RACE作为深度预训练后的微调评估基准,展示了其在复杂推理任务上远超先前方法的性能,从而验证了双向Transformer在阅读理解中的有效性。随后,RoBERTa、ALBERT和XLNet等模型均将RACE纳入核心评测,推动了预训练语言模型架构的持续演进。在方法论层面,DCMN+和HGN等模型专注于解决RACE中的多重推理挑战,提出了动态融合文档与选项信息的创新框架。此外,基于RACE的对抗样例生成研究也催生了可解释性分析的新方向,进一步深化了对模型决策边界的理解。
以上内容由遇见数据集搜集并总结生成


