
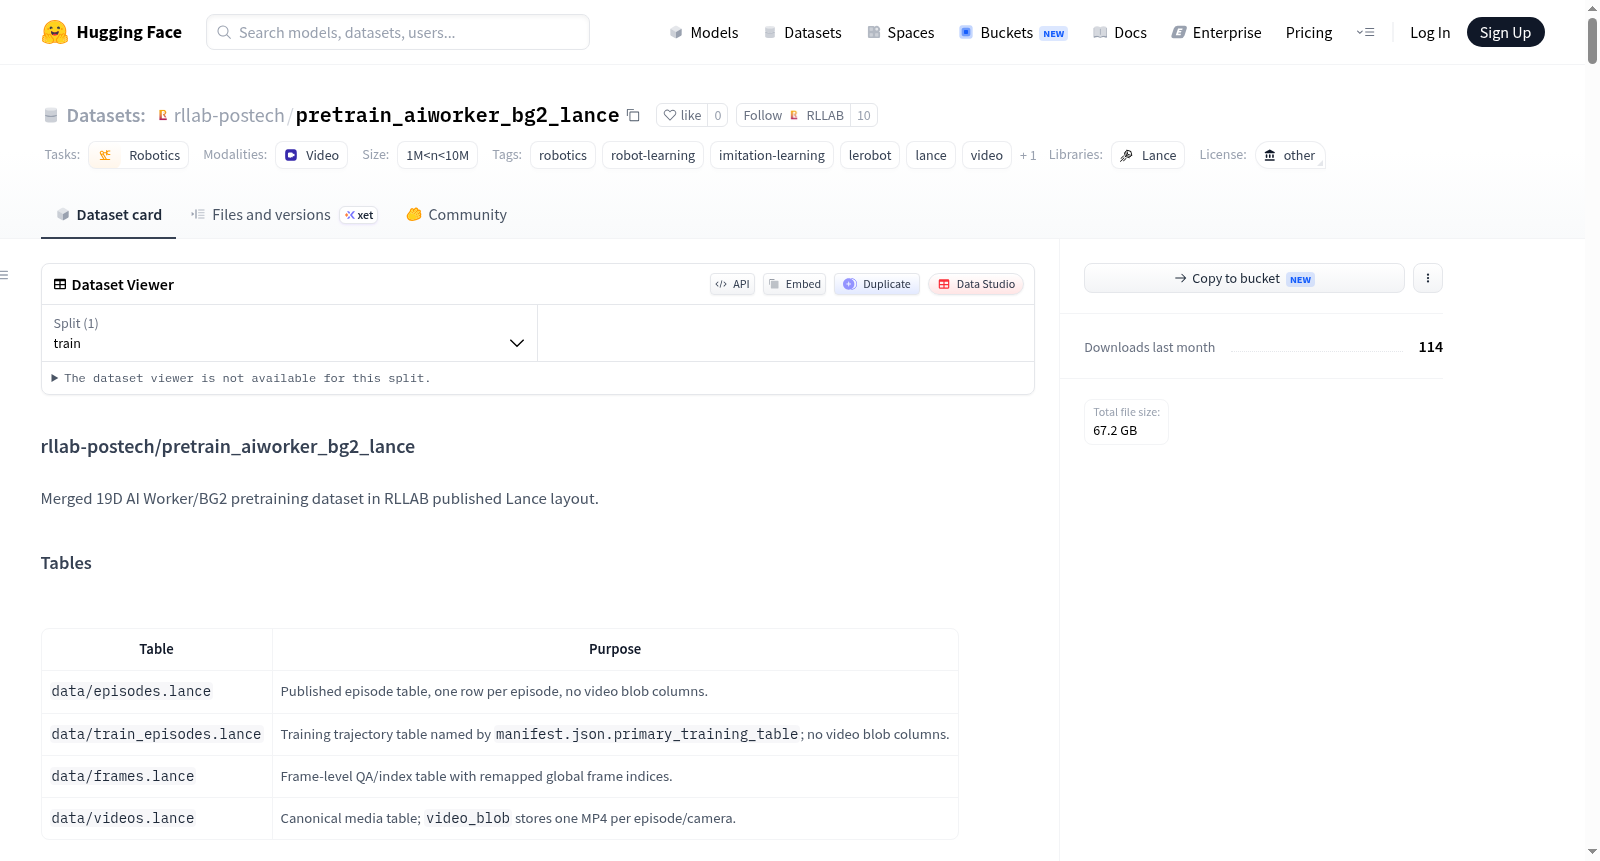
rllab-postech/pretrain_aiworker_bg2_lance
收藏官方服务:
资源简介:
这是一个合并的19维AI Worker/BG2预训练数据集,采用RLLAB发布的Lance布局格式。数据集包含294个源数据集,总计11497个episodes、1894356帧和37867个视频,动作和状态维度均为19,帧率包括10.0、15.0和30.0。数据以Lance格式存储,并经过质量过滤(如最小帧率10.0、必需摄像头键等),适用于机器人学习、模仿学习等任务。数据来源多样,涵盖多种机器人操作任务,如抓取、放置对象等。
Merged 19D AI Worker/BG2 pretraining dataset in RLLAB published Lance layout. It includes 294 source datasets, with 11497 episodes, 1894356 frames, and 37867 videos, featuring action/state dimensions of 19/19 and FPS values of 10.0, 15.0, 30.0. The dataset is stored in Lance format and has undergone quality filtering (e.g., min FPS 10.0, required camera keys) for robotics and imitation learning applications. Sources include various robot tasks such as grasping and placing objects.
提供机构:
rllab-postech搜集汇总
数据集介绍
构建方式
在机器人学习领域,大规模预训练数据集的构建对于提升策略的泛化能力至关重要。该数据集整合了来自308个源数据集的11,605条机器人操作轨迹,统一采用RLLAB发布的Lance格式进行组织。数据集包含四个核心表:episodes.lane存储轨迹元数据,train_episodes.lance提供训练用轨迹,frames.lance记录帧级索引与问答信息,videos.lance则保存每个视角对应的MP4视频。构建过程中,通过严格的质量过滤筛选掉低帧率、缺少必备相机视角及过短轨迹的样本,最终保留1,984,298帧和38,083段视频。每条Lane行携带完整的来源溯源信息,包括数据源仓库ID、机器人类型和预训练层级等字段,确保了数据来源的透明性。
使用方法
该数据集的使用围绕其四表结构和Lance格式展开。用户可通过data/train_episodes.lance直接加载训练轨迹,每行代表一个完整回合,不含视频二进制列,便于高效迭代。如需获取视觉观察,可借助data/videos.lane中的video_blob字段访问标准MP4视频,每个文件对应一个回合的单相机视角。data/frames.lance提供重映射的全局帧索引,支持帧级别的查询与随机访问。数据集兼容LeRobot等主流机器人学习框架,用户可通过框架API直接加载Lane数据集进行模仿学习训练。在实验中,建议依据源数据集和机器人类型字段进行针对性筛选,例如选取特定机器人类型或预训练层级的子集进行策略训练。
背景与挑战
背景概述
随着机器人学习领域的蓬勃发展,模仿学习对大规模、高质量、跨机器人类型的演示数据集的需求日益迫切。在此背景下,韩国POSTECH大学RLLAB研究团队于近期发布了pretrain_aiworker_bg2_lance数据集,旨在为机器人操控任务的预训练提供一个统一、标准化的数据资源。该数据集融合了来自308个不同来源的11,605个机器人演示片段,涵盖AI Worker、FFW BG2等多种机器人平台,总帧数近200万,并包含19维动作与状态空间信息。其核心研究问题聚焦于如何通过大规模异构演示数据的整合与质量控制,提升机器人基础模型在多样化操控任务上的泛化能力。该数据集采用Lance列式存储格式与统一的模式定义,为机器人学习社区提供了高效、可复用的数据支撑,有望推动模仿学习在工业与家庭场景中的实际应用。
当前挑战
该数据集主要面临两大挑战。其一,在领域问题层面,机器人操控任务本身面临复杂多变的物理环境、不同机器人构型间的运动学与动力学差异,以及从演示中高效学习精准、鲁棒策略的难题。该数据集虽然整合了多种机器人类型的演示,但如何从这些异构数据中学习到可迁移的通用表示,仍需解决跨平台的动作模式对齐与隐式约束建模问题。其二,在构建过程中,数据集面临严格的质量控制挑战:需从308个来源中过滤掉低帧率(低于10 FPS)、缺失关键相机(如左右手腕摄像机)以及片段过短(少于30帧)的样本,最终过滤了8,308个不合格片段,确保了约83万有效帧的质量。此外,大规模数据的高效存储、索引与视频帧的标准化拷贝,也对工程实现提出了较高要求。
常用场景
经典使用场景
在机器人学习领域,该数据集作为预训练数据集,广泛应用于模仿学习与行为克隆任务,用于训练基于视觉输入的机器人控制策略。研究者可充分利用其包含的19维动作与状态空间,结合左右腕部相机图像,学习从像素到动作的映射关系。典型场景包括利用1,984,298帧数据训练一个通用机器人操控基座模型,使其掌握抓取、放置、拧螺丝等精细操作技能,并可通过微调适应特定任务。
解决学术问题
该数据集专注于解决机器人行为学习中数据匮乏与泛化能力不足的核心难题。它通过整合308个异构子数据集,涵盖多种机器人类型(如ffw_bg2_rev4、aiworker)、不同FPS(10/15/30)和丰富任务类别,为构建大规模机器人预训练基准提供了结构化数据支撑。研究者可系统性地研究跨本体、跨任务的策略迁移机制,探究数据组成对模仿学习性能的影响,并验证多视角视觉输入对复杂操作任务鲁棒性的增益。
实际应用
在实际产业部署中,该数据集为智能机器人系统的快速落地提供了关键数据基础设施。制造商可基于预训练模型,利用少量特定场景数据微调,实现新产线上的自动分拣、装配等操作,大幅降低部署成本与数据采集周期。物流仓储场景中,机器人可通过学习数据集中多样化的抓取策略(如不同物体形状、材质的抓取方式),提升在非结构化环境下的操作成功率与自适应能力。
数据集最近研究
最新研究方向
在具身智能与机器人学习的前沿领域中,pretrain_aiworker_bg2_lance数据集作为融合了300余个源数据的预训练基准,正引领着模仿学习从单一任务向多任务泛化的研究浪潮。该数据集以Lance格式标准化了超过11,605个动作片段,涵盖高帧率(10-30 FPS)的双目视觉与19维动作/状态空间,并通过严格的质量过滤(剔除低帧率、缺失相机及短序列样本)构建了结构化的视频-轨迹联合索引表。当前,研究者正利用其提供的'provenance'元数据(如源机器人类型、预训练层级)探索跨机器人形态的迁移学习能力,同时结合分层视频存储与逐帧QA索引机制,为大规模机器人基础模型(如RT-2、Open X-Embodiment)的预训练提供高质量的基准数据,推动灵巧操作技能在真实工业场景中的可复现性与泛化边界。
以上内容由遇见数据集搜集并总结生成


