
遇见数据集

CooperBench/qwen9b-coop-mini-swe-agent

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

该数据集名为qwen9b-coop-mini-swe-agent,是一个用于研究多智能体协作编码轨迹的数据集。它通过在CooperData任务集上以协作模式运行CooperBench生成,使用Qwen/Qwen3.5-9B作为模型,mini_swe_agent_v2作为代理框架。数据集中,两个智能体并行运行,每个智能体负责一个功能,通过Redis消息传递和共享git远程进行协调。数据集包含368对任务,总令牌数约为2.19亿,用于分析协作缺陷,并与单独运行的版本进行对比。数据集文件包括索引CSV和原始运行树,涵盖代理会话、轨迹、评估结果等详细信息。

The dataset named qwen9b-coop-mini-swe-agent is a collection of two-agent cooperative coding trajectories generated by running CooperBench in coop mode on the CooperData task set, using Qwen/Qwen3.5-9B as the model and mini_swe_agent_v2 as the agent framework. It involves two agents running in parallel—one per feature—coordinating via Redis messaging and a shared git remote. The dataset contains 368 pairs, with a total of approximately 219 million tokens, and is used to study the cooperation deficit compared to solo runs. It includes files such as an index CSV and a raw run tree with agent sessions, trajectories, evaluation results, and more.
提供机构:
CooperBench
搜集汇总
数据集介绍
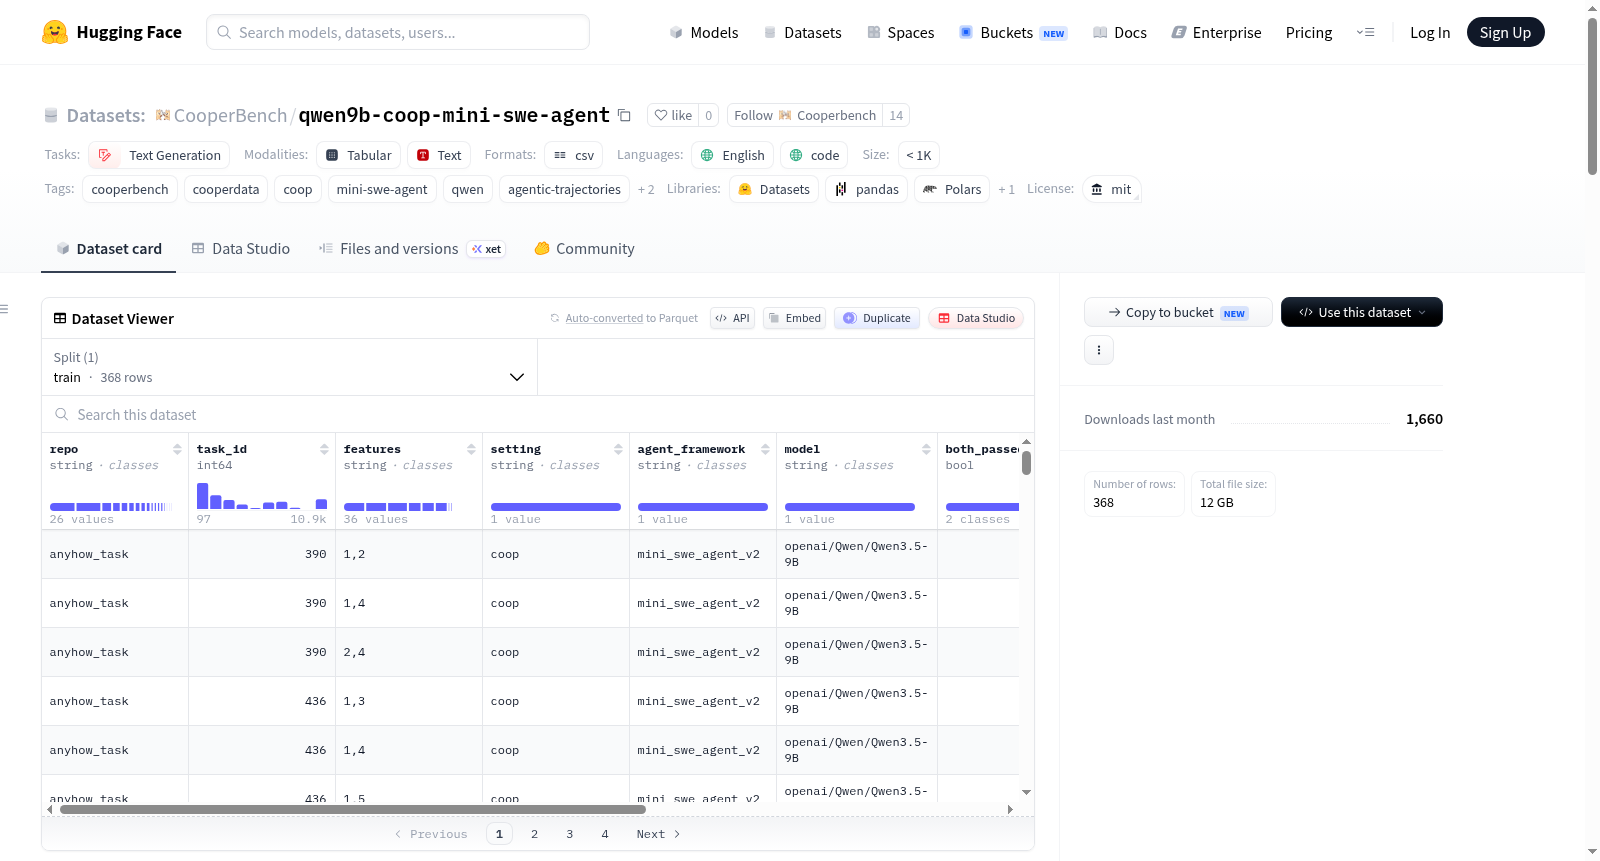
CooperBench/qwen9b-coop-mini-swe-agent 数据集图片
构建方式
该数据集源自CooperBench项目,在CooperData任务集上以协作模式运行生成。具体而言,采用Qwen/Qwen3.5-9B作为基础模型,利用mini_swe_agent_v2代理框架,在Modal H100实例上部署vLLM端点,设置32K上下文长度与fp8 KV缓存,并将代理步数上限从默认的100提升至250以避免长任务过早截断。每个任务对并行运行两个代理,分别负责一项特征开发,通过Redis消息传递与共享Git远程仓库实现协调,最终产出包含会话日志、补丁文件及评估结果的完整轨迹数据。
特点
数据集包含368个协作编码轨迹对,总计约2.19亿个token,覆盖26个跨语言代码仓库。核心亮点在于其双代理并行协作设计,每个轨迹对记录了两名代理在独立特征开发中的完整交互过程,包括测试通过状态、合并结果及详细的token消耗。协作模式下双特征通过率为5.2%,单特征通过率为18.3%,与对应的单代理版本形成对比,能够有效隔离协作缺陷。数据集的元数据列如pair_tokens、both_passed等为中期训练的分层采样提供了便利。
使用方法
数据可通过HuggingFace Datasets加载器读取index.csv文件,每行对应一个轨迹对,包含仓库、任务标识、特征名称、设置参数及元数据JSON字段。元数据中存储了各代理的状态、步数及特征级测试计数,而完整的原始轨迹文件则存放在coop/目录下,包括session.jsonl、traj.json及patch文件。用户可按pair_tokens进行token级采样,依据both_passed筛选成功案例,或结合agent_framework与model字段进行分层抽样,用于训练多智能体协作模型或研究协作行为模式。
背景与挑战
背景概述
qwen9b-coop-mini-swe-agent数据集由CooperBench团队于2026年创建,旨在探究多智能体协作在代码生成任务中的效能。研究基于Qwen3.5-9B模型与mini_swe_agent_v2智能体框架,在CooperData任务集上以双智能体并行模式运行,通过Redis消息队列和共享Git仓库实现协同。该数据集的核心贡献在于提供了与独立模式严格对照的协作轨迹数据,其中双特征通过率仅为5.2%,远低于单智能体的15.5%,揭示了多智能体协作中存在的显著效能鸿沟,为研究AI协作缺陷提供了关键基准。其影响力体现在为代码智能体领域的协作学习、多智能体系统优化以及中间训练策略提供了结构化数据支撑。
当前挑战
该数据集主要应对两大挑战。其一,在领域技术层面,多智能体协作在软件工程任务中面临协调低效问题——双智能体并行工作虽能并行处理特征,但合并与测试环节频繁出现冲突或遗漏,导致整体成功率较单智能体下降超过10个百分点,暴露出智能体间缺乏有效沟通与任务衔接机制的短板。其二,在数据构建过程中,vLLM的32K上下文窗口限制是主要瓶颈,尤其在处理如axios等任务的大量vitest输出时,输入超限导致模型频繁抛出ContextWindowExceededError,虽将智能体步数上限从100提升至250,仍有38%的任务对未能在限制内完成;此外,极少数任务因端点超时导致重试死循环,需人工干预标记错误,影响了数据纯净度与完整性。
常用场景
经典使用场景
在代码生成与软件工程研究领域,多智能体协作编程已成为应对复杂任务的关键范式。该数据集记录了基于Qwen3.5-9B模型的双智能体协同编码轨迹,每个智能体独立处理一个功能特性,通过Redis消息传递与共享git仓库实现异步协调。研究者可借此深入分析双智能体在并行编程中的协作模式、通信效率及任务分配策略,尤其适合作为多智能体强化学习与协作推理的训练数据。数据集中包含368个任务对的完整轨迹、补丁文件及对话记录,为构建和评估协作式代码生成系统提供了标准化的行为基准。
解决学术问题
该数据集的核心学术价值在于量化并揭示了多智能体协作中的“协作赤字”(cooperation deficit)现象。通过与同模型、同任务但采用单智能体模式的匹配数据集进行对比,研究者能够精确分离协作引入的性能损失,从而回答“为何并行化协作有时反而降低整体成功率”这一关键问题。数据集中记录的19/368双特性通过率与单智能体15.5%的对比数据,为分析智能体间的通信瓶颈、意图对齐失败及资源竞争提供了实证基础。这项工作填补了多智能体编程领域缺乏可控对比数据的空白,推动了对于分布式代码生成中协调机制的理论理解。
衍生相关工作
该数据集已衍生出一系列具有影响力的后续工作。首先是与其镜像匹配的单智能体数据集(solo版本),二者联合构成了评估协作增益的黄金标准,已用于CooperData报告中的系统性对比分析。其次,基于轨迹中的token使用统计和错误模式(如上下文窗口溢出与步骤限制截断),研究者开发了智能体动态记忆压缩策略和自适应步骤限制算法。此外,多所高校的研究团队已利用该数据训练专用评估指标,用于量化多智能体系统中的通信效率,并探索基于元学习的协作协议生成方法。这些工作共同构建了从数据到理论再到工程实践的完整研究链条。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

