YuvrajSingh9886/jetson-non-reasoning-benchmark-7w
收藏资源简介:
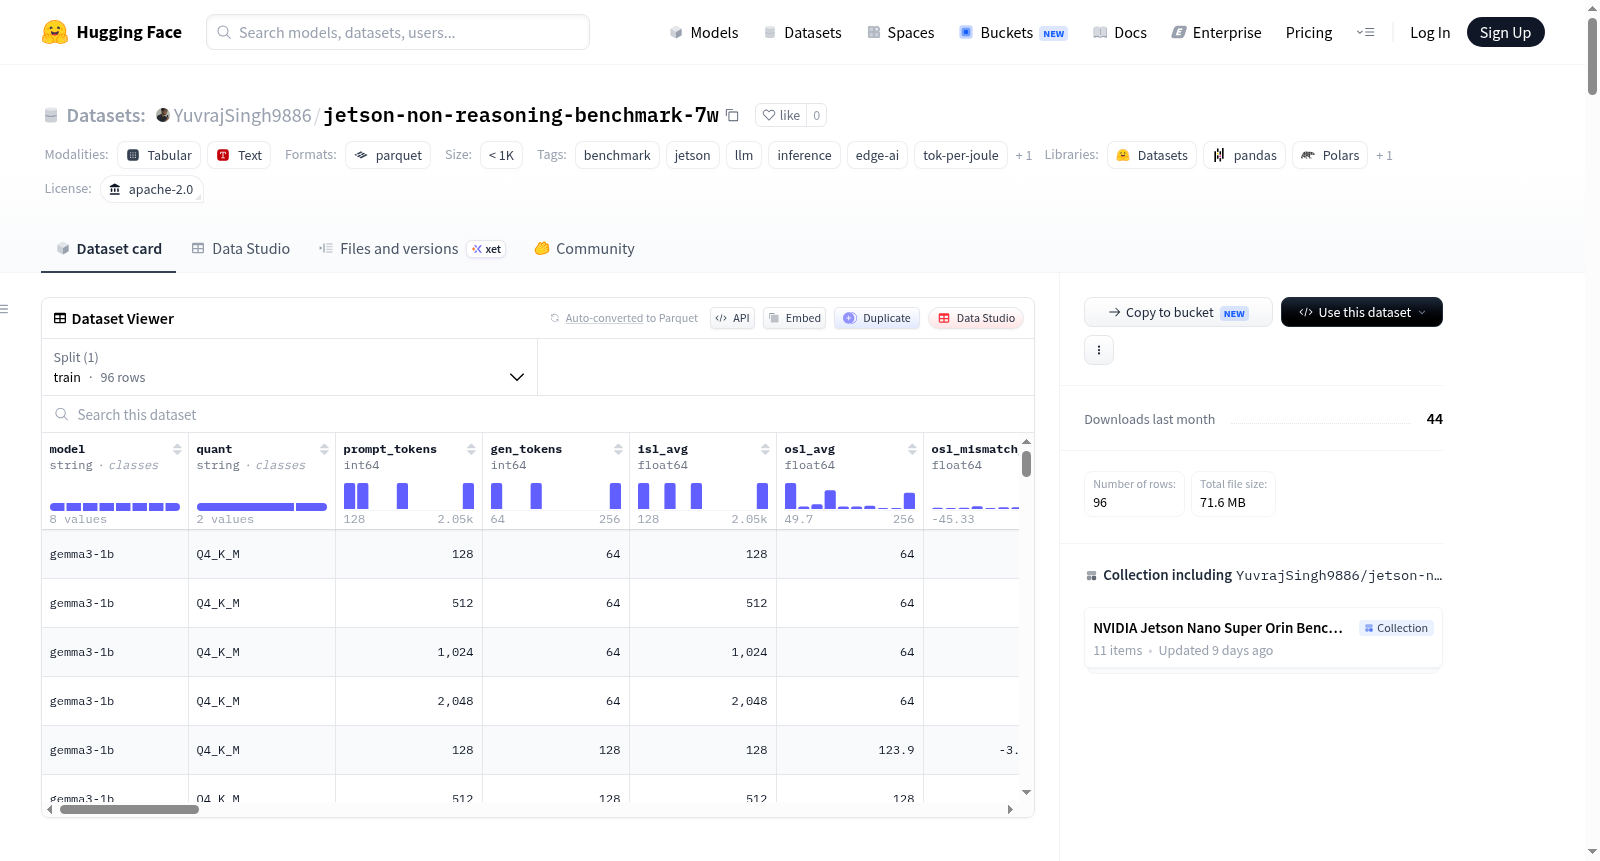
这是一个基准测试数据集,用于评估小型大型语言模型(LLM)在NVIDIA Jetson Orin Nano Super 8GB边缘AI设备上的推理性能,测试在7W功耗模式(nvpmodel模式3)下进行。数据集包含多个模型(如gemma3-1b、lfm2.5-1.2b、llama3.2-1b等)在不同量化设置(如Q4_K_M)下的性能指标,测试参数包括输入序列长度(128、512、1024、2048令牌)和生成序列长度(64、128、256令牌)。指标涵盖时间到第一个令牌(TTFT)、令牌到令牌延迟(T2T)、吞吐量(Tok/s)、请求延迟、功耗(W)以及每焦耳令牌数(Tok/J),旨在为边缘AI场景中的模型选择和优化提供参考。
许可证:Apache-2.0 标签: - 基准测试(benchmark) - Jetson - 大语言模型(LLM/Large Language Model) - 推理(inference) - 边缘人工智能(edge-ai) - 每焦耳Token数(tok-per-joule, tok/J) - llama.cpp 美观名称:"Jetson非推理基准测试 — 7W(nvpmodel模式3)" 配置: - 配置名称:default 数据文件: - 拆分:训练集(train) 路径:data/train-00000-of-00001.parquet # 小型大语言模型基准测试 — Jetson Orin Nano Super 8GB(7W / nvpmodel -m 3) **测试日期:** 2026年5月28日 18:03 **后端:** llama.cpp CUDA(`-ngl 99`) **并发数:** 1 **扫描参数:** 提示词长度取{128, 512, 1024, 2048} Token(tok),生成长度取{64, 128, 256} Token **数据集工件地址:** `https://huggingface.co/datasets/YuvrajSingh9886/jetson-non-reasoning-benchmark-7w` **备注:** 每焦耳Token数(tok/J)基于每次运行的aiperf JSON文件中的`start_time`/`end_time`计算得到。 ## 完整测试结果 > 功率说明:功率为每次aiperf运行窗口内VDD_CPU_GPU_CV的平均值,时间戳取自对应JSON文件。 | 模型 | 量化方式 | 输入序列长度(Input Sequence Length, ISL, tok) | 输出序列长度(Output Sequence Length, OSL, tok) | 输出序列长度偏差率(%) | 首令牌时间平均值(Time to First Token, TTFT, ms) | TTFT p50 | TTFT p90 | TTFT p99 | 令牌到令牌延迟平均值(Token to Token, T2T, ms) | T2T p50 | T2T p90 | T2T p99 | 迭代令牌延迟平均值(Iteration Token Latency, ITL, ms) | ITL p50 | ITL p90 | ITL p99 | 服务器吞吐(Tok/s) | 请求数每秒(Req/s) | 端到端Token每秒平均值 | E2E p50 | E2E p90 | E2E p99 | 请求延迟平均值(ms) | Req lat p50 | Req lat p90 | Req lat p99 | 预填充Token每秒平均值 | Prefill p50 | Prefill p90 | Prefill p99 | 功率(W) | **每焦耳Token数(Tok/J)** | |-------|:-----:|----------:|----------:|-----------------:|--------------:|---------:|---------:|---------:|-------------:|--------:|--------:|--------:|--------------:|--------:|--------:|--------:|---------------:|------:|--------------:|--------:|--------:|--------:|-----------------:|------------:|------------:|------------:|------------------:|------------:|------------:|------------:|----------:|----------:| (保留原表格数值内容) ## 各模型最佳每焦耳Token数 | 模型 | 量化方式 | 最佳每焦耳Token数 | 输入序列长度(tok) | 输出序列长度(tok) | Token每秒 | 功率(W) | |-------|:-----:|----------:|----------:|----------:|------:|----------:| ## 热性能总结(每次运行平均值) | 模型 | 平均功率(W) | 平均CPU温度(℃) | 平均GPU温度(℃) | 峰值结温(℃) | 是否节流 | |-------|-------------:|-------------:|-------------:|-------------:|:---------:| --- *由regen_report.py于2026年5月28日 18:03:24生成 — 每焦耳Token数基于每次运行的aiperf时间戳计算*