
遇见数据集

shaswatamitra/falcon-snort-rule-decoys

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

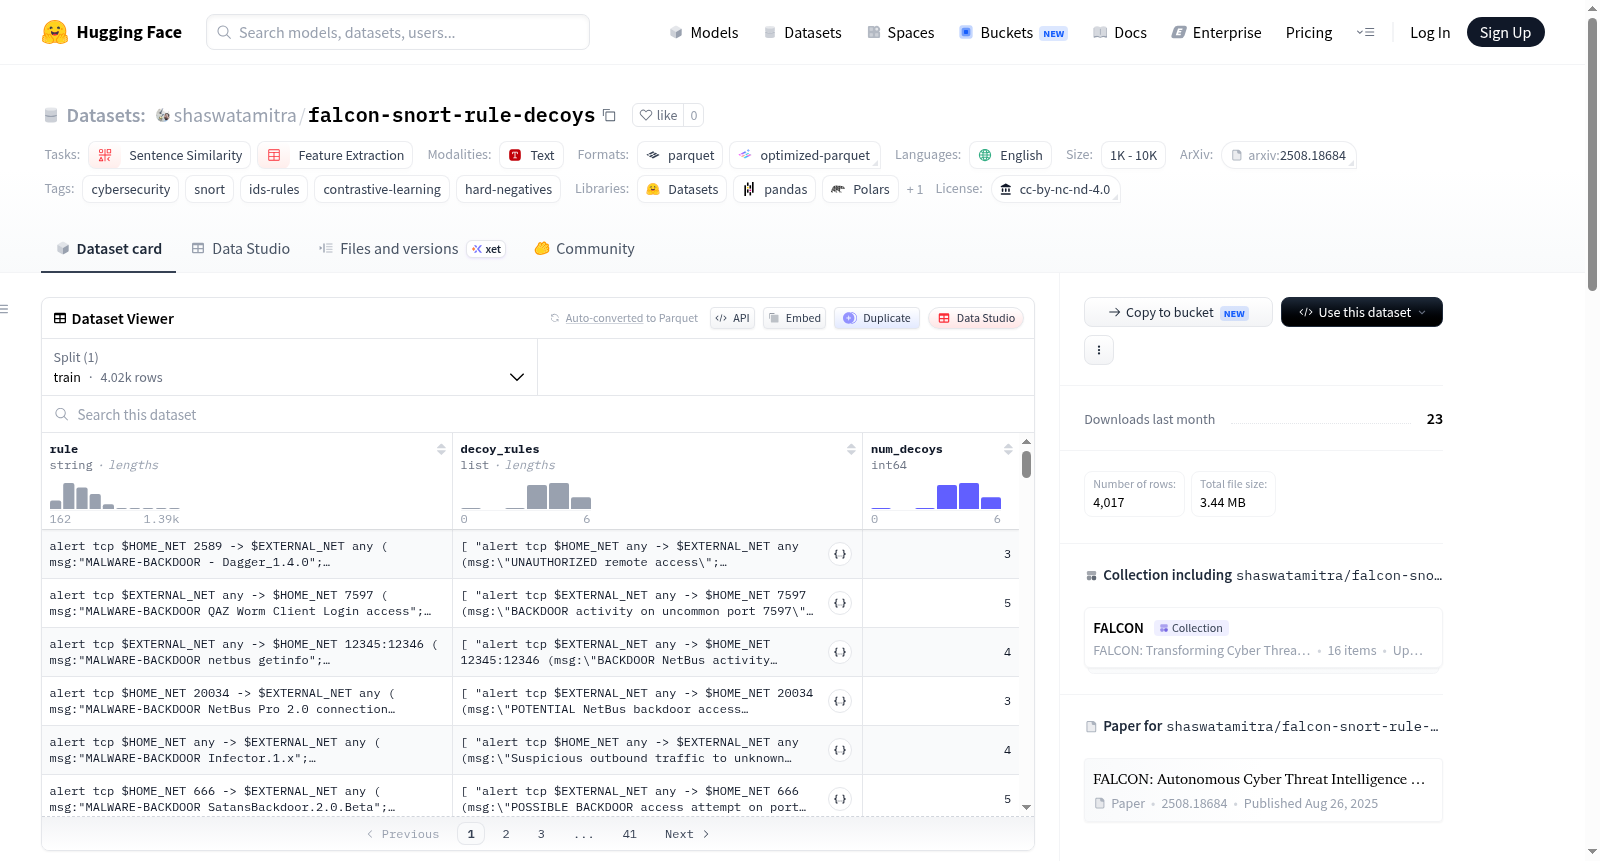
FALCON SNORT规则 ↔ 诱饵规则数据集是一个用于网络安全领域的数据集,专门针对SNORT入侵检测系统(IDS)规则。它包含真实SNORT IDS规则(作为锚点)与由大型语言模型(LLM)生成的相似规则(称为诱饵或已弃用规则)的配对。这些诱饵规则在表面层面(如语法结构、消息标记和整体形式)与真实规则相似,但检测逻辑不同,因此不能行为互换。数据集旨在作为对比句子编码器微调的硬负样本,用于增强模型在区分相似但非等价规则时的鲁棒性,同时也可作为检索鲁棒性基准,测试模型在给定网络威胁情报(CTI)时能否区分真实规则与其相似规则。数据规模包括4,017个锚点规则和总计15,217个诱饵规则(平均每个锚点3.79个,范围0-6个)。数据集适用于句子相似性、特征提取等任务,并支持对比学习和硬负样本挖掘。

The FALCON SNORT Rule ↔ Decoy-Rule Dataset is a cybersecurity dataset that pairs ground-truth SNORT IDS rules with LLM-generated look-alike rules (referred to as decoy or deprecated rules). These decoy rules are designed to be superficially similar to the anchor rules in terms of syntactic skeleton, message tokens, and overall structure, but differ in detection logic, making them behaviorally non-interchangeable. The dataset is intended to serve as hard negatives for contrastive sentence-encoder fine-tuning, enhancing model robustness in distinguishing similar yet non-equivalent rules, and as a robustness benchmark for retrieval tasks, evaluating whether a model can differentiate real rules from their look-alikes given corresponding Cyber Threat Intelligence (CTI). It contains 4,017 anchor rules and 15,217 total decoys (mean 3.79 per anchor, range 0-6), and is suitable for tasks such as sentence similarity and feature extraction, with applications in contrastive learning and hard-negative mining.
提供机构:
shaswatamitra
搜集汇总
数据集介绍
shaswatamitra/falcon-snort-rule-decoys 数据集图片
构建方式
该数据集由FALCON项目构建,依托LLM生成与真实SNORT IDS规则表面相似的诱饵规则(或称近似规则)。真实规则源自CTI↔Rule数据集相同的语料库,每个真实锚规则被输入至大语言模型,通过提示工程生成3至8条具有相似句法骨架、消息标记和整体结构,但检测逻辑截然不同的诱饵规则。这些诱饵规则旨在作为对比学习中的困难负样本,总计包含4,017条锚定规则与15,217条诱饵规则,平均每条锚定规则对应3.79个负样本。
特点
这一数据集的核心特点在于其精心设计的困难负样本集——诱饵规则在表层特征上与真实规则高度雷同,却缺乏可互换的检测行为,因此对基于语义的编码器构成严峻挑战。它专为对比学习场景下的句子编码器微调而设计,尤其适用于增强模型区分真实规则与其近似物的鲁棒性。同时,作为检索鲁棒性基准,它能评估模型在给定威胁情报文本条件下,能否准确甄别所属的真实规则而非外观相似的干扰项。
使用方法
数据集可通过Hugging Face Datasets库直接加载,调用load_dataset('shaswatamitra/falcon-snort-rule-decoys', split='train')即可获得训练集。每个样本包含原始规则字符串与一个包含若干诱饵规则的列表。用户可将此数据集与FALCON CTI↔Rule数据集配对,通过挖掘(威胁情报,真实规则,诱饵规则)三元组来执行三元组损失训练以强化编码器。此外,它也可直接作为对比学习训练中的批内负样本补充,或用于评估规则检索系统的抗干扰能力。
背景与挑战
背景概述
随着网络攻击手段的日益复杂,入侵检测系统(IDS)作为网络安全防御的关键组件,其规则库的准确性与鲁棒性面临严峻挑战。传统基于规则的IDS虽然能有效识别已知威胁,但面对不断演变的攻击模式,规则维护与更新成为一项繁琐任务。近年来,大语言模型(LLM)被探索用于自动化生成IDS规则,以提升响应效率。然而,LLM生成的规则可能存在表面相似但语义差异的问题,影响检测精度。为应对这一挑战,Shaswata Mitra、Azim Bazarov等研究人员于2025年提出了falcon-snort-rule-decoys数据集,旨在提供真实SNORT IDS规则与LLM生成的相似规则对,作为对比学习中的难负样本。该数据集源自FALCON项目,通过精心设计的生成策略构建了4017条锚规则与15217条诱饵规则,为评估和提升句子编码器在网络安全领域的语义区分能力提供了基础资源,对推动自动化威胁情报挖掘与IDS鲁棒性研究具有重要价值。
当前挑战
该数据集主要解决的核心挑战在于:首先,在网络安全领域,入侵检测规则与攻击描述文本之间的语义匹配极易受到表面相似性的干扰,传统模型难以区分功能本质不同但语法结构相似的规则,这成为提升IDS自动化生成与验证性能的关键瓶颈。其次,构建过程中面临生成高质量难负样本的难题——需要确保每条LLM生成的诱饵规则在语法骨架、标记词汇上高度模仿真实规则,却在检测逻辑上存在实质性差异,避免成为毫无难度的简单负样本或语义等价的正样本。此外,还需控制诱饵规则数量的合理分布(0-6条不等),保证数据集的多样性与平衡性,同时确保与配对数据集协同用于三元组损失训练时的兼容性。这些挑战的解决,直接关系到对比学习模型在规则-诱饵检索任务中的鲁棒性表现。
常用场景
经典使用场景
在网络安全与自然语言处理交叉领域,该数据集专为句子编码器的对比学习微调而设计。其核心价值在于提供真实Snort入侵检测规则与大型语言模型生成的拟态规则之间的配对数据,充当‘困难负样本’。研究者可利用此数据训练模型在语义空间中更好地区分真实规则与表面相似但逻辑迥异的虚假规则,从而提升编码器对安全领域文本的判别力。该场景通常与配套的威胁情报-规则数据集联合使用,构建三元组进行三重损失训练,以实现更精细的嵌入表示学习。
衍生相关工作
FALCON数据集衍生了一系列围绕安全文档表征与异常检测的经典工作。其中最直接的是配套的CTI-规则对齐数据集,两者共同构成了端到端的威胁情报到规则生成与校验流水线。后续研究者借鉴其困难负样本构造策略,拓展至防火墙策略、恶意域名黑名单等其他安全领域的文本对比学习任务。此外,该数据集的构建范式启发了基于大语言模型的对抗样本生成方法,催生了评估编码器鲁棒性的标准化基准测试集,为安全自然语言处理领域提供了可复现的评测框架。
数据集最近研究
最新研究方向
该数据集聚焦于网络安全领域入侵检测系统(IDS)中Snort规则的对抗性鲁棒性评估与语义表征学习。通过构建真实Snort规则与大语言模型生成的迷惑性“诱饵规则”的配对集合,为对比学习提供高质量硬负样本,推动规则编码器在区分语义相似但逻辑相异的规则方面的能力提升。结合关联的FALCON CTI-规则数据集,可挖掘三元组(威胁情报、真实规则、诱饵规则)进行三重损失训练,实现端到端的威胁情报驱动规则生成与验证。这一前沿研究方向直接回应了大语言模型在网络安全应用中面临的幻觉与误判风险,为构建可信自主威胁情报挖掘系统提供了关键基准测试与训练资源,对提升IDS规则生成的准确性与可解释性具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

