autoscientist-toolcaller-dataset
收藏资源简介:
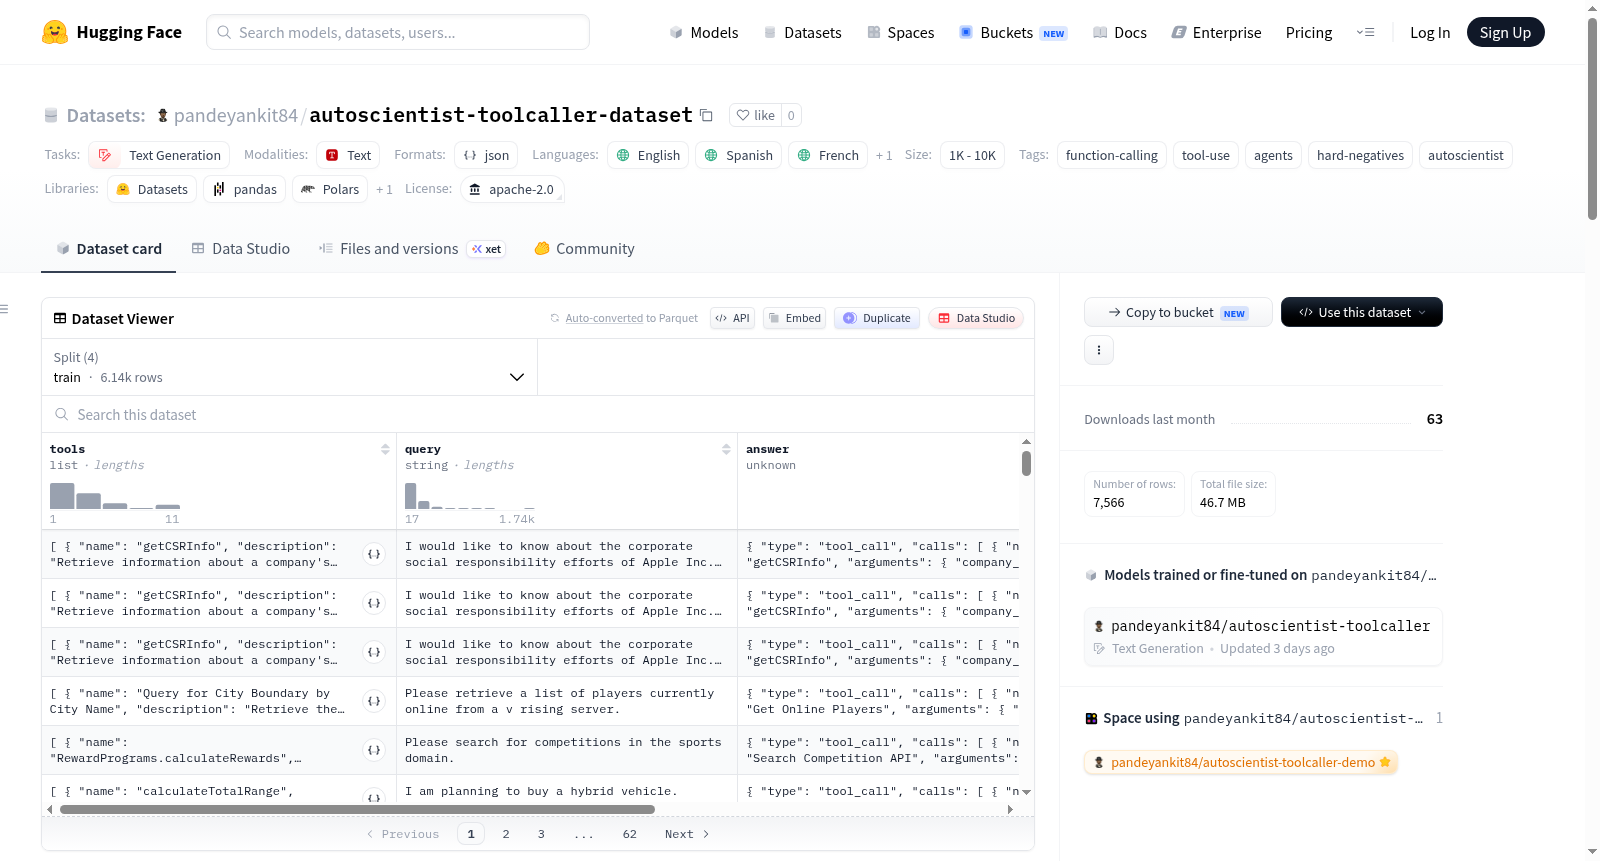
AutoScientist Tool-Calling 数据集是一个专门为Adaption AutoScientist Challenge策划的函数调用/工具使用数据集。其核心特点是包含了大量困难负样本和专注于模型可靠性的案例,在这些案例中,正确的行为并非简单的工具调用。数据集旨在用于监督微调(及偏好调优)那些必须可靠决定是否以及如何调用工具(包括安全地拒绝调用)的函数调用模型。数据集包含3,346个示例,划分为训练集、验证集、测试集以及一个专门的test_novel集(包含训练中从未出现过的工具,用于泛化测试)。每个示例采用规范的JSON格式,包含tools(工具列表,含名称、描述和参数)、query(用户查询)、answer(回答,类型为工具调用、拒绝或澄清,并包含具体调用内容和文本)和meta(元数据,标明示例来源和具体种类)字段。数据由多个切片构成:正样本来自ToolACE的真实工具调用示例(经过模式验证),以及一小部分来自确定性工具环境的执行验证示例;困难负样本包括应拒绝调用、应澄清参数缺失或歧义、应坚持调用(针对可满足但表述模糊的请求)以及应进行完整调用(处理部分并行请求)等多种场景;多轮对话涵盖参数缺失、函数缺失、长上下文以及已验证的多调用环境轨迹;模式漂移模拟工具模式在模型使用期间发生变更的场景,如新增必填参数、更改枚举类型或重命名字段,并要求模型做出正确响应。所有工具调用的答案在构建时都经过模式验证,确保零模式无效答案。数据集进行了严格的去重(MinHash + 语义)和去污染处理(检查与公开探针的重叠)。此外,还提供了一个平台增强变体,对提示和补全进行了改写以提升数据质量。数据来源方面,正样本源自并改编自Team-ACE/ToolACE数据集(Apache-2.0许可),所有困难负样本、多轮对话和模式漂移示例均为原创,基于真实工具模式通过模板合成。整个数据集在Apache-2.0许可下发布。当前版本仅限于英语,且合成示例的措辞基于模板,多样性不及完全自然的查询。
The AutoScientist Tool-Calling dataset is a function-calling/tool-use dataset specifically curated for the Adaption AutoScientist Challenge. Its core features include a large number of hard negative samples and cases focused on model reliability, where the correct behavior is not simply tool invocation. The dataset is intended for supervised fine-tuning (and preference tuning) of function-calling models that must reliably decide whether and how to call tools, including safely refusing calls. It contains 3,346 examples, divided into training, validation, test sets, and a dedicated test_novel set (containing tools never seen during training for generalization testing). Each example follows a standardized JSON format with fields: tools (a list of tools with names, descriptions, and parameters), query (user query), answer (response, which can be a tool call, refusal, or clarification, including specific call content and text), and meta (metadata indicating the example source and specific category). The data consists of multiple slices: 1) Positive samples: real tool-calling examples from ToolACE (with schema validation) and a small set of execution-verified examples from deterministic tool environments. 2) Hard negative samples: include scenarios where calls should be refused, clarifications should be made for missing or ambiguous parameters, calls should be persisted (for satisfiable but vaguely expressed requests), and full calls should be made (handling partially parallel requests). 3) Multi-turn dialogues: cover parameter absence, function absence, long contexts, and verified multi-call environment trajectories. 4) Schema drift: simulates scenarios where tool schemas change during model usage, such as adding required parameters, modifying enumeration types, or renaming fields, requiring the model to respond correctly. All tool-call answers are schema-validated during construction to ensure zero schema-invalid answers. The dataset undergoes rigorous deduplication (MinHash + semantic) and decontamination (checking overlaps with public probes). Additionally, a platform-enhanced variant is provided, with rewritten prompts and completions to improve data quality. In terms of data sources, positive samples are derived and adapted from the Team-ACE/ToolACE dataset (Apache-2.0 license). All hard negative samples, multi-turn dialogues, and schema drift examples are original, synthesized via templates based on real tool schemas. The entire dataset is released under the Apache-2.0 license. The current version is English-only, and the phrasing of synthetic examples is template-based, with less diversity than fully natural queries.
数据集概述:AutoScientist Tool-Calling Dataset
基本信息
- 许可证: Apache-2.0
- 语言: 英语、西班牙语、法语、印地语
- 任务类型: 文本生成
- 标签: 函数调用、工具使用、智能体、硬负样本、AutoScientist
- 数据规模: 1K < n < 10K
数据分割
数据集包含四个分割:
- train (train.jsonl)
- validation (val.jsonl)
- test (test.jsonl)
- test_novel (test_novel.jsonl):包含训练中从未见过的工具示例,用于泛化测试
总样本量: 7,566 条(训练/验证/测试集共 7,323 条 + test_novel 243 条),覆盖 7,315 个独特工具。
数据格式
每条数据包含以下字段:
- tools: 工具列表(名称、描述、参数)
- query: 用户查询
- answer: 答案(类型为
tool_call/refuse/clarify,包含调用列表和文本内容) - meta: 元数据(来源、硬负样本种类、多轮对话种类、模式漂移种类、语言、文档格式、配对ID等)
数据切片与核心特征
正样本
- 来自 ToolACE 的真实工具调用示例(经过模式验证)
- 包含少量来自确定性工具环境的执行验证示例
硬负样本(~8.8% 占比,644条)
- no_tool → 应拒绝调用
- missing_arg / ambiguous → 应澄清
- over_refusal → 必须调用(对冲拒绝偏见的满足性请求)
- partial_parallel → 需要两次调用
多轮对话
- 缺失参数、缺失函数、长上下文(BFCL v3/v4 风格)
- 已验证的多调用环境轨迹(2–3个顺序无关的调用)
模式漂移
工具模式在模型使用过程中发生变化:
- 添加必填参数 / 重命名枚举 → 应澄清
- 重命名字段 → 映射到新字段
格式不变性孪生数据
同一示例的工具文档以 Python 签名 / XML / 紧凑列表形式渲染,答案相同,用于测试模型对工具文档格式的敏感性。
掩码孪生数据
采用 Hammer 风格的函数掩码:中性名称(func_i / arg_j)保留描述,调用名称一致性重命名,消除命名约定捷径。
故障恢复轨迹
脚本化的临时工具错误(503 / 429 / 超时 / 格式错误负载)中断步骤,黄金答案是重试相同调用。
质量保证
- 模式验证: 所有
tool_call黄金答案在构建时经过模式验证,零模式无效样本 - 去污染: 每个训练查询通过 n-gram 和嵌入检查与公开的 BFCL/ToolACE 测试集重叠,在
stats.json中记录污染情况 - 数据质量审计: 修复了拒绝/澄清样本在去重时被静默丢弃的问题,已进行回归测试
来源与许可
- 正样本源自 Team-ACE/ToolACE(Apache-2.0)
- 所有硬负样本、多轮对话和模式漂移示例均为原创,基于真实工具模式合成
- 全部在 Apache-2.0 下发布
预期用途
- 监督微调和偏好微调,训练函数调用模型可靠地决定是否以及如何调用工具,包括安全拒绝
局限性
- 主要为英语;多语言孪生切片约 175 条(西班牙语/法语/印地语/印地语罗马化)
- 合成硬负样本/多轮对话的措辞模板化,多样性有限
复现方法
bash python -m autoscientist_toolcaller.build_dataset --config config.yaml
代码仓库:https://github.com/ankit25bcs10610/adaption-ai-lab