
CentificAIResearch/MedMosaic
收藏官方服务:
资源简介:
该数据集包含与临床问题和答案配对的音频记录,涵盖多种问答类型。它旨在为医疗推理任务中的音频-语言模型提供基准测试。
This dataset contains audio recordings paired with clinical questions and answers across multiple QA types. It is designed to benchmark audio-language models on medical reasoning tasks.
提供机构:
CentificAIResearch搜集汇总
数据集介绍
构建方式
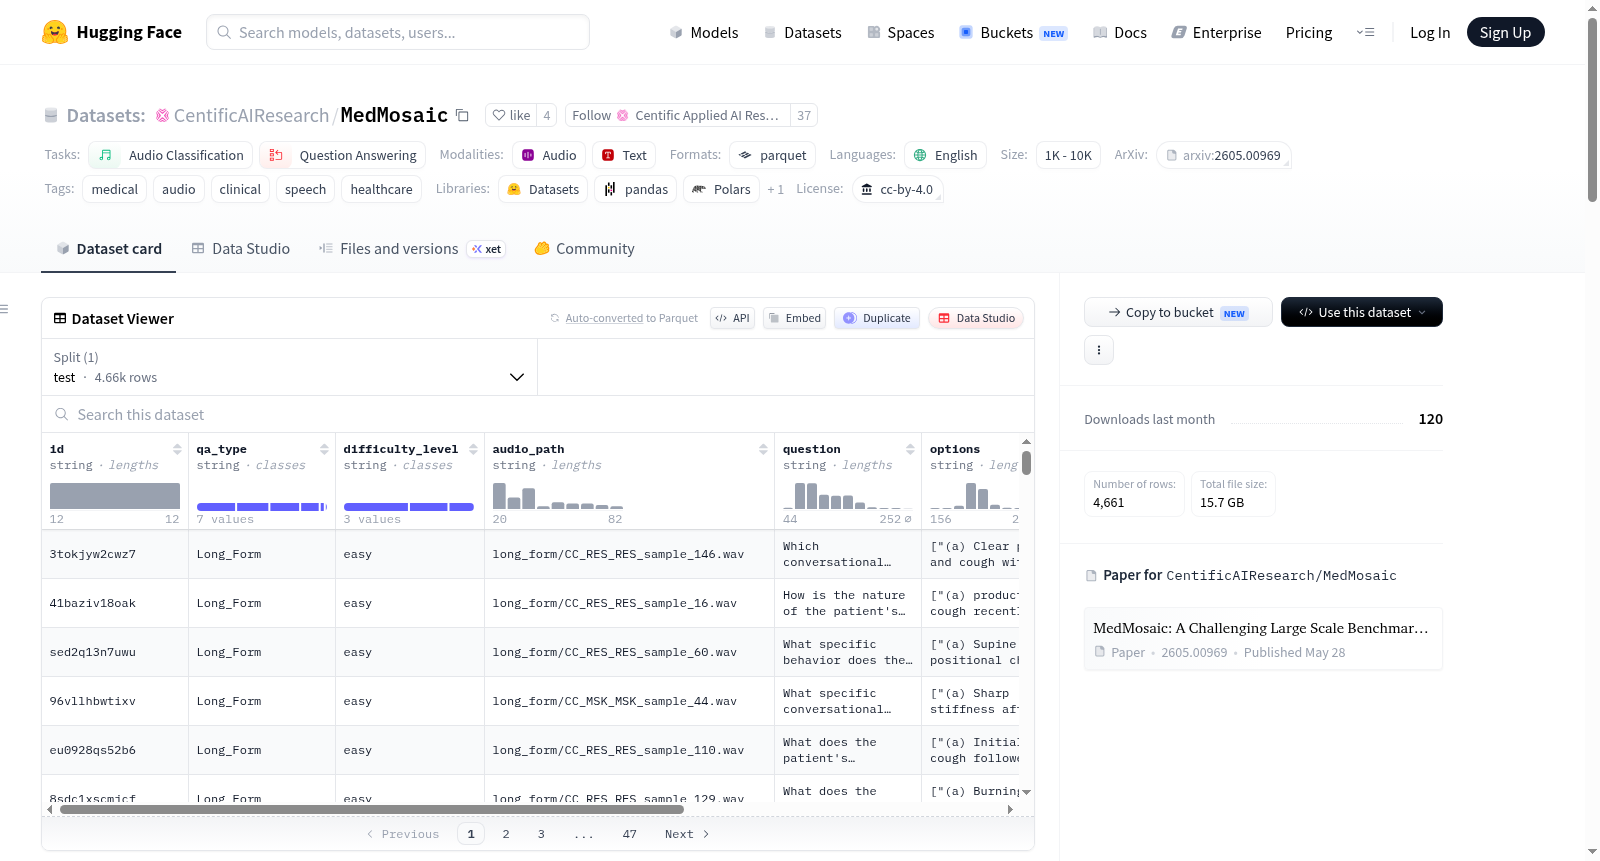
MedMosaic数据集由多个子文件夹构成,每个子文件夹对应一种问答类型,包括长格式、多轮、开放式、纯声音、纯语音、语音与声音混合以及语音问答七类。每个子文件夹内包含与临床场景相关的音频文件(.wav)及对应的元数据JSON文件,元数据中记录了唯一标识、音频路径、问答类型、难度等级、问题文本、选项及正确答案。开放式问答无选项,采用自由文本形式的正确答案;多轮问答则包含嵌套的轮次数组,每轮带有独立的问题、选项和答案。整个数据集共收录4,661条样本,以测试集形式提供,并采用Parquet格式存储。
特点
该数据集特色在于其多模态融合与临床场景的高度适配性。它不仅覆盖了从纯声音到纯语音、再到语音与声音混合等多种听觉模式,还设计了开放式、多轮对话及标准多项选择等多样化问答类型,全面考验模型在复杂医疗语境下的理解与推理能力。难度等级从简单到困难分层标注,为不同阶段的模型评估提供了精细化的门槛。数据集规模虽不大(4,661条),却涵盖了7种细分任务,兼具广度与深度,是医疗音频问答领域少有的综合性评测基准。
使用方法
使用MedMosaic数据集时,可从HuggingFace平台直接加载Parquet格式的数据文件,利用Python的pandas或datasets库读取id、qa_type、difficulty_level、audio_path、question、options、ground_truth、turns及num_turns等字段。对于标准问答类型,可依据options字段构建多项选择任务,通过对比预测与ground_truth计算准确率;开放式问答则需采用文本生成评估指标如ROUGE或BERTScore进行语义匹配;多轮问答需按turns数组顺序逐轮推理。音频路径字段指向本地或云端的WAV文件,需配合音频处理库解码加载,最终用于训练或评估音频语言模型的医疗推理能力。
背景与挑战
背景概述
MedMosaic数据集由CentificAI Research机构于2026年创建,专注于医学音频问答领域,旨在评估音频理解模型在临床与医疗场景中的表现。该数据集包含4661条录音,覆盖七种问答类型(如长形式、多轮对话、开放性问答等),并配有难度分级,为多模态医学推理研究提供了标准化的基准。其影响力体现在填补了医学音频与语言模型交叉领域的空白,推动智能辅助诊断与临床决策系统的进展。
当前挑战
该数据集面临的核心挑战包括:领域问题层面,医学音频问答需处理多类型声学信号(如语音、身体音、环境声)与复杂临床知识的整合,远超传统音频分类任务;构建过程中,需确保问答对的专业性与多样性,同时标注一致性面临高成本与专家依赖的难题。此外,音频数据的私密性与伦理合规性也构成数据收集与发布的重大障碍。
常用场景
经典使用场景
MedMosaic数据集凭借其多维度的音频问答结构,成为评估医学音频理解模型的标杆。该数据集覆盖长形式、多轮对话、开放式提问、纯声音、纯语音、语音+声音以及语音问答七类场景,共收录4661条录音样本。每条样本均标注了难度级别、临床问题、选项及标准答案,并包含对应的音频文件路径,为研究者提供了从单一音频理解到多模态推理的完整测试框架。经典用法聚焦于利用这些多样化的QA类型,系统性地检验模型在临床语境下的听觉感知、语义解析及医学知识调用能力,尤其适用于对比不同架构的音频语言模型在多个任务维度上的表现差异。
衍生相关工作
自发布以来,MedMosaic已衍生了多个具有代表性的研究工作。一方面,基于其混合QA类型的评估框架,研究者提出了跨模态注意力增强的音频语言模型,例如在arXiv预印本2605.00969中构建的MedAudio-Bench基线,系统比较了Whisper、HuBERT等架构在医学推理任务上的瓶颈。另一方面,该数据集推动了临床音频合成与增强方向的发展,衍生出用于低资源场景下的数据扩充方法,如基于扩散模型的病理声音生成技术,以缓解医学音频标注稀缺的困境。此外,多轮对话子集直接启发了对话式医学知识图谱的构建研究,将结构化的问答对与外部医学本体库链接,形成了初步的可解释医疗语音助手框架,彰显了该数据集在连接声学感知与临床知识推理中的枢纽作用。
数据集最近研究
最新研究方向
MedMosaic数据集作为首个大规模融合医学音频与问答的基准资源,正引领多模态医疗推理的前沿探索。其设计紧扣临床语音与声学信号的复杂场景,涵盖长对话、多轮交互及开放问答等任务,为评估音频语言模型在真实医疗环境中的理解能力提供了系统化框架。近期研究热点围绕利用该数据集推动医学领域的语音诊断、远程问诊及听觉辅助决策,尤其关注模型对病理声学特征(如呼吸音、心音)与专业术语问答的跨模态对齐能力。此资源不仅填补了医疗音频语义理解的数据空白,更通过难度分层与多样化问答类型,促进了从基础声学分类到高阶临床推理的渐进式评估,对智能医疗助手与可解释性AI在听诊、急诊等场景的落地具有里程碑意义。
以上内容由遇见数据集搜集并总结生成


